Basi di Natural Language Processing (NLP)

Natural Language Processing con spaCy

Azadeh Mobasher

Principal Data Scientist

Natural Language Processing (NLP)
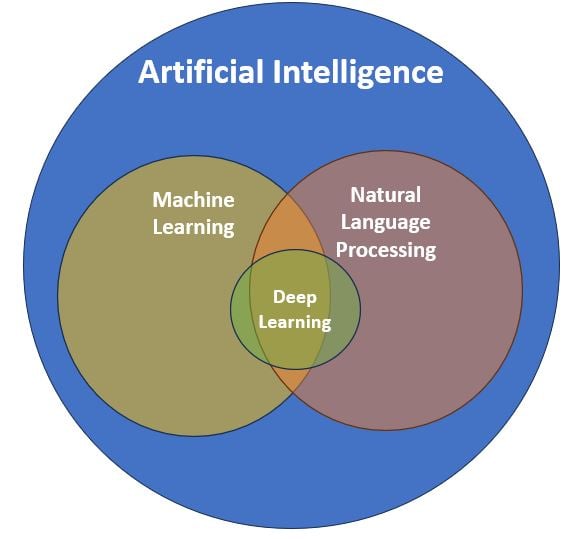
 

  • Un sottoinsieme dell'Intelligenza Artificiale (AI)
  • Aiuta i computer a capire il linguaggio umano
  • Aiuta a estrarre insight da dati non strutturati
  • Integra statistica, modelli di machine learning e modelli di deep learning


NLP, un sottoinsieme dell'AI

Natural Language Processing con spaCy

Casi d'uso NLP

Analisi del sentiment  

  • Uso dei computer per determinare il tono soggettivo di un testo
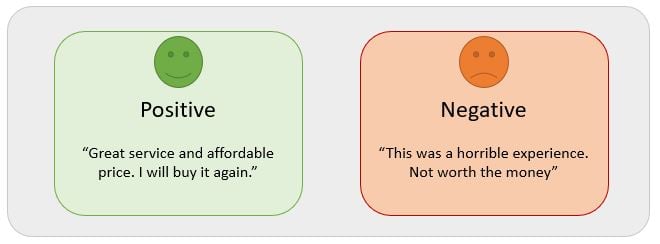
 

Esempi di analisi del sentiment

Natural Language Processing con spaCy

Casi d'uso NLP

Named entity recognition (NER)  

  • Individuare e classificare le entità nominate nel testo non strutturato in categorie predefinite
  • Le entità nominate sono oggetti reali come persone o luoghi
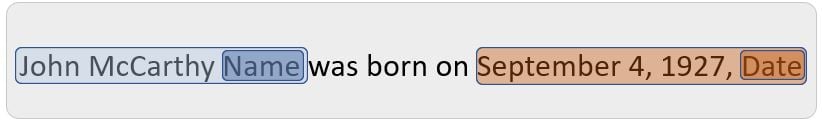
 

Esempi di NER

Natural Language Processing con spaCy

Casi d'uso NLP


  • Generare risposte simili a quelle umane a input testuali, come ChatGPT
 

Chatbot

Natural Language Processing con spaCy

Introduzione a spaCy

spaCy è una libreria gratuita e open-source per l'NLP in Python che:

  • È pensata per creare sistemi di estrazione di informazioni
  • Fornisce codice pronto per la produzione per casi d'uso NLP
  • Supporta 64+ lingue
  • È robusta e veloce e ha librerie di visualizzazione


spaCy e NLP

Natural Language Processing con spaCy

Installa e importa spaCy


  • Per iniziare, puoi installare spaCy con il gestore pacchetti Python pip
  • Puoi scaricare i modelli addestrati di spaCy
  • Sono disponibili più modelli addestrati per l'inglese su spacy.io


$ python3 pip install spacy
python3 -m spacy download en_core_web_sm
import spacy
nlp = spacy.load("en_core_web_sm")
Natural Language Processing con spaCy

Leggi ed elabora testo con spaCy

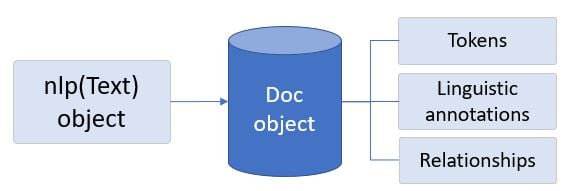
  • Caricato il modello spaCy en_core_web_sm = oggetto nlp
  • L'oggetto nlp converte il testo in un oggetto Doc (contenitore) per il testo processato

Elaborazione del testo con spaCy

Natural Language Processing con spaCy

spaCy in pratica

  • Elaborazione di una stringa con spaCy
import spacy
nlp = spacy.load("en_core_web_sm")
text = "A spaCy pipeline object is created."
doc = nlp(text)
  • Tokenizzazione
    • Un Token è la parte più piccola e significativa del testo.
    • Tokenizzazione: processo di suddivisione del testo in una lista di token significativi
print([token.text for token in doc])
['A', 'spaCy', 'pipeline', 'object', 'is', 'created', '.']
Natural Language Processing con spaCy

Esercitiamoci!

Natural Language Processing con spaCy

Preparing Video For Download...