TfIdf: Altri modi per trasformare il testo

Sentiment Analysis con Python

Violeta Misheva

Data Scientist

Quali sono i componenti di TfIdf?

  • TF: frequenza del termine: Quante volte una parola appare in un documento del corpus

  • IDF: frequenza inversa dei documenti: Rapporto logaritmico tra il numero totale di documenti e quelli che contengono una certa parola

    • Serve a pesare le parole che compaiono di rado
Sentiment Analysis con Python

Punteggio TfIdf di una parola

  • Punteggio TfIdf:
TfIdf = term frequency * inverse document frequency
  • BOW non considera la lunghezza del documento, TfIdf sì.
  • TfIdf cattura parole comuni in un documento ma non tra documenti.
Sentiment Analysis con Python

A cosa serve TfIdf?

Sentiment sulle compagnie aeree su Twitter
  • TfIdf basso: United, Virgin America
  • TfIdf alto: check-in process (se raro tra i documenti)
Altre note su TfIdf
  • Poiché penalizza le parole frequenti, serve meno gestire esplicitamente le stop word.
  • Molto utile in ricerche e information retrieval per ordinare i risultati per rilevanza.
Sentiment Analysis con Python

TfIdf in Python

# Import the TfidfVectorizer
from sklearn.feature_extraction.text import TfidfVectorizer
  • Argomenti di TfidfVectorizer: max_features, ngram_range, stop_words, token_pattern, max_df, min_df
vect = TfidfVectorizer(max_features=100).fit(tweets.text)
X = vect.transform(tweets.text)
Sentiment Analysis con Python

TfidfVectorizer

X
<14640x100 sparse matrix of type '<class 'numpy.float64'>'
    with 119182 stored elements in Compressed Sparse Row format>
X_df = pd.DataFrame(X_txt.toarray(), columns=vect.get_feature_names())
X_df.head()
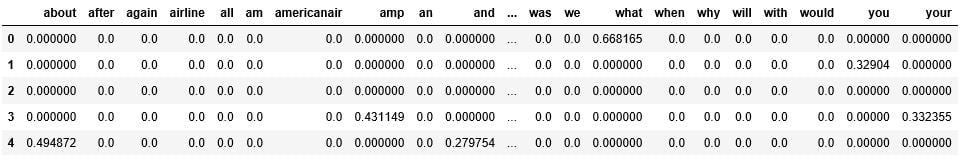
prime 5 righe di dati creati con TfIdf

Sentiment Analysis con Python

Esercitiamoci!

Sentiment Analysis con Python

Preparing Video For Download...