Convinzione iniziale

Analisi dei dati bayesiana in Python

Michal Oleszak

Machine Learning Engineer

Distribuzione a priori

  • La distribuzione a priori riflette ciò che sappiamo sul parametro prima di osservare dati:
    • niente   →   distribuzione uniforme (tutti i valori ugualmente probabili)
    • vecchia posteriore   →   aggiornabile con nuovi dati


  • Puoi scegliere qualsiasi distribuzione come prior per includere info esterne nel modello:
    • parere di esperti
    • conoscenza comune
    • ricerche precedenti
    • convinzione soggettiva
Analisi dei dati bayesiana in Python

Impatto della prior

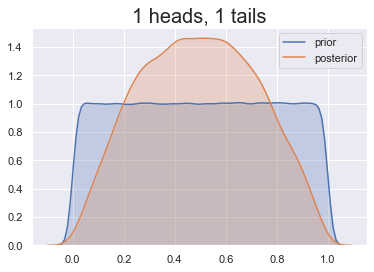
Due grafici di densità sovrapposti: uno per la prior, l'altro per la posteriore. La prior è uniforme, la posteriore è a campana, leggermente più alta.

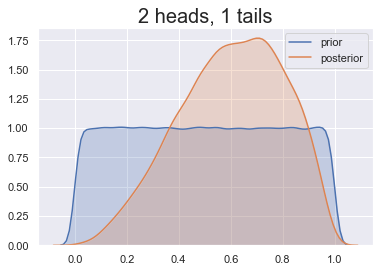
Due grafici di densità sovrapposti: uno per la prior, l'altro per la posteriore. La prior è uniforme, la posteriore è a campana, un po' più alta e asimmetrica a destra.

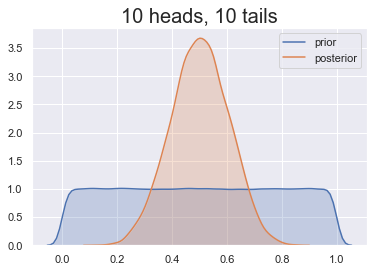
Due grafici di densità sovrapposti: uno per la prior, l'altro per la posteriore. La prior è uniforme, la posteriore è a campana, molto più alta.

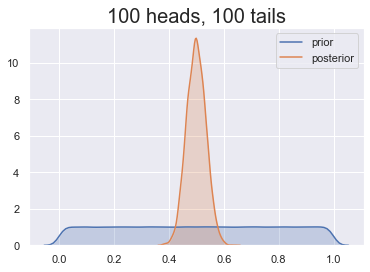
Due grafici di densità sovrapposti: uno per la prior, l'altro per la posteriore. La prior è uniforme, la posteriore è a campana, altissima.

Analisi dei dati bayesiana in Python

Distribuzione a priori

  • La prior si sceglie prima di vedere i dati.
  • La scelta della prior può influenzare la posteriore (soprattutto con pochi dati).
  • Per evitare cherry-picking, le scelte di prior dovrebbero essere:
    • dichiarate chiaramente,
    • spiegabili: basate su ricerche precedenti, assunzioni sensate, pareri esperti, ecc.
Analisi dei dati bayesiana in Python

Scegliere la prior giusta

La nostra convinzione iniziale: testa meno probabile
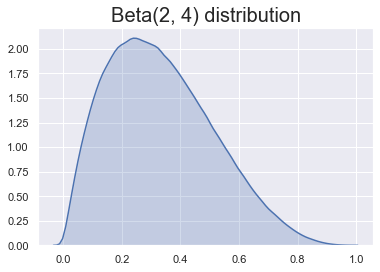
Un grafico di densità a campana ma asimmetrico a sinistra, con picco intorno a 0,25.

Alcune scelte sono migliori di altre!
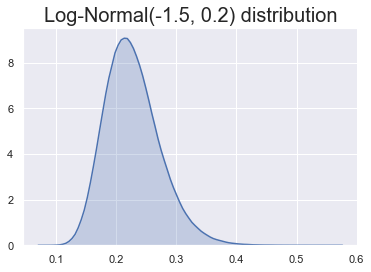
 

Un grafico di densità a campana ma asimmetrico a sinistra, con picco intorno a 0,25, leggermente più stretto del precedente.

Analisi dei dati bayesiana in Python

Prior coniugate

  • Alcune prior, moltiplicate per specifiche verosimiglianze, producono posteriori note.
  • Sono dette prior coniugate.
  • Nel caso del lancio di monete:
    • se scegli una prior Beta(a, b),
    • allora la posteriore è Beta(#testa + a, #lanci - #testa + b)
  • Possiamo campionare dalla posteriore con numpy.
  • get_heads_prob() dal Capitolo 1:
    def get_heads_prob(tosses):
      num_heads = np.sum(tosses)
      # prior: Beta(1,1)
      return np.random.beta(num_heads + 1, len(tosses) - num_heads + 1, 1000)
    
Analisi dei dati bayesiana in Python

Due modi per ottenere la posteriore

Simulazione

  • Se la posteriore è nota, possiamo campionare con numpy:
    draws = np.random.beta(2, 4, 1000)
    
  • Risultato: un array di 1000 campioni posteriori:
    array([0.05941031, ..., 0.70015975])
    
  • Si può tracciare con
    sns.kdeplot(draws)
    

Calcolo

  • Se la posteriore non è nota, possiamo calcolarla con l'approssimazione a griglia.
  • Risultato: probabilità a posteriori per ogni elemento della griglia:
           head_prob  posterior_prob
    0           0.00        0.009901
    1           0.01        0.003624
               ...           ...
    10199       0.99        0.003624
    10200       1.00        0.009901
    
  • Si può tracciare con
    sns.lineplot(df["head_prob"], df["posterior_prob"])
    
Analisi dei dati bayesiana in Python

Esercitiamoci a lavorare con le prior!

Analisi dei dati bayesiana in Python

Preparing Video For Download...