Stima parametrica

Gestione quantitativa del rischio in Python

Jamsheed Shorish

Computational Economist

Una classe di distribuzioni

  • Distribuzione delle perdite: non nota con certezza
  • Classe di possibili distribuzioni?
    • Supponi una classe di distribuzioni $f(x; \theta)$
    • $x$ è la perdita (variabile casuale)
    • $\theta$ è un vettore di parametri ignoti
  • Esempio: distribuzione Normale
    • Parametri: $\theta = (\mu, \sigma)$, media $\mu$ e deviazione standard $\sigma$
  • Stima parametrica: trova il 'miglior' $\theta^\star$ dati i dati
  • Distribuzione delle perdite: $f(x,\theta^\star)$
Gestione quantitativa del rischio in Python

Adattare una distribuzione

  • Adatta una distribuzione minimizzando l'errore
    • Esempio: scipy.stats.norm.fit(), adatta una Normale ai dati
      • Risultato: media e deviazione standard stimate in modo ottimale
  • Vantaggi:
    • Puoi visualizzare la differenza tra dati e stima con un istogramma
    • Puoi eseguire test di goodness-of-fit
Gestione quantitativa del rischio in Python

Goodness of fit

  • Quanto bene la distribuzione stimata si adatta ai dati?
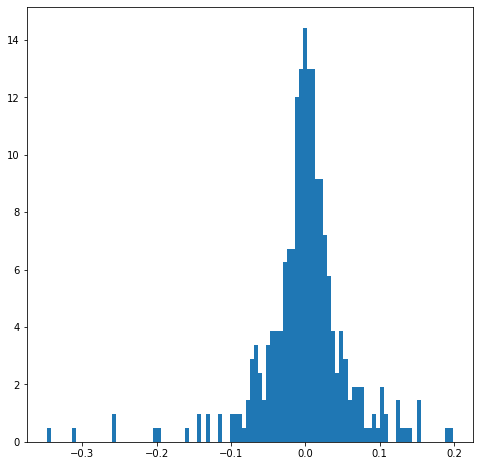
  • Visualizza: traccia l'istogramma delle perdite di portafoglio

immagine istogramma delle perdite

Gestione quantitativa del rischio in Python

Goodness of fit

  • Quanto bene la distribuzione stimata si adatta ai dati?
  • Visualizza: traccia l'istogramma delle perdite di portafoglio
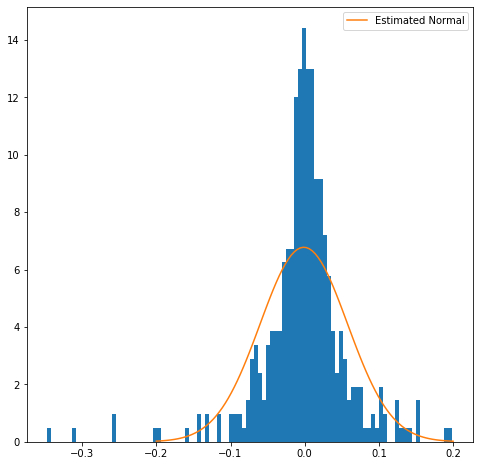
  • Distribuzione Normale con norm.fit()

istogramma delle perdite con distribuzione normale

Gestione quantitativa del rischio in Python

Goodness of fit

  • Quanto bene la distribuzione stimata si adatta ai dati?
  • Visualizza: traccia l'istogramma delle perdite di portafoglio
  • Esempio:
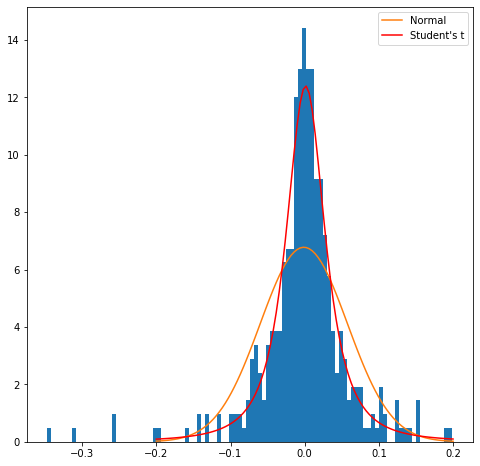
    • Distribuzione Normale con norm.fit()
    • Distribuzione t di Student con t.fit()
    • Istogramma asimmetrico?

istogramma delle perdite con distribuzione normale

Gestione quantitativa del rischio in Python

Test di Anderson-Darling

  • Test statistico di goodness of fit
    • Ipotesi nulla: i dati sono Normalmente distribuiti
    • La statistica rifiuta la Normale se maggiore di critical_values
  • Importa scipy.stats.anderson
  • Calcola il risultato del test sui dati loss
from scipy.stats import anderson

anderson(loss)
AndersonResult(statistic=11.048641503898523,
critical_values=array([0.57 , 0.649, 0.779, 0.909, 1.081]),
significance_level=array([15. , 10. ,  5. ,  2.5,  1. ]))
Gestione quantitativa del rischio in Python

Skewness

  • Asimmetria (skewness): quanto i dati si discostano dalla simmetria
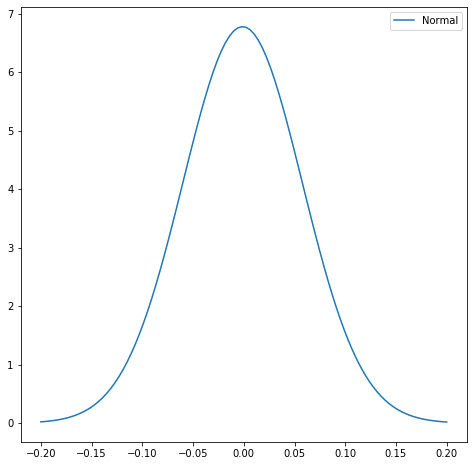
    • Distribuzione Normale: simmetrica

distribuzione normale

Gestione quantitativa del rischio in Python

Skewness

  • Asimmetria (skewness): quanto i dati si discostano dalla simmetria
    • Distribuzione Normale: simmetrica
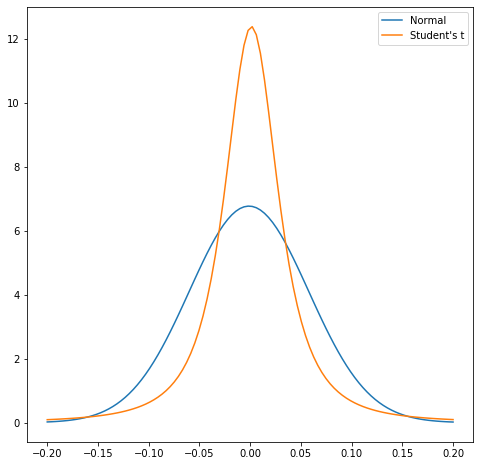
    • Distribuzione t di Student: simmetrica

distribuzioni normale e t

Gestione quantitativa del rischio in Python

Skewness

  • Asimmetria (skewness): quanto i dati si discostano dalla simmetria
    • Distribuzione Normale: simmetrica
    • Distribuzione t di Student: simmetrica
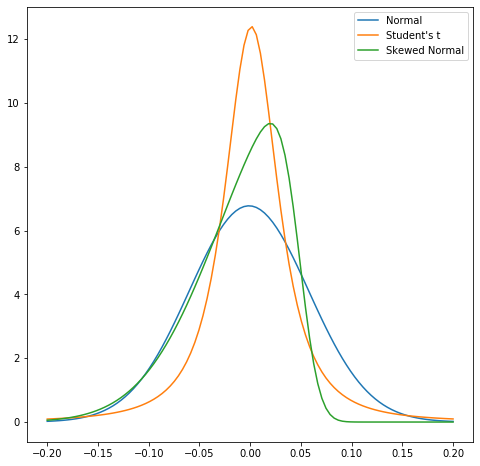
  • Distribuzione Skewed Normal: asimmetrica
    • Include la Normale come caso particolare
    • Utile per dati di portafoglio, es. perdite più frequenti dei guadagni
    • Disponibile in scipy.stats come skewnorm

distribuzioni normale, t e skewed normal

Gestione quantitativa del rischio in Python

Test per l'asimmetria

  • Verifica la distanza dalla simmetria: scipy.stats.skewtest
  • Ipotesi nulla: nessuna asimmetria
  • Importa skewtest da scipy.stats
  • Calcola il risultato del test sui dati loss
    • Se significativo ⇒ usa una classe di distribuzioni con asimmetria
from scipy.stats import skewtest

skewtest(loss)
SkewtestResult(statistic=-7.786120875514511,
pvalue=6.90978472959861e-15)
Gestione quantitativa del rischio in Python

Esercitiamoci!

Gestione quantitativa del rischio in Python

Preparing Video For Download...