Introduzione agli RDD di PySpark

Fondamenti di Big Data con PySpark

Upendra Devisetty

Science Analyst, CyVerse

Che cos'è un RDD?

  • RDD = Resilient Distributed Datasets

rdd

Fondamenti di Big Data con PySpark

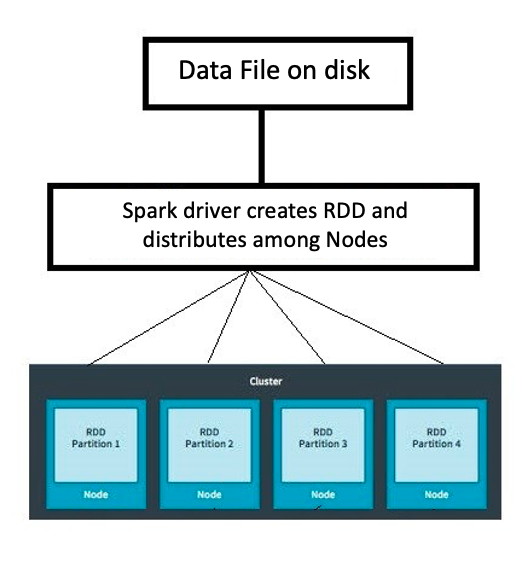
Scomporre gli RDD

  • Resilient Distributed Datasets

    • Resilient: capacità di resistere ai guasti

    • Distributed: su più macchine

    • Datasets: raccolta di dati partizionati, ad es. array, tabelle, tuple ecc.

Fondamenti di Big Data con PySpark

Creare RDD. Come fare?

  • Parallelizzare una raccolta esistente di oggetti

  • Dati esterni:

    • File in HDFS

    • Oggetti in bucket Amazon S3

    • righe in un file di testo

  • Da RDD esistenti

Fondamenti di Big Data con PySpark

Collezione parallelizzata (parallelizing)

  • parallelize() per creare RDD da liste Python
numRDD = sc.parallelize([1,2,3,4])
helloRDD = sc.parallelize("Hello world")
type(helloRDD)
<class 'pyspark.rdd.PipelinedRDD'>
Fondamenti di Big Data con PySpark

Da dati esterni

  • textFile() per creare RDD da dati esterni
fileRDD = sc.textFile("README.md")
type(fileRDD)
<class 'pyspark.rdd.PipelinedRDD'>
Fondamenti di Big Data con PySpark

Capire il partizionamento in PySpark

  • Una partizione è una divisione logica di un grande set di dati distribuito

  • Metodo parallelize()

numRDD = sc.parallelize(range(10), minPartitions = 6)
  • Metodo textFile()
fileRDD = sc.textFile("README.md", minPartitions = 6)
  • Il numero di partizioni in un RDD si ottiene con il metodo getNumPartitions()
Fondamenti di Big Data con PySpark

Esercitiamoci!

Fondamenti di Big Data con PySpark

Preparing Video For Download...