Classificazione

Fondamenti di Big Data con PySpark

Upendra Devisetty

Science Analyst, CyVerse

Classificazione con PySpark MLlib

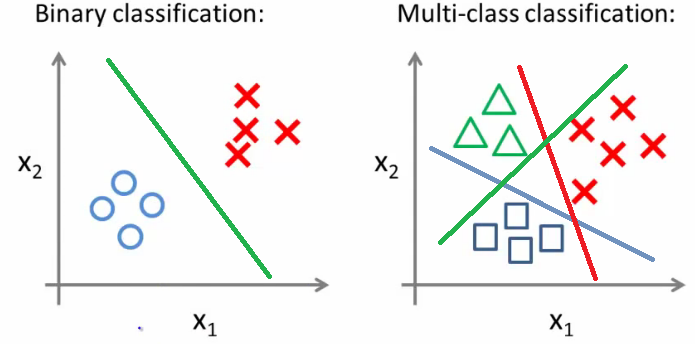
  • La classificazione è un algoritmo supervisionato di Machine Learning che assegna i dati di input a categorie diverse
Fondamenti di Big Data con PySpark

Introduzione alla regressione logistica

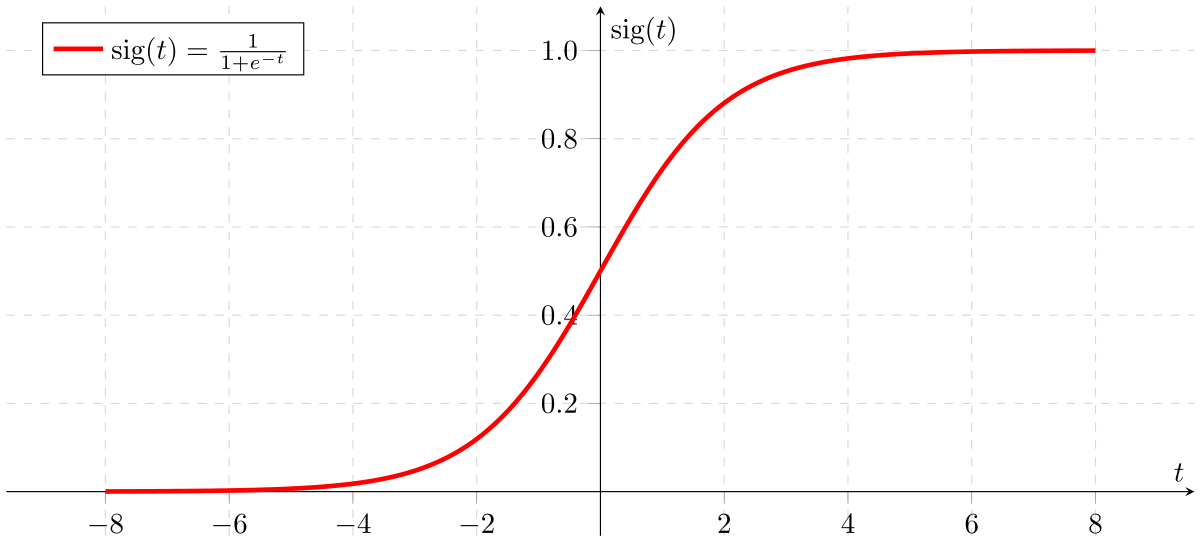
  • La regressione logistica predice una risposta binaria in base ad alcune variabili
Fondamenti di Big Data con PySpark

Lavorare con i Vectors

  • PySpark MLlib include tipi di dato specifici: Vectors e LabelledPoint

  • Due tipi di Vectors

    • Dense Vector: memorizza tutte le voci in un array di numeri in virgola mobile
    • Sparse Vector: memorizza solo i valori non zero e i loro indici
denseVec = Vectors.dense([1.0, 2.0, 3.0])
DenseVector([1.0, 2.0, 3.0])
sparseVec = Vectors.sparse(4, {1: 1.0, 3: 5.5})
SparseVector(4, {1: 1.0, 3: 5.5})
Fondamenti di Big Data con PySpark

LabeledPoint() in PySpark MLlib

  • Un LabeledPoint incapsula le feature di input e il valore previsto

  • Nella classificazione binaria della regressione logistica, l'etichetta è 0 (negativa) o 1 (positiva)

positive = LabeledPoint(1.0, [1.0, 0.0, 3.0])
negative = LabeledPoint(0.0, [2.0, 1.0, 1.0])
print(positive)
print(negative)
LabeledPoint(1.0, [1.0,0.0,3.0])
LabeledPoint(0.0, [2.0,1.0,1.0])
Fondamenti di Big Data con PySpark

HashingTF() in PySpark MLlib

  • L'algoritmo HashingTF() mappa i valori delle feature agli indici nel vettore delle feature
from pyspark.mllib.feature import HashingTF
sentence = "hello hello world"
words = sentence.split()
tf = HashingTF(10000) 
tf.transform(words)
SparseVector(10000, {3065: 1.0, 6861: 2.0})
Fondamenti di Big Data con PySpark

Regressione logistica con LogisticRegressionWithLBFGS

  • In PySpark MLlib, la regressione logistica si esegue con la classe LogisticRegressionWithLBFGS
data = [
        LabeledPoint(0.0, [0.0, 1.0]),
        LabeledPoint(1.0, [1.0, 0.0]),
]
RDD = sc.parallelize(data)
lrm = LogisticRegressionWithLBFGS.train(RDD)
lrm.predict([1.0, 0.0])
lrm.predict([0.0, 1.0])
1
0
Fondamenti di Big Data con PySpark

Diapositiva finale

Fondamenti di Big Data con PySpark

Preparing Video For Download...