Big data è un termine usato per lo studio e le applicazioni di insiemi di dati troppo complessi per il software tradizionale di elaborazione dati - Wikipedia
Le 3 V dei Big Data
Volume, Varietà e Velocità
Volume: Dimensione dei dati
Varietà: Fonti e formati diversi
Velocità: Rapidità dei dati
Concetti e terminologia dei Big Data
Cluster computing: Raccolta di risorse di più macchine
Parallel computing: Calcolo simultaneo su un singolo computer
Distributed computing: Insieme di nodi (computer in rete) che operano in parallelo
Batch processing: Scomporre il job in parti e eseguirle su macchine separate
Real-time processing: Elaborazione immediata dei dati
Sistemi di elaborazione Big Data
Hadoop/MapReduce: Framework scalabile e tollerante ai guasti scritto in Java
Open source
Batch processing
Apache Spark: Sistema di cluster computing generico e velocissimo
Open source
Sia batch sia real-time data processing
Nota: Oggi Apache Spark è preferito a Hadoop/MapReduce
Funzionalità del framework Apache Spark
Framework distribuito di cluster computing
Computazioni in-memory efficienti per grandi insiemi di dati
Framework di elaborazione dati rapidissimo
Supporta Java, Scala, Python, R e SQL
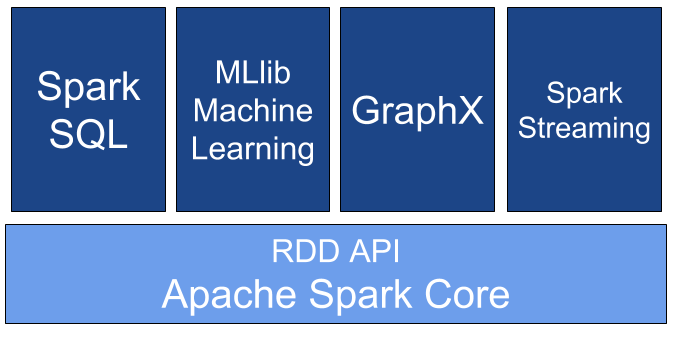
Componenti di Apache Spark
Modalità di deployment di Spark
Modalità locale: Una singola macchina, ad esempio il tuo laptop
Comoda per test, debug e demo
Modalità cluster: Un insieme di macchine predefinite