Caricamento

Introduzione al Data Engineering

Vincent Vankrunkelsven

Data Engineer, DataCamp

Database per analytics o applicazioni

Analytics

Icona che rappresenta l'analytics

  • Query di aggregazione
  • Online analytical processing (OLAP)

Applicazioni
Icona che rappresenta le applicazioni

  • Molte transazioni
  • Online transaction processing (OLTP)
Introduzione al Data Engineering

Orientati a colonne e a righe

Analytics

  • Orientati alle colonne

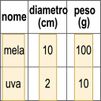
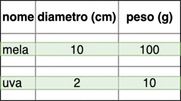
Esempio di archiviazione orientata alle colonne

  • Query su sottoinsiemi di colonne
  • Parallelizzazione

Applicazioni

  • Orientati alle righe

Esempio di archiviazione orientata alle righe

  • Archiviati per record
  • Aggiunti per transazione
  • Es.: aggiungere un cliente è veloce
Introduzione al Data Engineering

Database MPP

Database Massively Parallel Processing
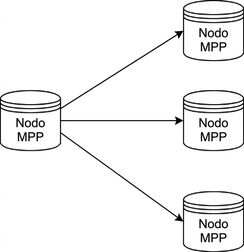
Diagramma di un database MPP


  • Amazon Redshift
  • Azure SQL Data Warehouse
  • Google BigQuery
Introduzione al Data Engineering

Un esempio: Redshift

Carica da file in formato di archiviazione colonnare

# Metodo Pandas .to_parquet()
df.to_parquet("s3://path/to/bucket/customer.parquet")
# Metodo PySpark .write.parquet()
df.write.parquet("s3://path/to/bucket/customer.parquet")
COPY customer
FROM 's3://path/to/bucket/customer.parquet'
FORMAT as parquet
...
Introduzione al Data Engineering

Caricare su PostgreSQL

pandas.to_sql()

# Trasformazione dei dati
recommendations = transform_find_recommendatins(ratings_df)

# Carica nel database PostgreSQL
recommendations.to_sql("recommendations",
                       db_engine,
                       schema="store",
                       if_exists="replace")
Introduzione al Data Engineering

Esercitiamoci!

Introduzione al Data Engineering

Preparing Video For Download...