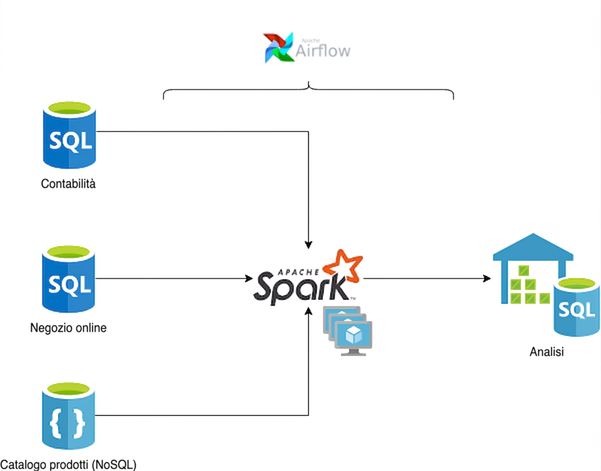
Strumenti del data engineer
Introduzione al Data Engineering

Vincent Vankrunkelsven
Data Engineer, DataCamp
Database
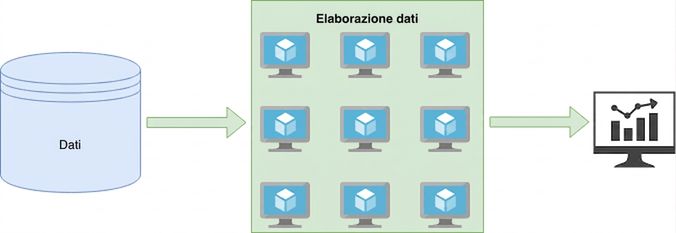
Elaborazione
Scheduling
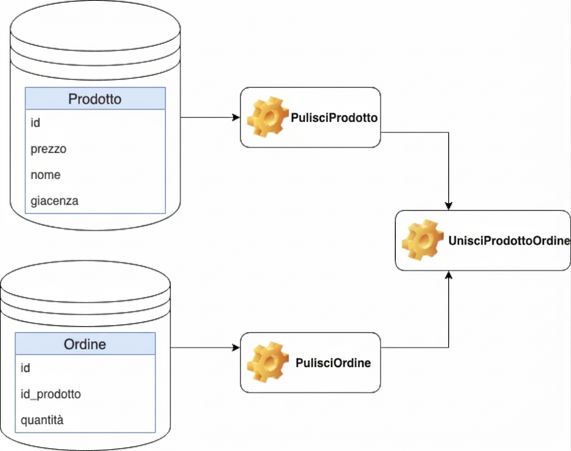
JoinProductOrder deve essere eseguito dopo CleanProduct e CleanOrder
Strumenti esistenti
Database
Elaborazione
Scheduling
Una data pipeline