Framework per il calcolo parallelo

Introduzione al Data Engineering

Vincent Vankrunkelsven

Data Engineer, DataCamp


Logo di Apache Hadoop

Introduzione al Data Engineering

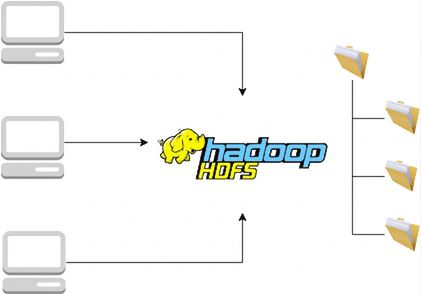
HDFS


Schema di HDFS come file system distribuito

Introduzione al Data Engineering

MapReduce


Logo di Hadoop MapReduce


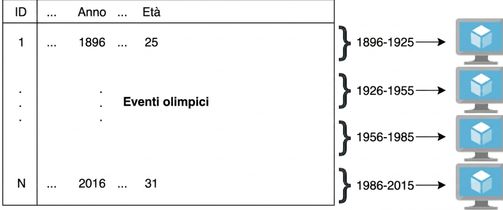
Schema che illustra l'esempio delle Olimpiadi

Introduzione al Data Engineering

Hive


  • Funziona su Hadoop
  • Structured Query Language: Hive SQL
  • Inizialmente MapReduce, ora anche altri strumenti

Logo di Apache Hive

Introduzione al Data Engineering

Hive: un esempio


SELECT year, AVG(age)
FROM views.athlete_events
GROUP BY year


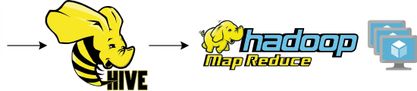
Schema da Hive a MapReduce

Introduzione al Data Engineering

Immagine del logo Spark

  • Evita scritture su disco
  • Mantenuto da Apache Software Foundation
Introduzione al Data Engineering

Resilient Distributed Datasets (RDD)


  • Spark si basa su di essi
  • Simili a una lista di tuple
  • Trasformazioni: .map() o .filter()
  • Azioni: .count() o .first()
Introduzione al Data Engineering

PySpark


  • Interfaccia Python per Spark
  • Astrazione DataFrame
  • Molto simile a Pandas
Introduzione al Data Engineering

PySpark: un esempio

# Carica prima l'insieme di dati in athlete_events_spark

(athlete_events_spark
  .groupBy('Year')
  .mean('Age')
  .show())
SELECT year, AVG(age)
FROM views.athlete_events
GROUP BY year
Introduzione al Data Engineering

Esercitiamoci!

Introduzione al Data Engineering

Preparing Video For Download...