Che cos'è il calcolo parallelo

Introduzione al Data Engineering

Vincent Vankrunkelsven

Data Engineer, DataCamp

L'idea alla base del calcolo parallelo
Base degli strumenti moderni di elaborazione dati

  • Memoria
  • Potenza di calcolo

Idea

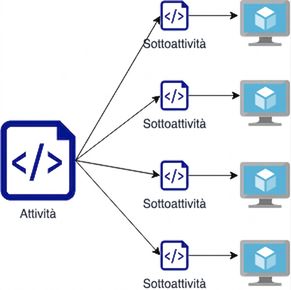
  • Dividere il compito in sottoattività
  • Distribuire le sottoattività su più computer
  • Collaborare per completare il compito

Diagramma: il compito viene diviso in sottoattività

Introduzione al Data Engineering

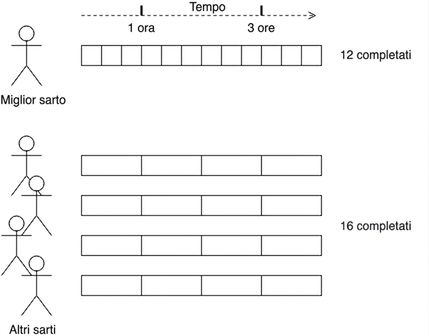
La sartoria

Diagramma che rappresenta la sartoria

Gestire una sartoria

Obiettivo: 100 camicie

  • Il miglior sarto finisce una camicia / 20 minuti
  • Gli altri sarti: una camicia / 1 ora


Più sarti insieme > miglior sarto da solo

Introduzione al Data Engineering

Vantaggi del calcolo parallelo

  • Potenza di calcolo
  • Memoria: partizionare l'insieme di dati


Chip di memoria RAM: Immagine di un chip di memoria RAM

Introduzione al Data Engineering

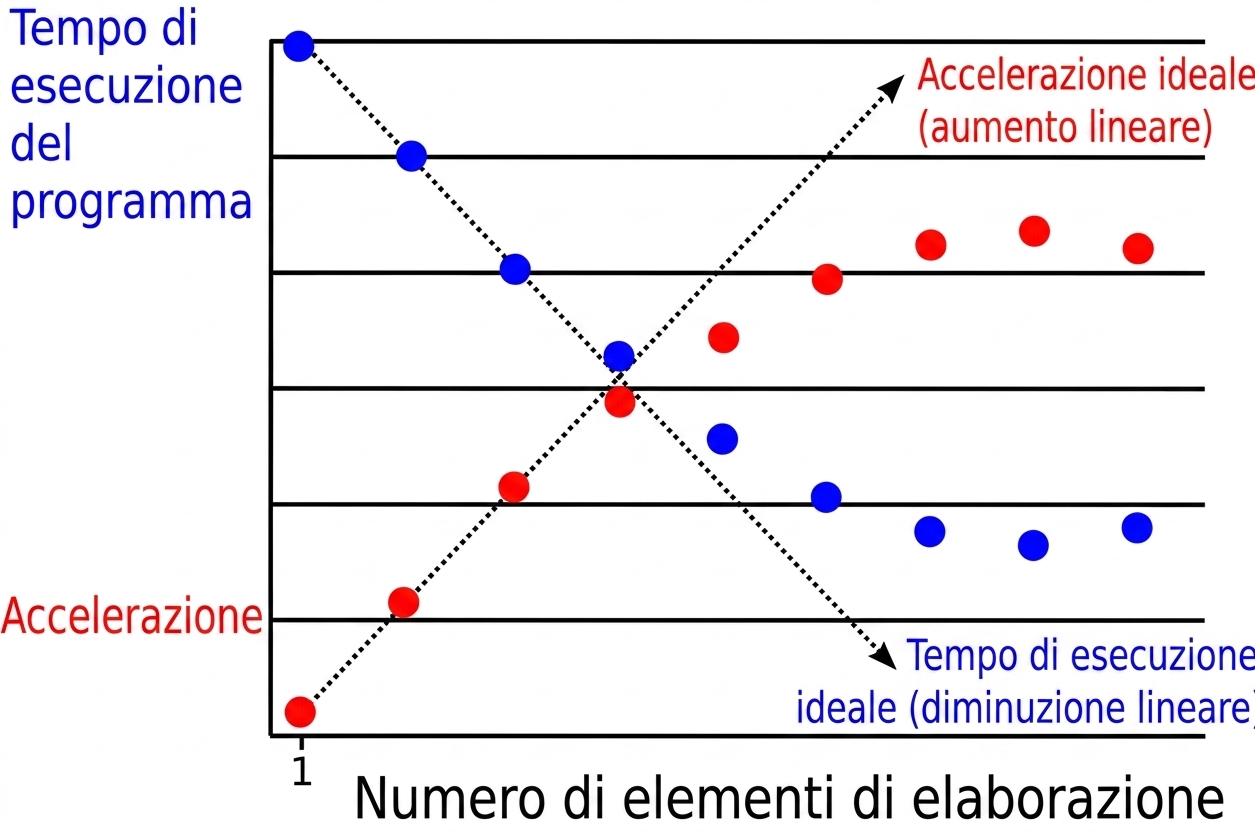
Rischi del calcolo parallelo

Overhead dovuto alla comunicazione


  • Il compito deve essere grande
  • Servono più unità di calcolo


Rallentamento in parallelo: Grafico che mostra il rallentamento in parallelo

Introduzione al Data Engineering

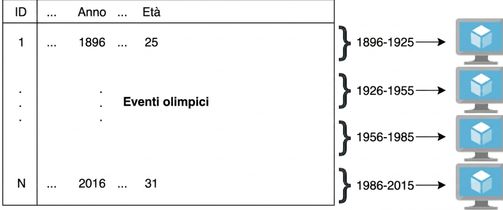
Un esempio


Diagramma che illustra l'esempio delle Olimpiadi

Introduzione al Data Engineering

multiprocessing.Pool

from multiprocessing import Pool

def take_mean_age(year_and_group): year, group = year_and_group return pd.DataFrame({"Age": group["Age"].mean()}, index=[year])
with Pool(4) as p: results = p.map(take_mean_age, athlete_events.groupby("Year"))
result_df = pd.concat(results)
Introduzione al Data Engineering

dask


import dask.dataframe as dd

# Partition dataframe into 4 athlete_events_dask = dd.from_pandas(athlete_events, npartitions = 4)
# Run parallel computations on each partition result_df = athlete_events_dask.groupby('Year').Age.mean().compute()
Introduzione al Data Engineering

Esercitiamoci!

Introduzione al Data Engineering

Preparing Video For Download...