Regressione logistica e regolarizzazione

Classificatori lineari in Python

Michael (Mike) Gelbart

Instructor, The University of British Columbia

Regressione logistica regolarizzata
Classificatori lineari in Python

Regressione logistica regolarizzata

Classificatori lineari in Python

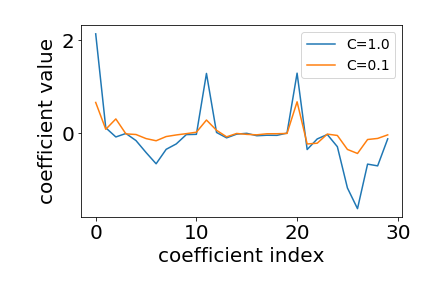
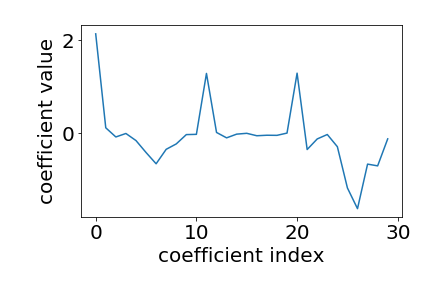
Come influisce la regolarizzazione sull'accuratezza di training?

lr_weak_reg = LogisticRegression(C=100)
lr_strong_reg = LogisticRegression(C=0.01)

lr_weak_reg.fit(X_train, y_train) lr_strong_reg.fit(X_train, y_train)
lr_weak_reg.score(X_train, y_train) lr_strong_reg.score(X_train, y_train)
1.0
0.92

$\text{loss regolarizzata = loss originale + penalità sui coefficienti grandi}$

  • più regolarizzazione: minore accuratezza in training
Classificatori lineari in Python

Come influisce la regolarizzazione sull'accuratezza di test?

lr_weak_reg.score(X_test, y_test)
0.86
lr_strong_reg.score(X_test, y_test)
0.88

$\text{loss regolarizzata = loss originale + penalità sui coefficienti grandi}$

  • più regolarizzazione: minore accuratezza in training
  • più regolarizzazione: (quasi sempre) maggiore accuratezza su test
Classificatori lineari in Python

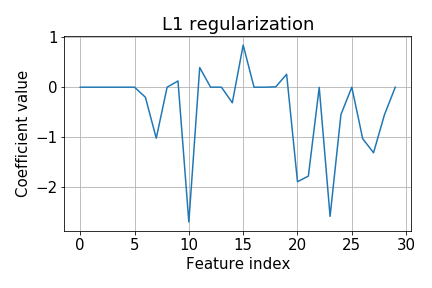
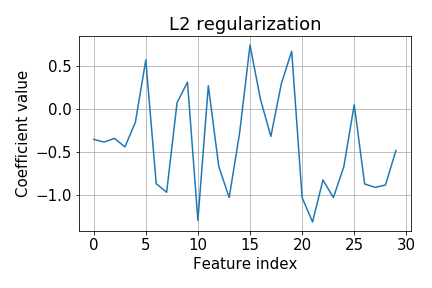
Regolarizzazione L1 vs L2

  • Lasso = regressione lineare con regolarizzazione L1
  • Ridge = regressione lineare con regolarizzazione L2
  • Per altri modelli come la regressione logistica diciamo semplicemente L1, L2, ecc.
lr_L1 = LogisticRegression(solver='liblinear', penalty='l1')
lr_L2 = LogisticRegression() # penalty='l2' by default

lr_L1.fit(X_train, y_train)
lr_L2.fit(X_train, y_train)
plt.plot(lr_L1.coef_.flatten())
plt.plot(lr_L2.coef_.flatten())
Classificatori lineari in Python

Regolarizzazione L2 vs L1

Classificatori lineari in Python

Esercitiamoci!

Classificatori lineari in Python

Preparing Video For Download...