Paralel hesaplama çerçeveleri

Data Engineering'e Giriş

Vincent Vankrunkelsven

Data Engineer, DataCamp


Apache Hadoop logosu

Data Engineering'e Giriş

HDFS


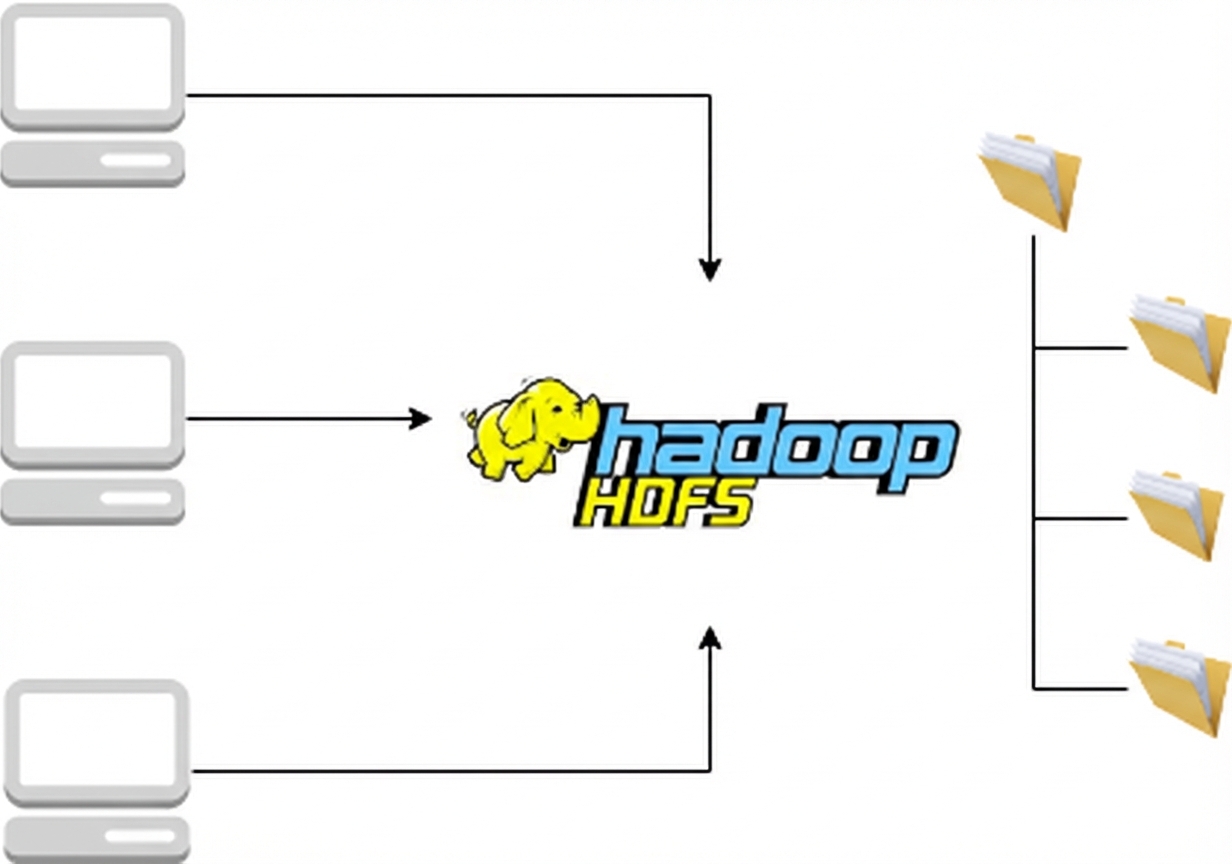
Dağıtık dosya sistemi olarak HDFS diyagramı

Data Engineering'e Giriş

MapReduce


Hadoop MapReduce logosu


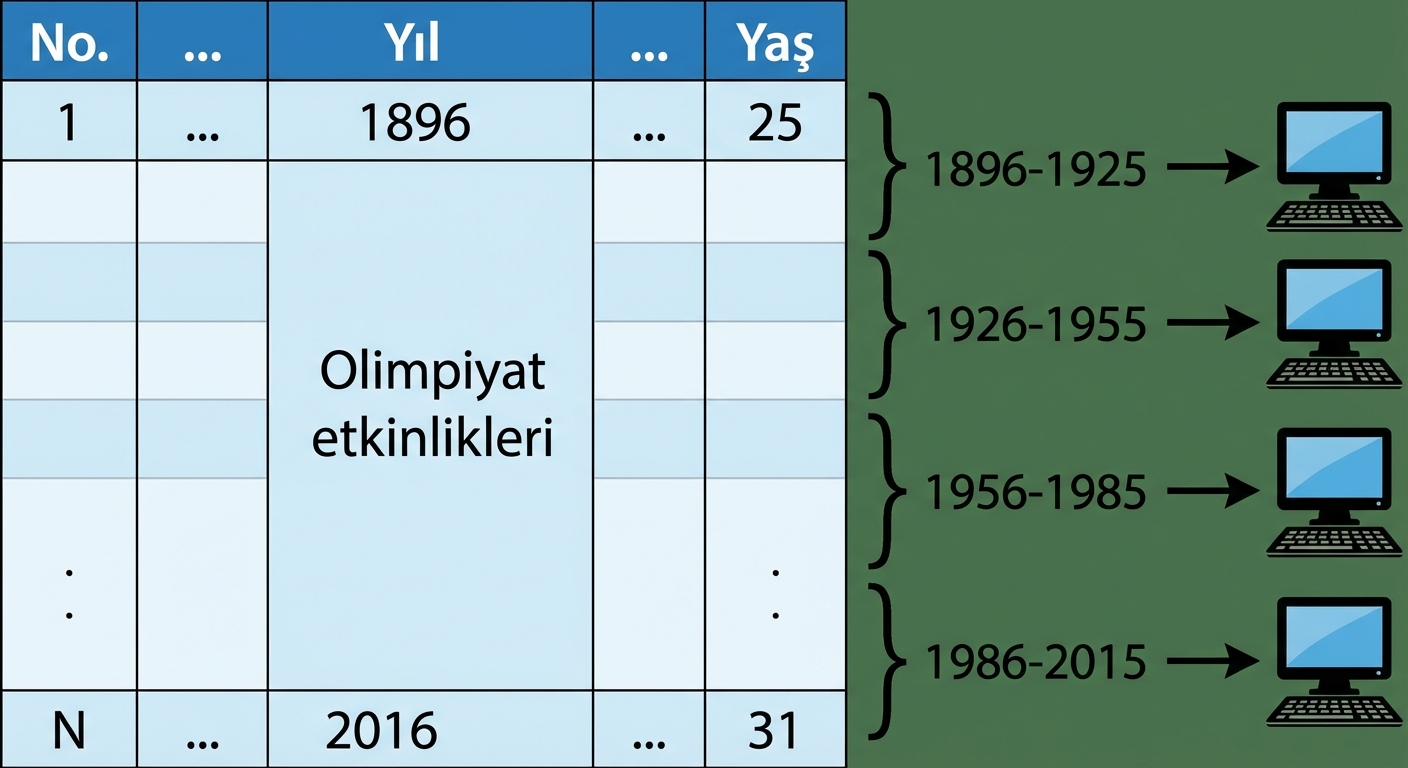
Olimpik etkinlikler örneğini gösteren diyagram

Data Engineering'e Giriş

Hive


  • Hadoop üzerinde çalışır
  • Yapılandırılmış Sorgu Dili: Hive SQL
  • Başta MapReduce, şimdi diğer araçlar da

Apache Hive logosu

Data Engineering'e Giriş

Hive: bir örnek


SELECT year, AVG(age)
FROM views.athlete_events
GROUP BY year


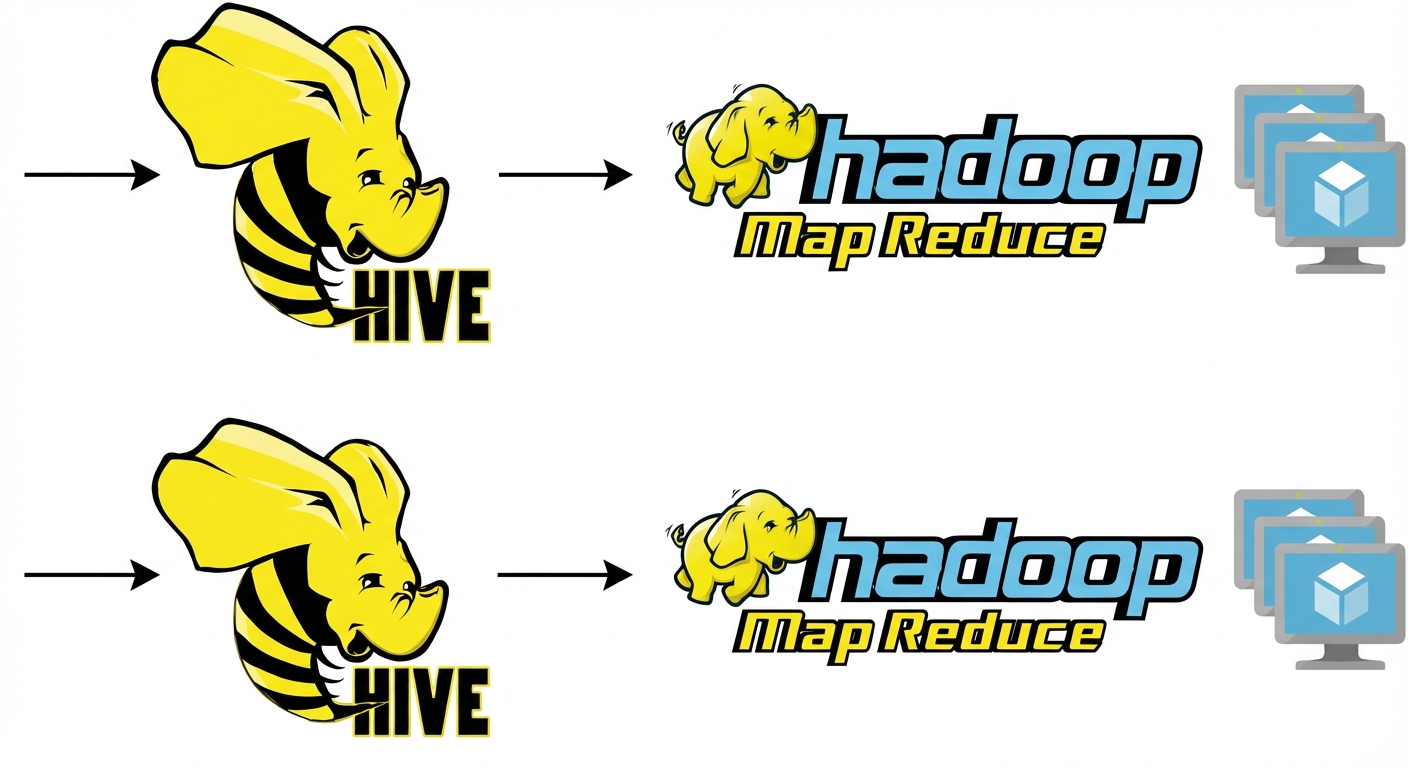
Hive'dan MapReduce'a diyagram

Data Engineering'e Giriş

Spark logosu görseli

  • Disk yazımlarından kaçınır
  • Apache Software Foundation tarafından geliştirilir
Data Engineering'e Giriş

Dayanıklı dağıtık veri kümeleri (RDD)


  • Spark bunlara dayanır
  • Tuple listesine benzer
  • Dönüşümler: .map() veya .filter()
  • Eylemler: .count() veya .first()
Data Engineering'e Giriş

PySpark


  • Spark için Python arayüzü
  • DataFrame soyutlaması
  • Pandas'a benzer görünür
Data Engineering'e Giriş

PySpark: bir örnek

# Load the dataset into athlete_events_spark first

(athlete_events_spark
  .groupBy('Year')
  .mean('Age')
  .show())
SELECT year, AVG(age)
FROM views.athlete_events
GROUP BY year
Data Engineering'e Giriş

Haydi pratik yapalım!

Data Engineering'e Giriş

Preparing Video For Download...