Omgaan met missende data

Verkennende data-analyse in Python

George Boorman

Curriculum Manager, DataCamp

Waarom is missende data een probleem?
  • Beïnvloedt verdelingen
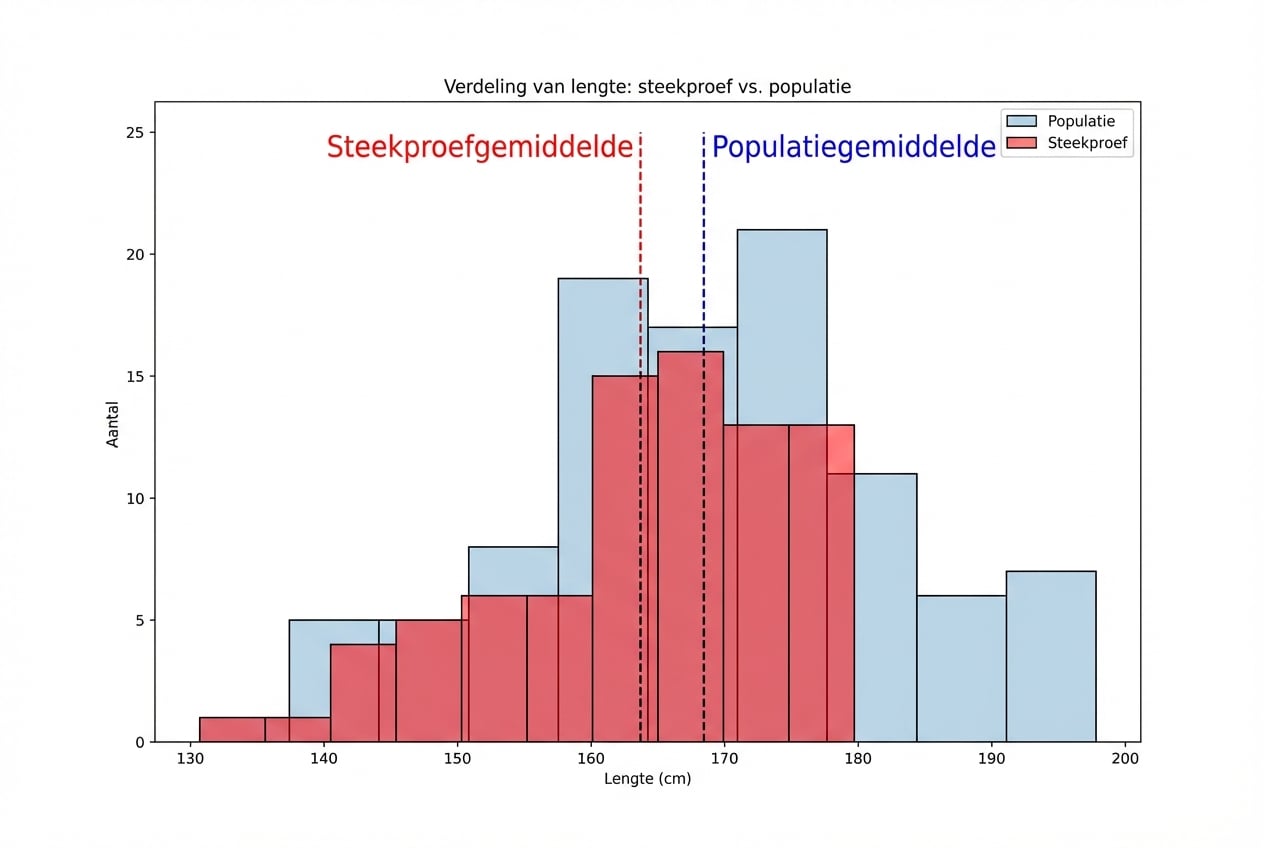
    • Ontbrekende lengtes van langere studenten
  • Minder representatief voor de populatie
    • Bepaalde groepen over- of ondervertegenwoordigd, bijv. geen data over oudste studenten
  • Kan leiden tot verkeerde conclusies

Steekproef versus populatie-lengteverdeling; de steekproef heeft een lagere maximum en gemiddelde

Verkennende data-analyse in Python

Banen van dataprofessionals

Kolom Beschrijving Gegevenstype
Working_Year Jaar waarin de data is verzameld Float
Designation Functietitel String
Experience Ervaringsniveau, bijv. "Mid", "Senior" String
Employment_Status Type arbeidsovereenkomst, bijv. "FT", "PT" String
Employee_Location Land van tewerkstelling String
Company_Size Labels voor bedrijfsomvang, bijv. "S", "M", "L" String
Remote_Working_Ratio Percentage van de tijd op afstand werken Integer
Salary_USD Salaris in US-dollars Float
Verkennende data-analyse in Python

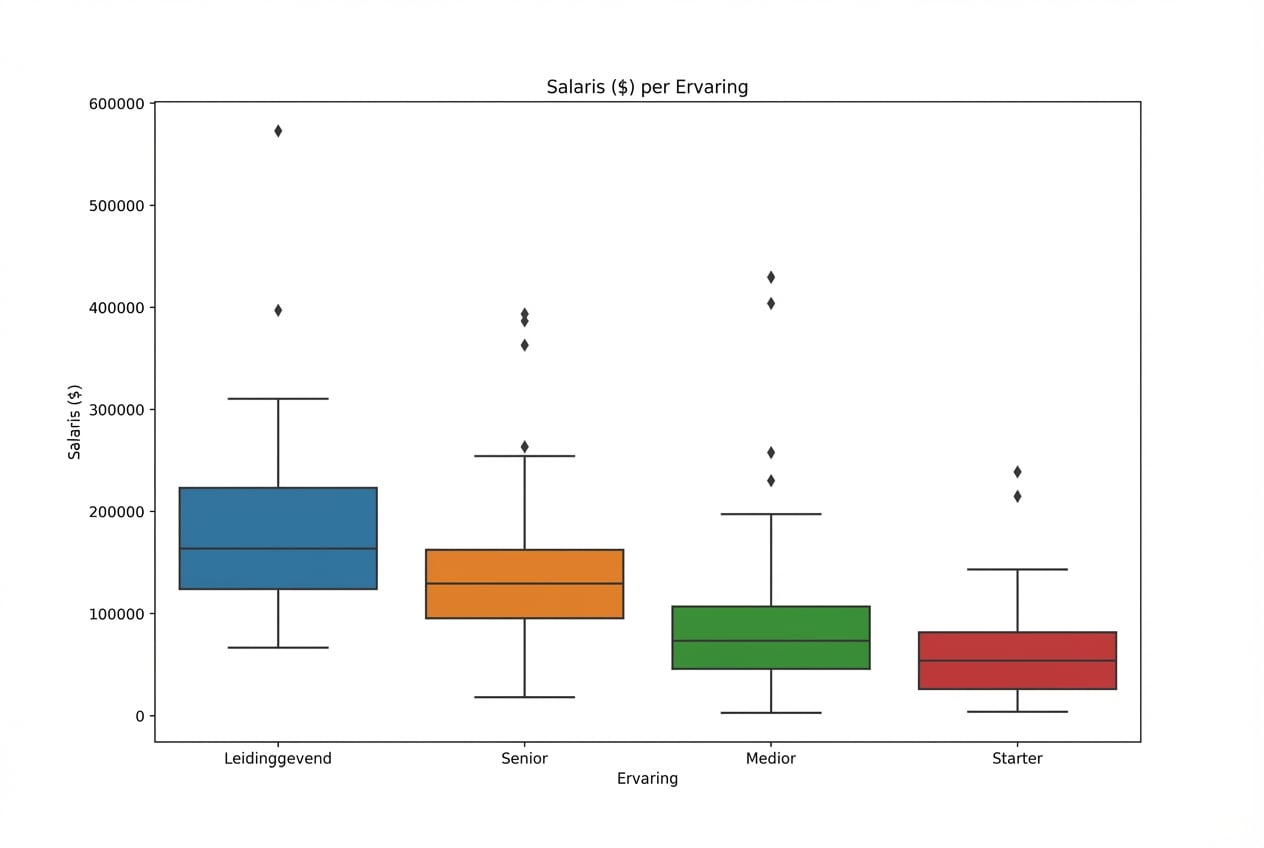
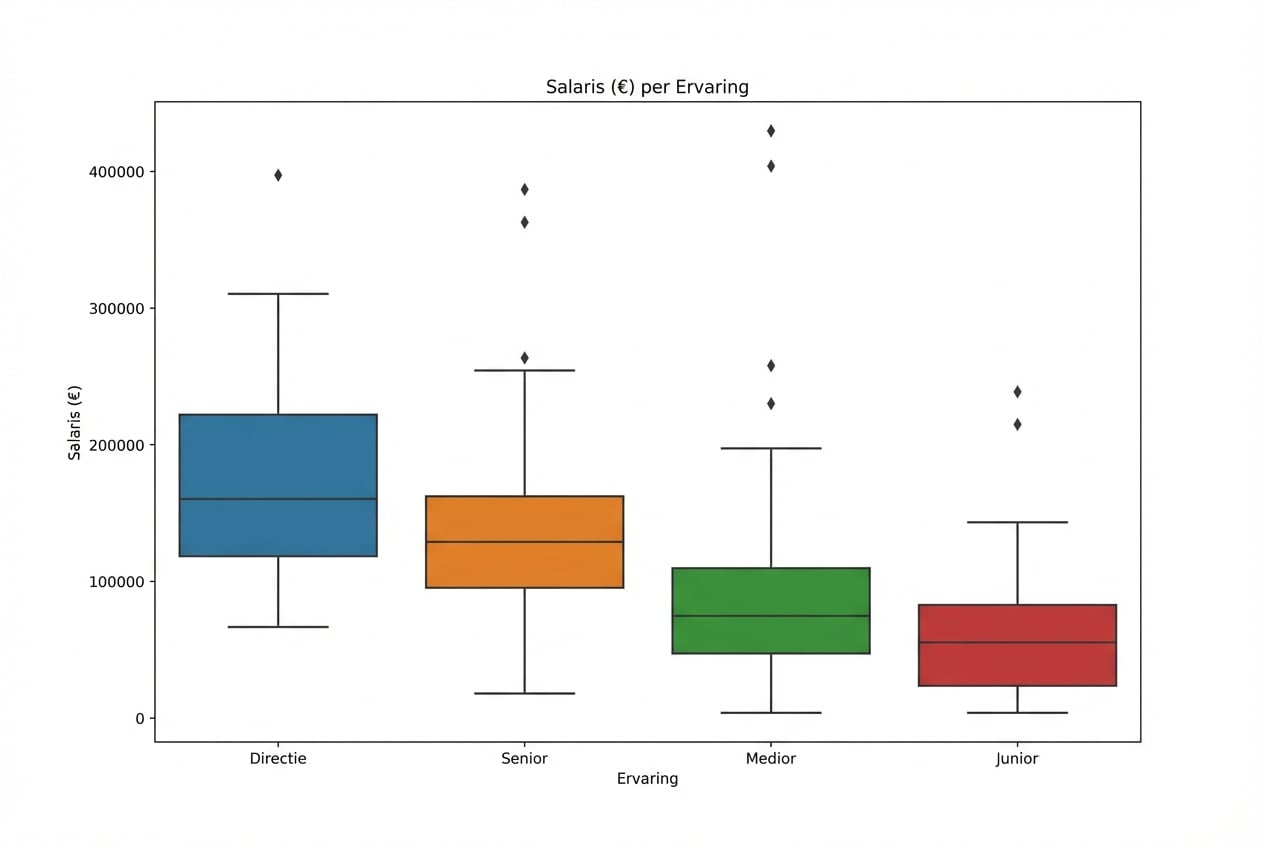
Salaris per ervaringsniveau

Boxplot van salarissen per ervaringsniveau met de schone gegevensset; bovengrens rond 600000 dollar

Boxplot van salarissen per ervaringsniveau met een gegevensset met missende waarden; bovengrens rond 450000 dollar

Verkennende data-analyse in Python

Controleren op missende waarden

print(salaries.isna().sum())
Working_Year            12
Designation             27
Experience              33
Employment_Status       31
Employee_Location       28
Company_Size            40
Remote_Working_Ratio    24
Salary_USD              60
dtype: int64
Verkennende data-analyse in Python

Strategieën voor missende data

  • Verwijder missende waarden
    • 5% of minder van het totaal
  • Imputeer met gemiddelde, mediaan, modus
    • Afhankelijk van verdeling en context
  • Imputeer per subgroep
    • Verschillende ervaringsniveaus hebben andere mediasalarissen
Verkennende data-analyse in Python

Missende waarden verwijderen

threshold = len(salaries) * 0.05
print(threshold)
30
Verkennende data-analyse in Python

Missende waarden verwijderen

cols_to_drop = salaries.columns[salaries.isna().sum() <= threshold]

print(cols_to_drop)
Index(['Working_Year', 'Designation', 'Employee_Location',
       'Remote_Working_Ratio'],
      dtype='object')
salaries.dropna(subset=cols_to_drop, inplace=True)
Verkennende data-analyse in Python

Imputeren met een samenvattingsmaat

cols_with_missing_values = salaries.columns[salaries.isna().sum() > 0]
print(cols_with_missing_values)
Index(['Experience', 'Employment_Status', 'Company_Size', 'Salary_USD'], 
    dtype='object')
for col in cols_with_missing_values[:-1]:
    salaries[col].fillna(salaries[col].mode()[0])
Verkennende data-analyse in Python

Resterende missende waarden controleren

print(salaries.isna().sum())
Working_Year             0
Designation              0
Experience               0
Employment_Status        0
Employee_Location        0
Company_Size             0
Remote_Working_Ratio     0
Salary_USD              41
Verkennende data-analyse in Python

Imputeren per subgroep

salaries_dict = salaries.groupby("Experience")["Salary_USD"].median().to_dict()

print(salaries_dict)
{'Entry': 55380.0, 'Executive': 135439.0, 'Mid': 74173.5, 'Senior': 128903.0}
Verkennende data-analyse in Python

Imputeren per subgroep

salaries["Salary_USD"] = salaries["Salary_USD"].fillna(salaries["Experience"].map(salaries_dict))
Verkennende data-analyse in Python

Geen missende waarden meer!

print(salaries.isna().sum())
Working_Year            0
Designation             0
Experience              0
Employment_Status       0
Employee_Location       0
Company_Size            0
Remote_Working_Ratio    0
Salary_USD              0
dtype: int64
Verkennende data-analyse in Python

Laten we oefenen!

Verkennende data-analyse in Python

Preparing Video For Download...