Introductie tot Data Engineering
Vincent Vankrunkelsven
Data Engineer, DataCamp
def extract_table_to_df(tablename, db_engine): return pd.read_sql("SELECT * FROM {}".format(tablename), db_engine)def split_columns_transform(df, column, pat, suffixes): # Zet kolom om naar str en splitst op pat...def load_df_into_dwh(film_df, tablename, schema, db_engine): return film_df.to_sql(tablename, db_engine, schema=schema, if_exists="replace")db_engines = { ... } # Moet worden geconfigureerd def etl(): # Extract film_df = extract_table_to_df("film", db_engines["store"]) # Transform film_df = split_columns_transform(film_df, "rental_rate", ".", ["_dollar", "_cents"]) # Load load_df_into_dwh(film_df, "film", "store", db_engines["dwh"])


task-decorator of met operatorsfrom airflow.sdk import dag
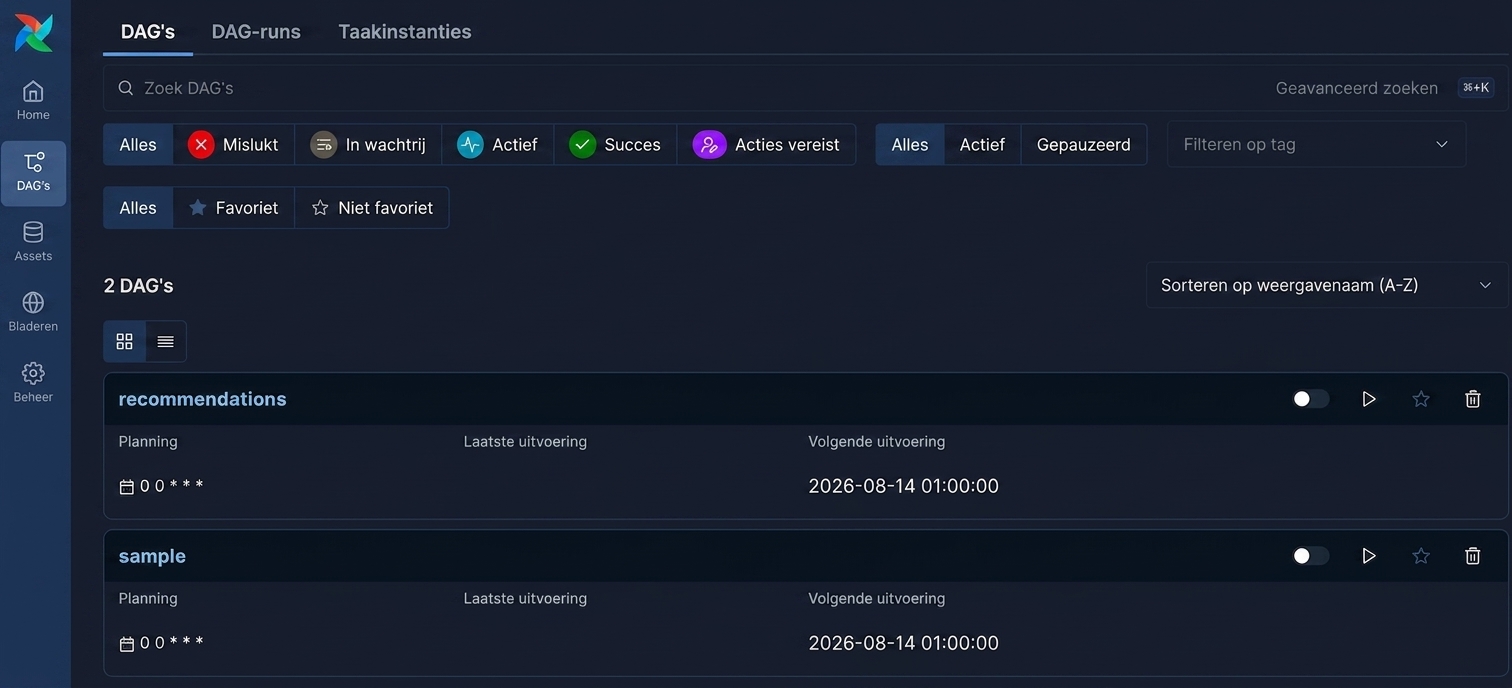
@dag(dag_id="sample", start_date=datetime(2024, 1, 1),
schedule="0 0 * * *")
def sample():
...
# .------------------------- minuut (0 - 59)
# | .----------------------- uur (0 - 23)
# | | .--------------------- dag v/d maand (1 - 31)
# | | | .------------------- maand (1 - 12)
# | | | | .----------------- dag v/d week (0 - 6)
# * * * * * <command>
0 * * * * # Elk uur op minuut 0
from airflow.sdk import dag, task @task(task_id="etl_task") def etl(): ...@dag(dag_id="etl_pipeline", start_date=datetime(2024, 1, 1), schedule="0 0 * * *") def etl_pipeline(): wait_for_table = EmptyOperator(task_id="wait") wait_for_table >> etl()etl_pipeline()
from airflow.sdk import dag, task
...
etl_pipeline()
Opgeslagen als etl_dag.py in ~/airflow/dags/

Introductie tot Data Engineering