Normale data

Experimenteel ontwerpen in Python

James Chapman

Curriculum Manager, DataCamp

De normale verdeling
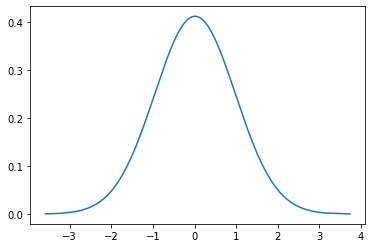
 

  • De bekende ‘klokvorm’
  • Gerelateerd aan z-scores

$$ {z} = \frac{x-\mu}{\sigma}$$

  • Gemiddelde = 0, sd = 1
    • ‘Hoeveel standaarddeviaties ligt dit punt van het gemiddelde?’
    • ‘Wat is de kans op deze score?’


Een plot van een typische klokvormige curve, een blauwe lijn op een witte achtergrond.

Experimenteel ontwerpen in Python

Normale data en statistische toetsen


  • Vereist voor parametrische toetsen
  • Niet-parametrische toetsen: veronderstellen geen normale data


Een plot van een typische klokvormige curve, een blauwe lijn op een witte achtergrond.

Experimenteel ontwerpen in Python

Normaal, Z en alpha


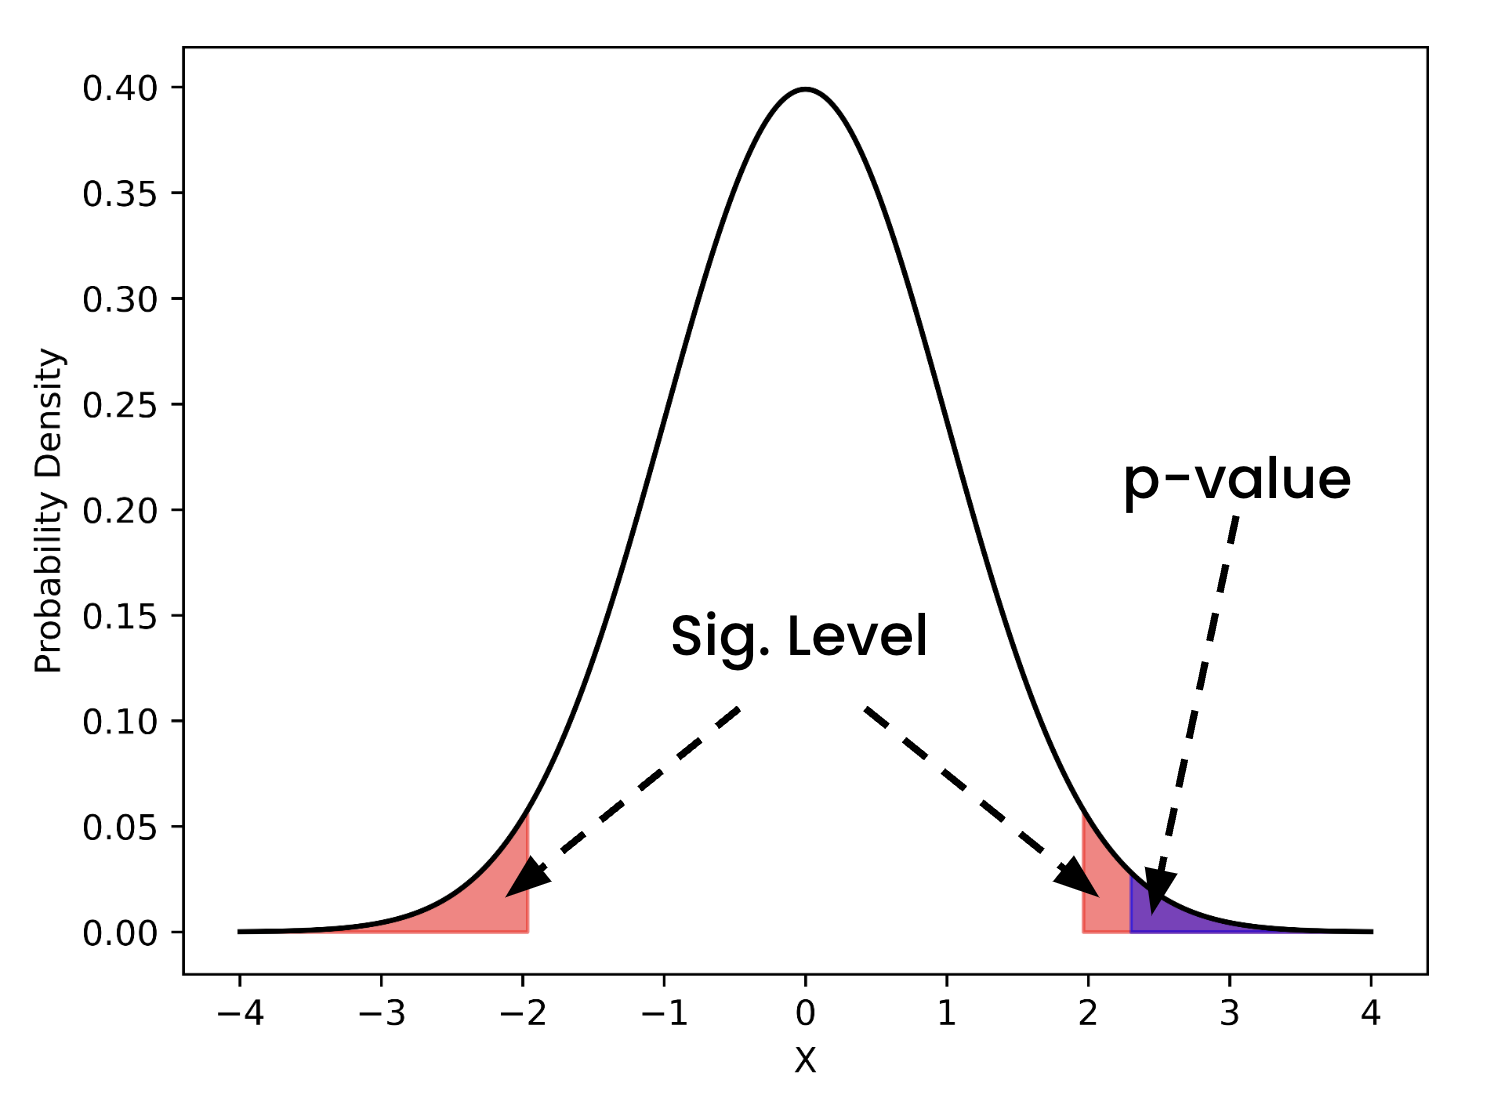
  • Cruciale link met significantieniveau ($\alpha$)
  • Vergelijk p-waarde met $\alpha$
  • Kans op een Type I-fout


Een normale verdeling met twee kleine zwarte gebieden in de staarten

Experimenteel ontwerpen in Python

Normale data visualiseren


sns.displot(data=salaries,
            x='salary',
            kind="kde")
plt.show()


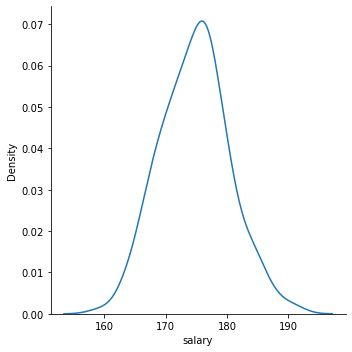
Een klokvormige verdeling die hoger en smaller is dan normaal, maar nog steeds de typische klokcurve heeft

Experimenteel ontwerpen in Python

QQ-plots

QQ-plot: vergelijk data met een verdeling

from statsmodels.graphics.gofplots import qqplot
from scipy.stats.distributions import norm
qqplot(salaries['salary'], 
       line='s', 
       dist=norm)
plt.show()
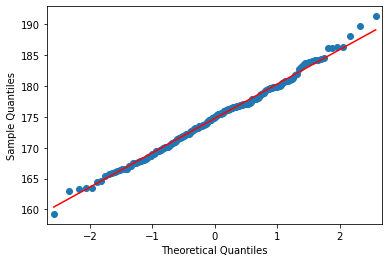
  • Ideaal: punten dicht op de lijn
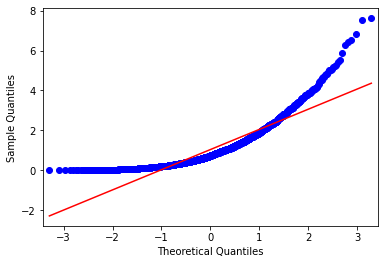
  • Slecht: buigen aan de uiteinden


Een QQ-plot waar de punten grotendeels strak rond de 45-gradenlijn liggen

Een QQ-plot waar de middelste punten de 45-gradenlijn volgen, maar de uiteinden naar binnen buigen tot een kromme lijn

Experimenteel ontwerpen in Python

Toetsen op normaliteit


  • Shapiro-Wilk (goed voor kleine datasets)
  • D'Agostino $K^2$ (gebruikt kurtosis en scheefheid)
  • Anderson-Darling (geeft lijst met waarden)


$H_0$ = "Data komt uit een normale verdeling"

Experimenteel ontwerpen in Python

Een Shapiro-Wilk-toets


from scipy.stats import shapiro
alpha = 0.05

stat, p = shapiro(salaries['salary']) print(f"p: {round(p,4)} test stat: {round(stat,4)}")
p: 0.8293 test stat: 0.9956
  • p > alpha
    • $H_0$ niet verwerpen → waarschijnlijk normaal
Experimenteel ontwerpen in Python

Een Anderson–Darling-toets

from scipy.stats import anderson
result = anderson(x=salaries['salary'], dist="norm")
print(round(result.statistic,4))
print(result.significance_level)
print(result.critical_values)
0.2748
[15.  10.   5.   2.5  1. ]
[0.572 0.651 0.781 0.911 1.084]
  • 0.2748 < [0.572 0.651 0.781 0.911 1.084]
    • $H_0$ niet verwerpen → waarschijnlijk normaal
Experimenteel ontwerpen in Python

Laten we oefenen!

Experimenteel ontwerpen in Python

Preparing Video For Download...