Opzet van experimentele data

Experimenteel ontwerpen in Python

James Chapman

Curriculum Manager, DataCamp

Het probleem met randomiseren
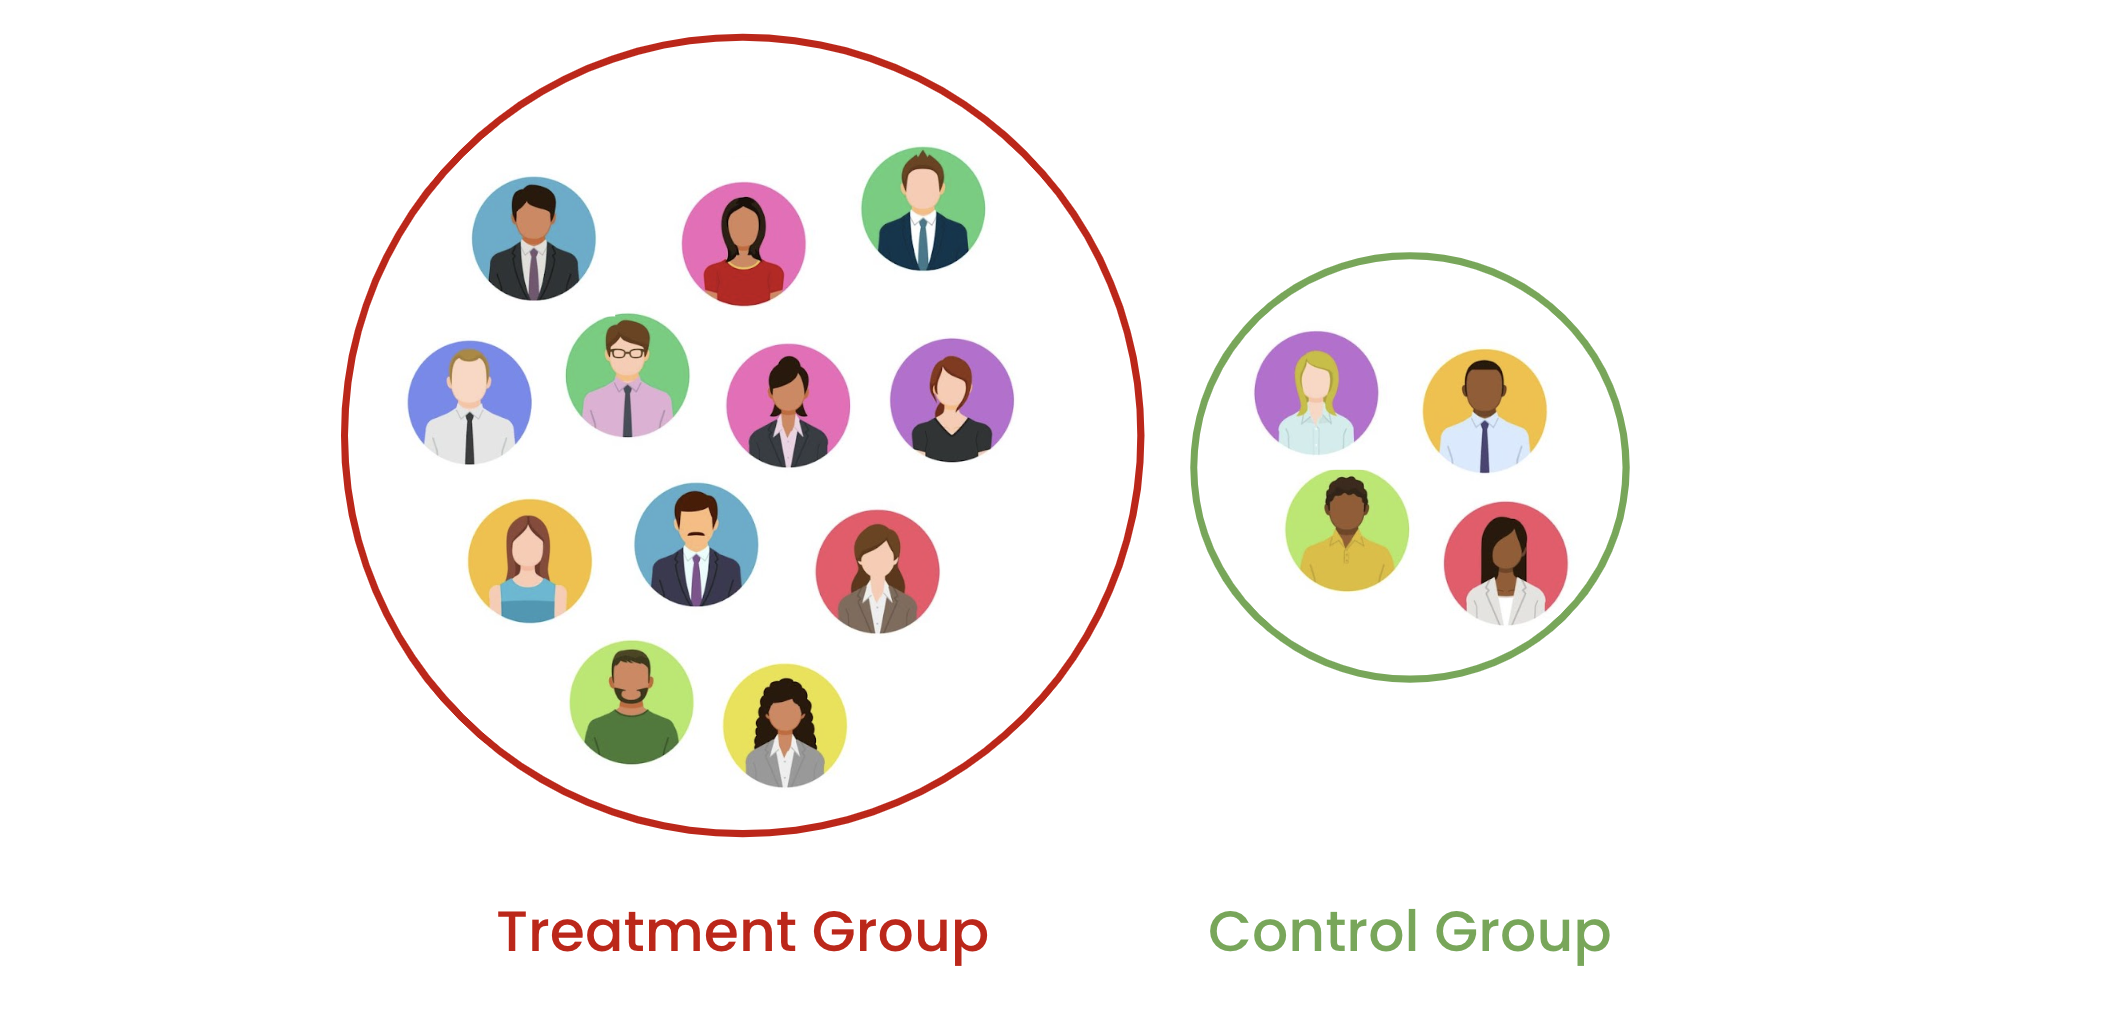
1) Oneven probleem: verschillend aantal proefpersonen per groep

Twee groepen met verschillende aantallen proefpersonen.

Experimenteel ontwerpen in Python

Het probleem met randomiseren

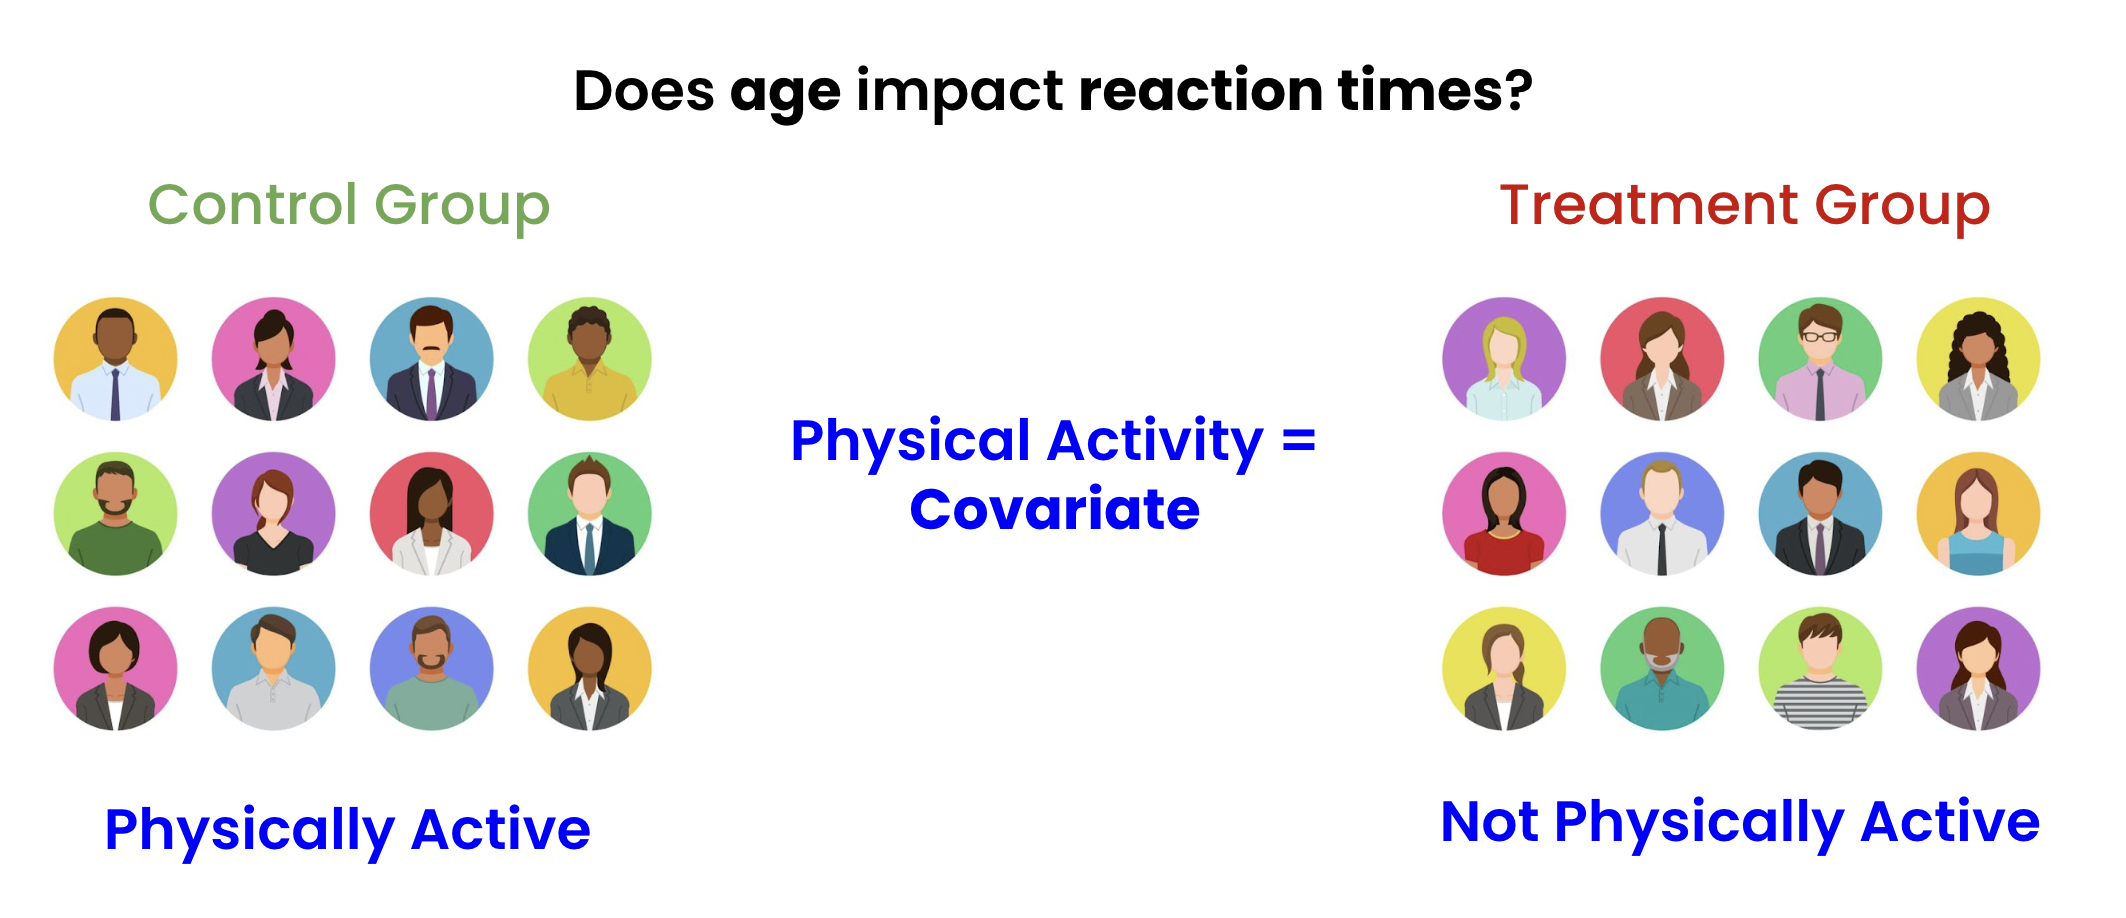
2) Covariaatprobleem: hoge variatie in sommige covariaten → onbalans bij randomiseren

Controle- en behandelingsgroepen om de impact van leeftijd op reactietijden te meten. De twee groepen hebben een ongelijke verdeling van fysieke fitheid, wat, hoewel niet het primaire doel, de variabele reactietijden kan beïnvloeden.

Resultaat: effect van behandeling lastiger te meten!

Experimenteel ontwerpen in Python

Blokrandomisatie


  • Eerst in blokken van grootte $n$ splitsen, dán randomiseren
    • Lost oneven probleem op

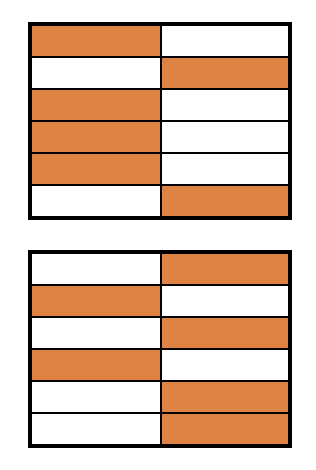
Een voorbeeld van blokrandomisatie met twee rasters van oranje en witte vakjes

  • 24 proefpersonen gesplitst in twee groepen, daarna gerandomiseerd
Experimenteel ontwerpen in Python

Onze dataset

  • E-commerce-dataset (ecom) (1000 proefpersonen)
    • Gemiddelde mandgrootte
    • Gemiddelde tijd op de website
    • Power user (gemiddeld 40+ minuten/dag op website)
   basket_size  web_time  power_user
0          227         7           0
1          123         5           0
2           98        16           0
3          211        45           1
4          133        17           0
Experimenteel ontwerpen in Python

Blokrandomisatie in Python

group1 = ecom.sample(frac=0.5, random_state=42, replace=False)
group1['Block'] = 1
group2 = ecom.drop(group1.index)
group2['Block'] = 2
print(len(group1), len(group2))
500,500
Experimenteel ontwerpen in Python

Splitsingen visualiseren


import seaborn as sns
import matplotlib.pyplot as plt
sns.displot(data=ecom, 
            x='basket_size', 
            hue='power_user', 
            fill=True, 
            kind='kde')    
plt.show()

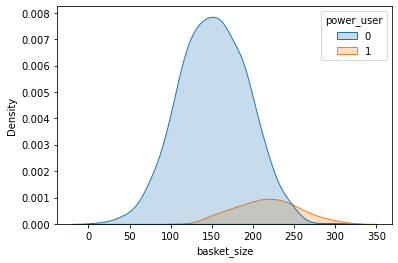
Confounding = variabele kan effect veroorzaken i.p.v. behandeling


Een seaborn-distributieplot met twee halfdoorzichtige normaalachtige verdelingen. Een grotere blauwe en een kleinere oranje die iets overlappen, met oranje meer naar rechts

Experimenteel ontwerpen in Python

Gestratificeerde randomisatie


  • Eerst splitsen op covariaten
    • Daarna randomiseren
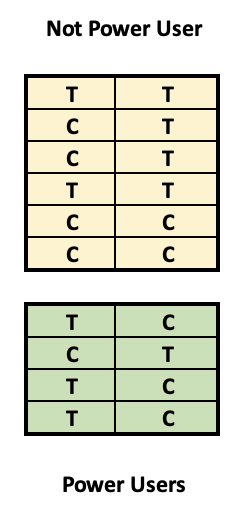
  • Groen = alle power users (Geel = geen power users)
    • Daarna splitsen in Treatment/Control
  • Lost covariaat-/confoundingprobleem op
  • Kan voor meerdere covariaten, maar wordt complex

Een afbeelding van twee rasterweergaven van data, één groen en één geel. Beide hebben in alle cellen de letter T of C, en het gele raster is groter

Experimenteel ontwerpen in Python

Onze eerste stratum

  • Power users apart zetten
  • Steekproef naar Treatment/Control
strata_1 = ecom[ecom['power_user'] == 1]
strata_1['Block'] = 1

strata_1_g1 = strata_1.sample(frac=0.5, replace=False) strata_1_g1['T_C'] = 'T'
strata_1_g2 = strata_1.drop(strata_1_g1.index) strata_1_g2['T_C'] = 'C'
Experimenteel ontwerpen in Python

Het tweede stratum

  • Niet-power users apart zetten
  • Steekproef naar Treatment/Control
strata_2 = ecom.drop(strata_1.index)
strata_2['Block'] = 2

strata_2_g1 = strata_2.sample(frac=0.5, replace=False) strata_2_g1['T_C'] = 'T' strata_2_g2 = strata_2.drop(strata_2_g1.index) strata_2_g2['T_C'] = 'C'
Experimenteel ontwerpen in Python

Stratificatie bevestigen

  • Blokken en groepen samenvoegen
  • Met groupby toewijzing checken
ecom_stratified = pd.concat([strata_1_g1, strata_1_g2, strata_2_g1, strata_2_g2])

ecom_stratified.groupby(['Block','T_C', 'power_user']).size()
Block  T_C  power_user
1      C    1              50
       T    1              50
2      C    0             450
       T    0             450
Experimenteel ontwerpen in Python

Laten we oefenen!

Experimenteel ontwerpen in Python

Preparing Video For Download...