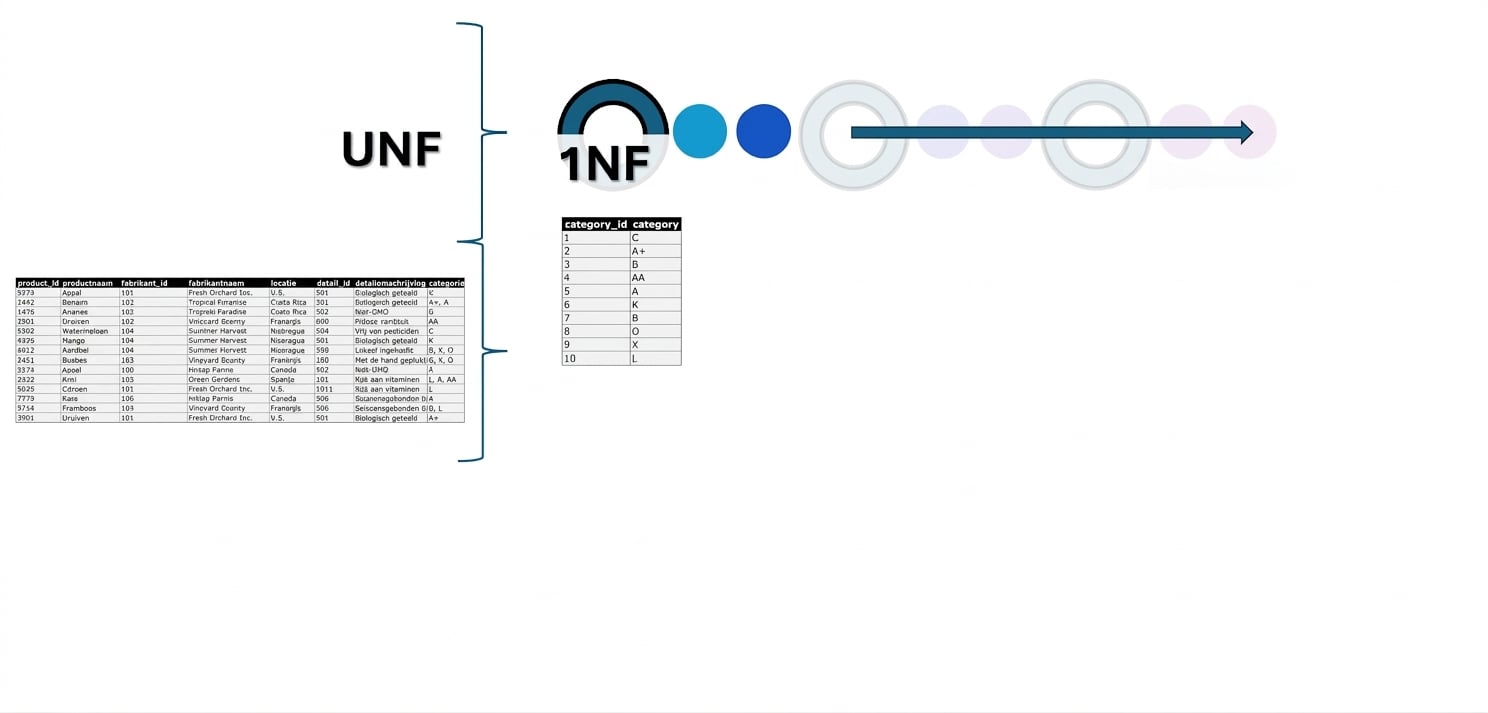
De eerste normaalvorm

Introductie tot datamodellering in Snowflake

Nuno Rocha

Director of Engineering

Het proces van datanormalisatie

  • Datanormalisatie: meerstapsproces om data te structureren en duplicatie en afhankelijkheden te minimaliseren
Vervaagde stappen na UNF

Introductie tot datamodellering in Snowflake

Het proces van datanormalisatie (1)

  • Datanormalisatie: meerstapsproces om data te structureren en duplicatie en afhankelijkheden te minimaliseren
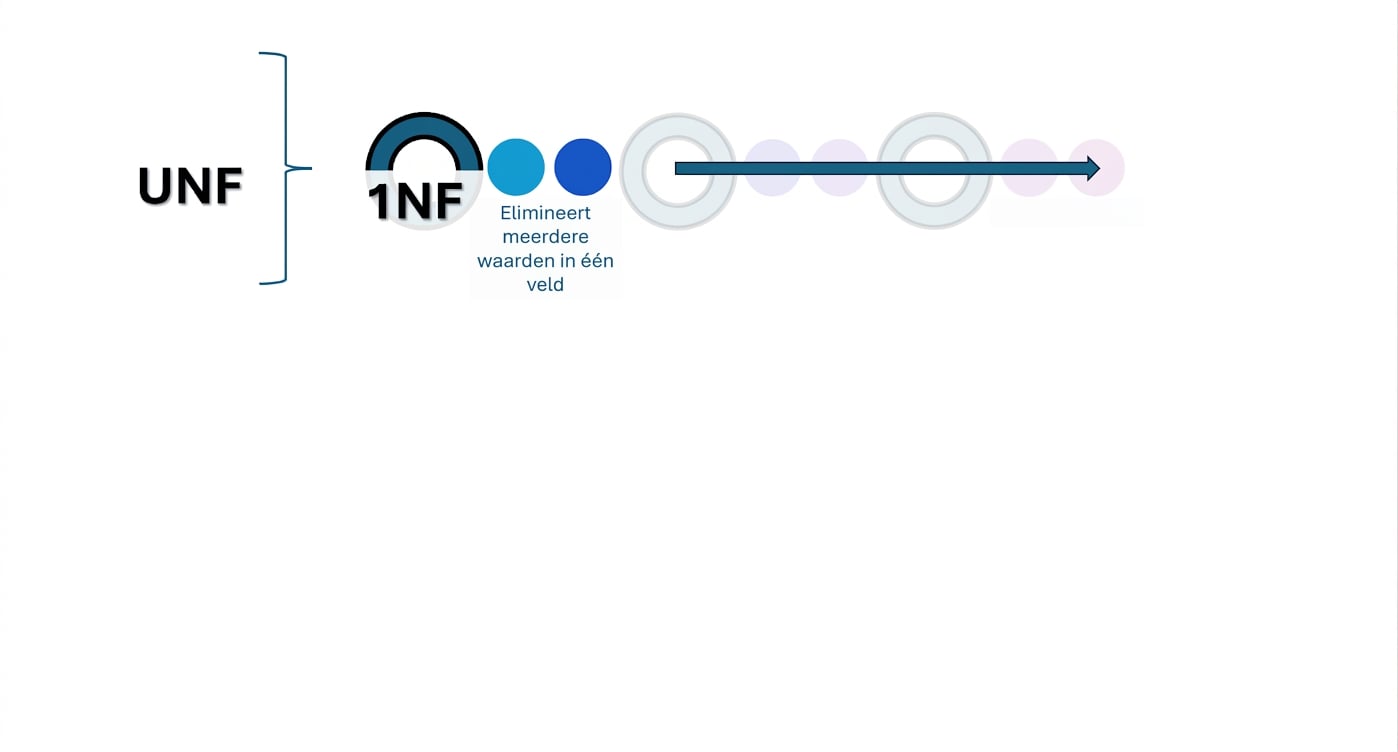
Stappen van UNF naar 1NF

Introductie tot datamodellering in Snowflake

Het proces van datanormalisatie (2)

  • Datanormalisatie: meerstapsproces om data te structureren en duplicatie en afhankelijkheden te minimaliseren
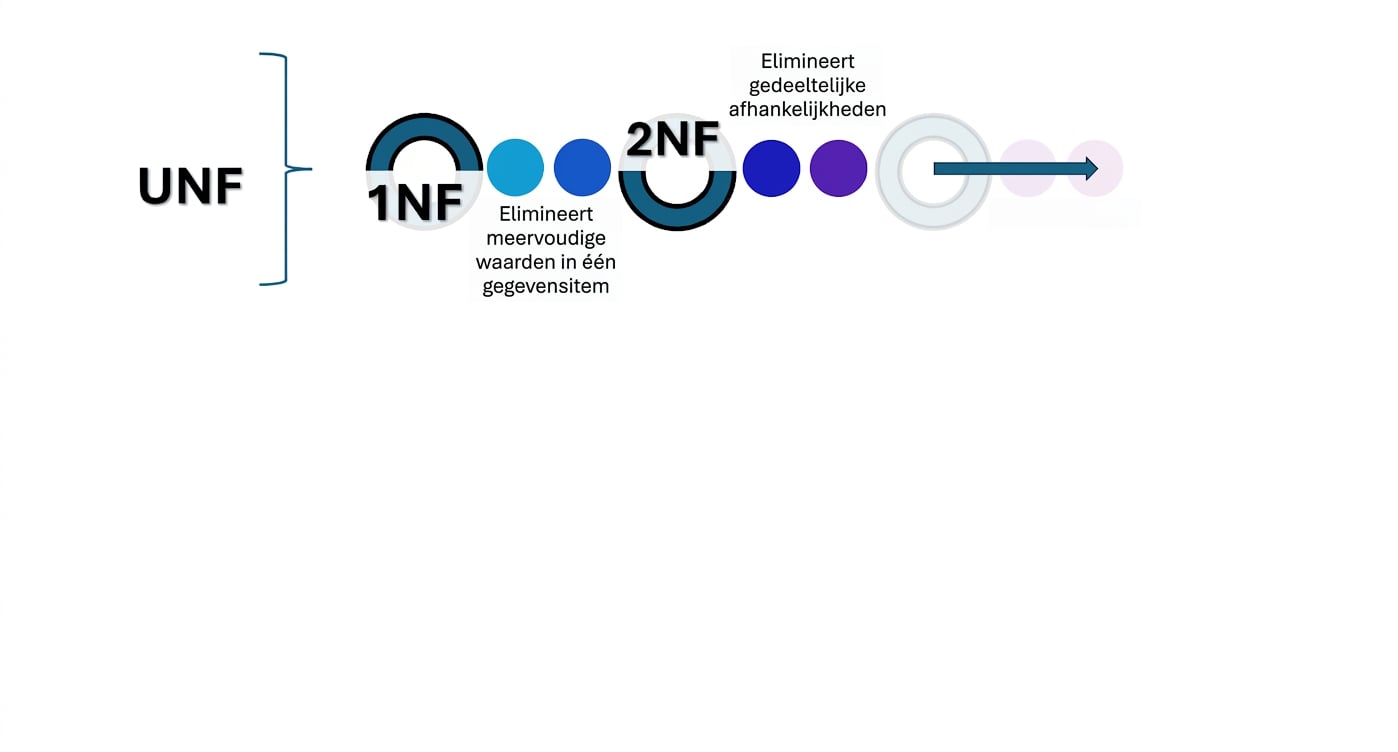
Stappen van UNF naar 3NF

Introductie tot datamodellering in Snowflake

Het proces van datanormalisatie (3)

  • Datanormalisatie: meerstapsproces om data te structureren en duplicatie en afhankelijkheden te minimaliseren
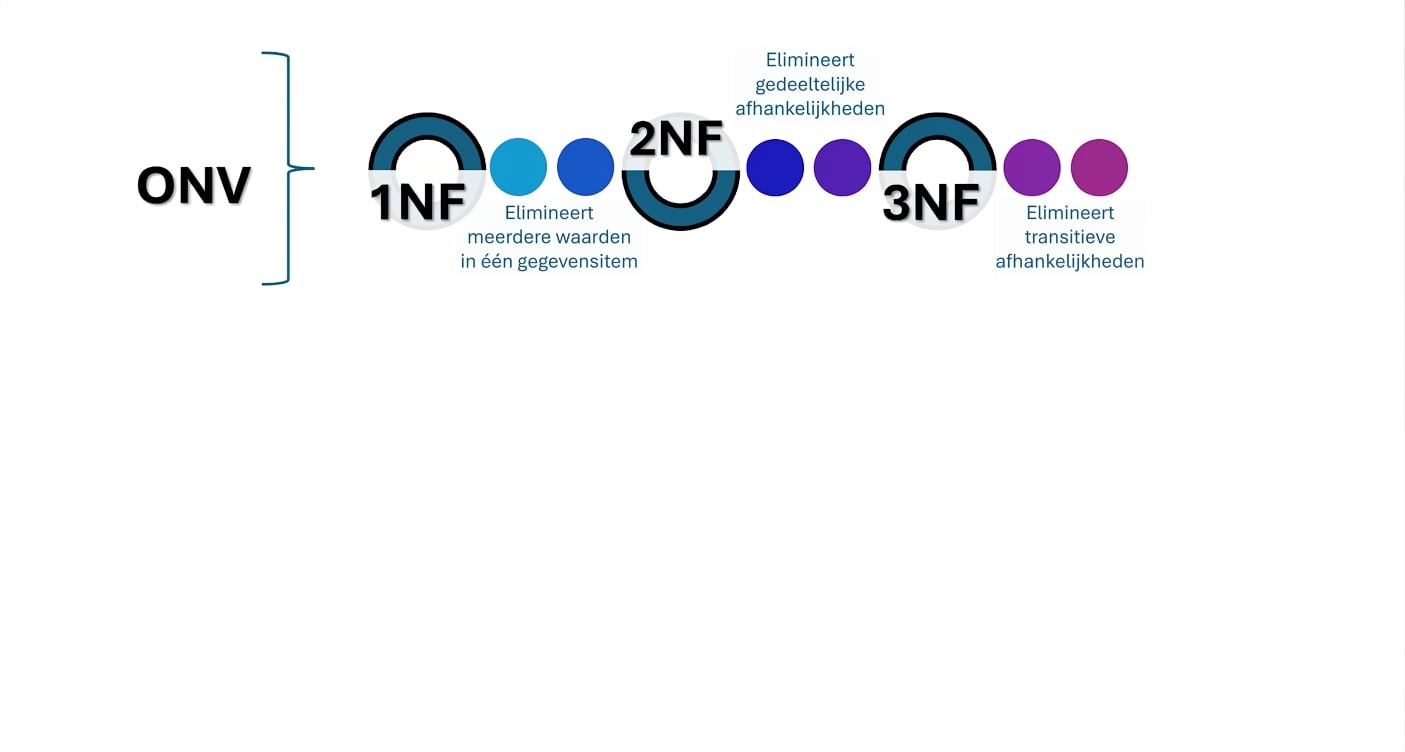
Stappen van UNF naar 3NF

Introductie tot datamodellering in Snowflake

De eerste normaalvorm

  • Eerste normaalvorm (1NF): zorgt dat elke kolom in een entiteit unieke atomaire waarden bevat
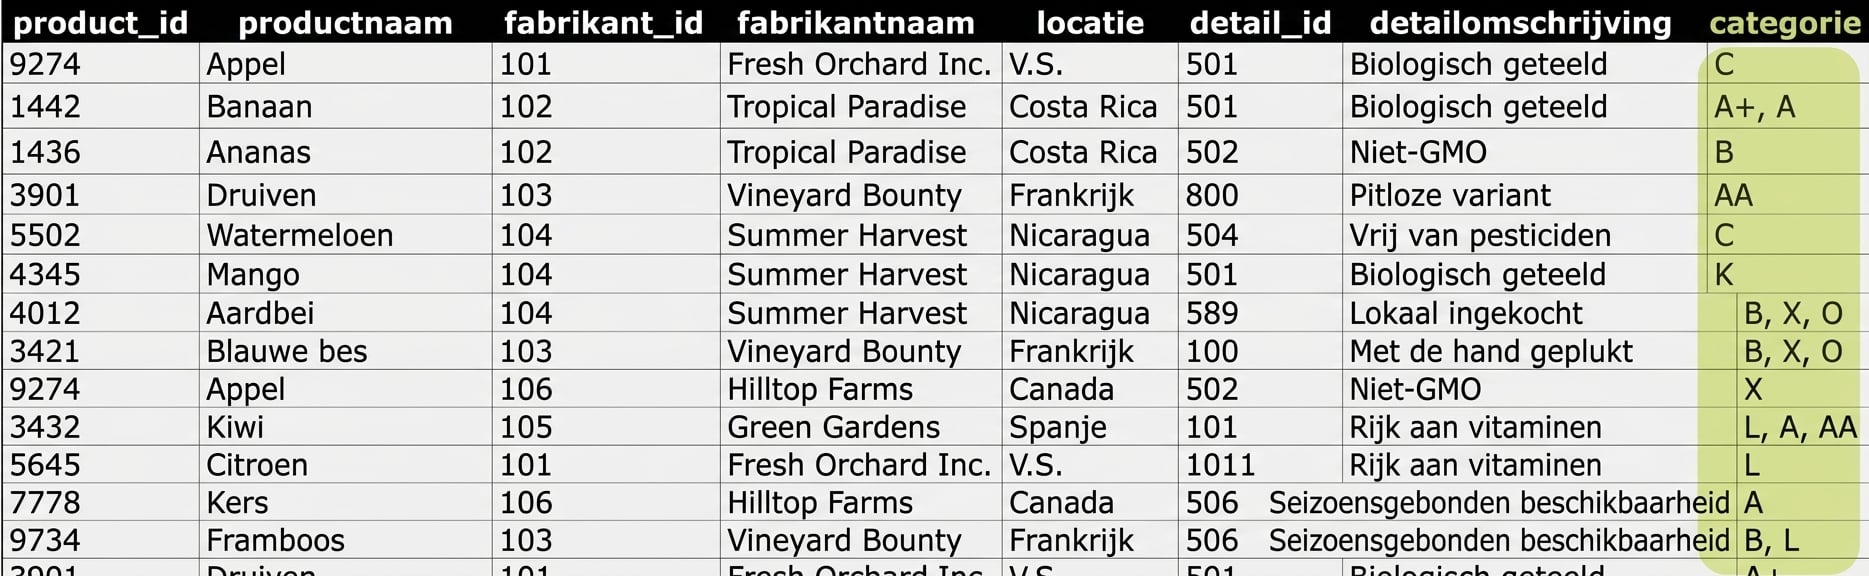
Tabel All products met categorie gemarkeerd

Introductie tot datamodellering in Snowflake

De eerste normaalvorm (1)

  • UNF-categoriedata: L-categorie staat niet los, waardoor bijwerken lastig is
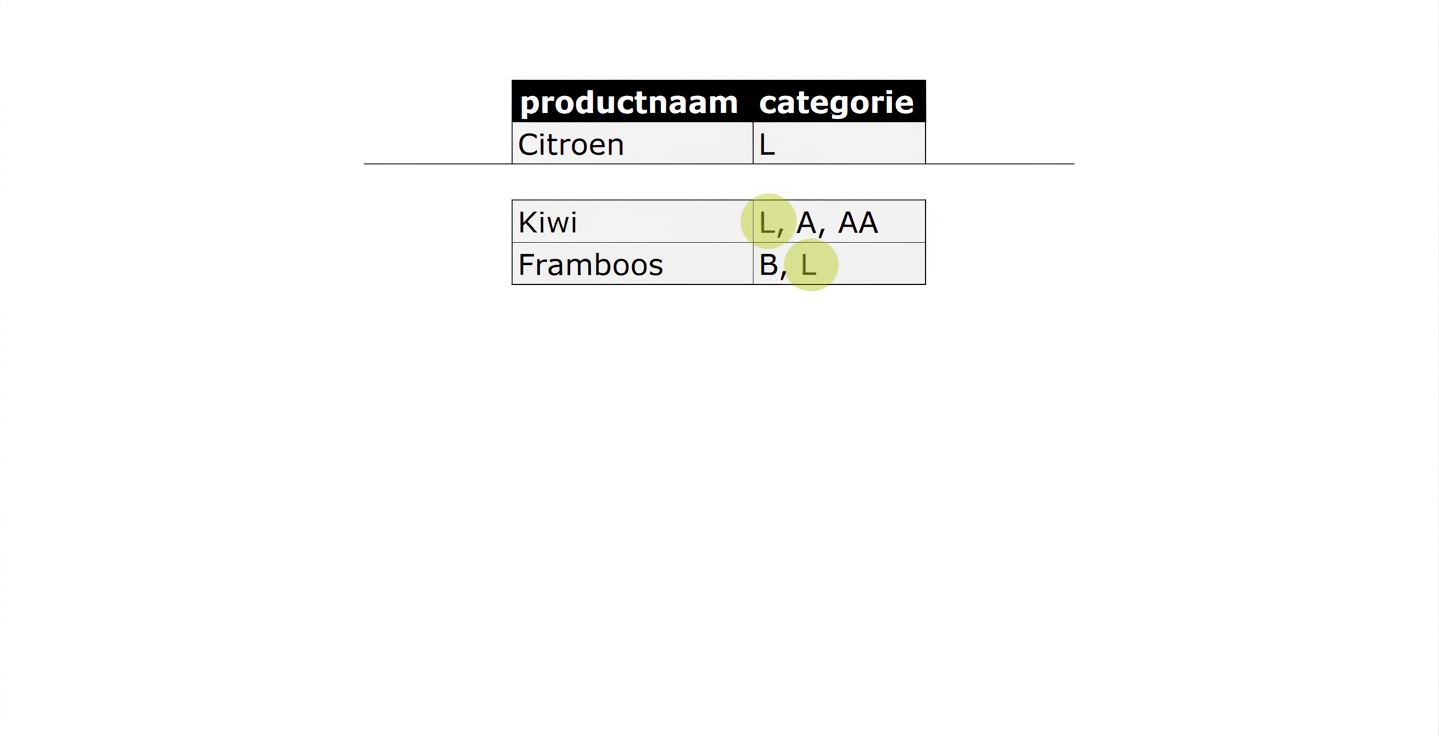
Lijst met alle producten die L bevatten

Introductie tot datamodellering in Snowflake

De eerste normaalvorm (2)

  • Validatiestap: Query de unieke waarden om te controleren op 1NF.
SELECT DISTINCT category 
FROM allproducts;
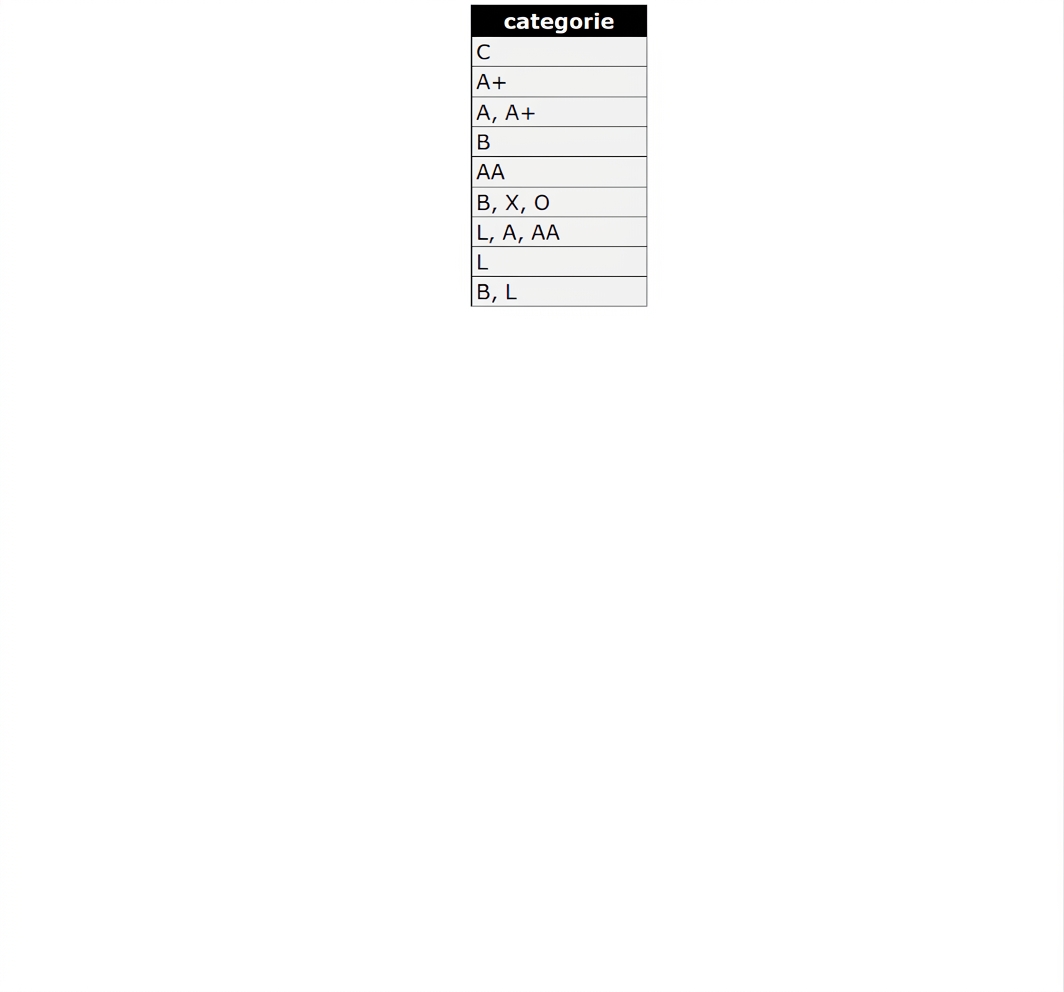
Lijst met categorieën

Introductie tot datamodellering in Snowflake

Snowflake-functies voor 1NF

  • TRIM
  • LATERAAL & FLATTEN
  • SPLIT
Introductie tot datamodellering in Snowflake

Snowflake-functies voor 1NF

  • TRIM: verwijdert spaties aan begin en einde van waarden
SELECT TRIM(category)
FROM allproducts;
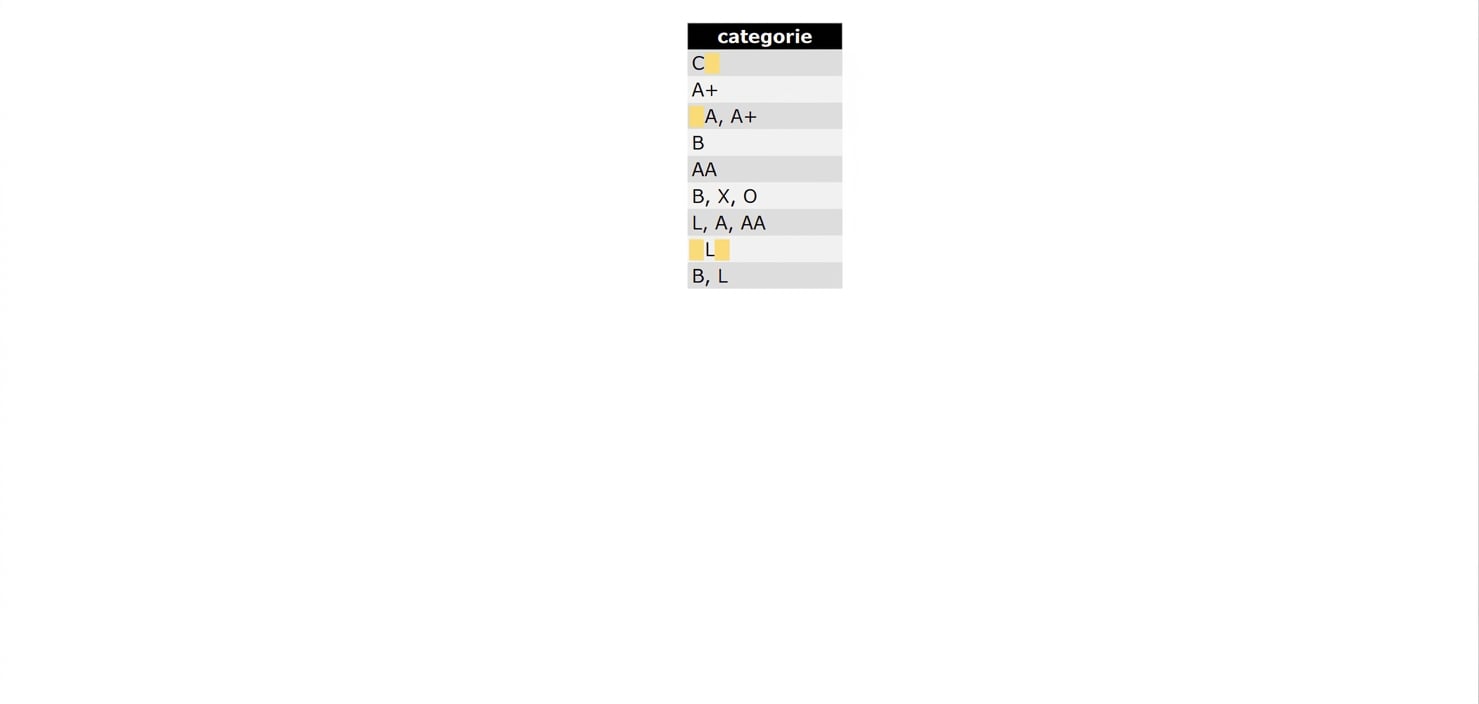
TRIM-functie op category

Introductie tot datamodellering in Snowflake

Snowflake-functies voor 1NF

  • TRIM: verwijdert spaties aan begin en einde van waarden.
  • LATERAAL & FLATTEN: behandel een lijst met waarden als een tabel met losse items.
  • SPLIT: splitst waarden op basis van een scheidingsteken.
SELECT TRIM(f.value)
FROM allproducts,
LATERAL FLATTEN(INPUT => SPLIT(allproducts.category, ',')) f;
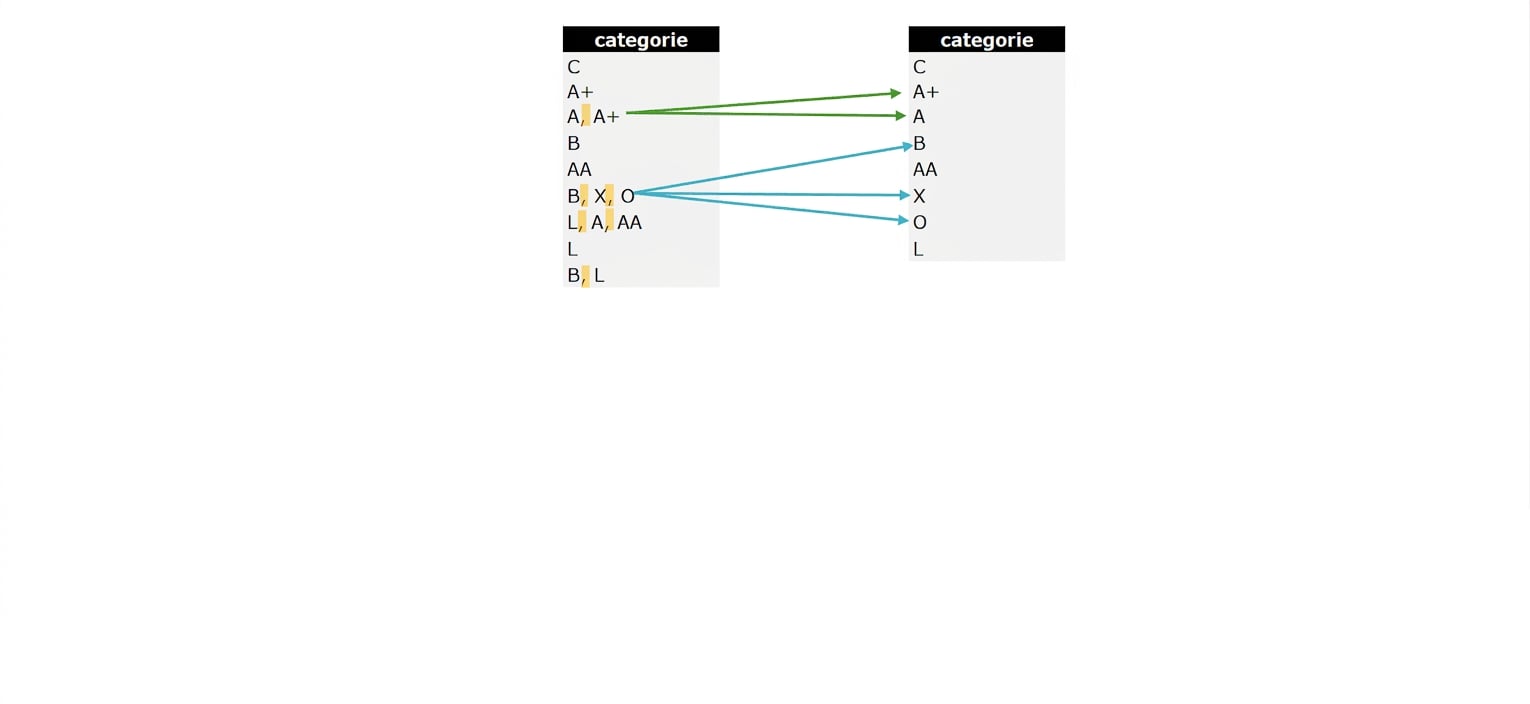
LATERAL, FLATTEN en SPLIT-functie op category

Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 1: maak een nieuwe entiteit om de UNF-attribuutwaarden naartoe te verplaatsen
CREATE OR REPLACE TABLE categories (
    category_id NUMBER(10,0) PRIMARY KEY,
    category VARCHAR(255)
);
Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 2.1: vul de nieuwe entiteit met data uit de aanvankelijk ongenormaliseerde entiteit
  • INSERT INTO: SQL-opdracht om nieuwe rijen in een tabel te voegen.
INSERT INTO categories (category_id, category)
___;
Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 2.2: selecteer de data uit allproducts, de aanvankelijk ongenormaliseerde entiteit
INSERT INTO categories (category_id, category)
SELECT 
    ___,
    ___
FROM allproducts;
Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 2.3: gebruik een functie om waarden binnen een attribuut te splitsen
INSERT INTO categories (category_id, category)
SELECT 
    ___, 
    TRIM(f.value)
FROM allproducts,
LATERAL FLATTEN(INPUT => SPLIT(allproducts.category, ',')) f;
Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 2.4: selecteer het rijnummer om een unieke identifier te definiëren
INSERT INTO categories (category_id, category)
SELECT 
    ROW_NUMBER() OVER (ORDER BY TRIM(f.value)), 
    TRIM(f.value)
FROM allproducts,
LATERAL FLATTEN(INPUT => SPLIT(allproducts.category, ',')) f;
Introductie tot datamodellering in Snowflake

1NF toepassen

  • Stap 2.4: aggregeer de data om unieke categoriewaarden te maken
INSERT INTO categories (category_id, category)
SELECT 
    ROW_NUMBER() OVER (ORDER BY TRIM(f.value)), 
    TRIM(f.value)
FROM allproducts,
LATERAL FLATTEN(INPUT => SPLIT(allproducts.category, ',')) f
GROUP BY TRIM(f.value);
Introductie tot datamodellering in Snowflake

Op weg naar datanormalisatie

All products-data, van UNF naar 1NF

Introductie tot datamodellering in Snowflake

Overzicht terminologie en functies

  • Datanormalisatie: proces om data te structureren en duplicatie en afhankelijkheid te minimaliseren
  • Normaalvormen: richtlijnen om datanormalisatie toe te passen
  • Eerste normaalvorm (1NF): zorgt dat elke kolom in een entiteit unieke atomaire waarden bevat
  • INSERT INTO: SQL-opdracht om nieuwe rijen in een tabel te voegen
  • TRIM: SQL-functie die spaties aan begin en einde van waarden verwijdert
  • LATERAL FLATTEN(INPUT => SPLIT()): Snowflake-functie om waarden in rijen te splitsen
  • ROW_NUMBER() OVER (ORDER BY): SQL-functie die een oplopend nummer genereert
  • GROUP BY: SQL-clausule om data met dezelfde waarden te aggregeren
Introductie tot datamodellering in Snowflake

Overzicht functies

-- Vul een entiteit met data uit een queryresultaat
INSERT INTO table_name (column_name, other_columns)
SELECT 
    -- Genereer een unieke waarde met het rijnummer
    ROW_NUMBER() OVER (ORDER BY TRIM(alias.value)),
    TRIM(alias.value)
FROM another_table,
-- Splits een tekstattribuut op basis van een scheidingsteken 
LATERAL FLATTEN(INPUT => SPLIT(another_table.column_name, 'delimiter_value'))alias
-- Aggregeer de data om uniekheid van waarden te borgen
GROUP BY TRIM(alias.value);
Introductie tot datamodellering in Snowflake

Laten we oefenen!

Introductie tot datamodellering in Snowflake

Preparing Video For Download...