Feature engineering

Machine Learning-modellen ontwikkelen voor productie

Sinan Ozdemir

Data Scientist and Author

Introductie tot feature engineering

  • Trainingsdata transformeren om ML-pijplijnprestaties te maximaliseren
  • Rekencomplexiteit verlagen
  • Voorbeelden
    • Data aggregeren uit meerdere bronnen
    • Nieuwe features construeren
    • Featuretransformaties toepassen

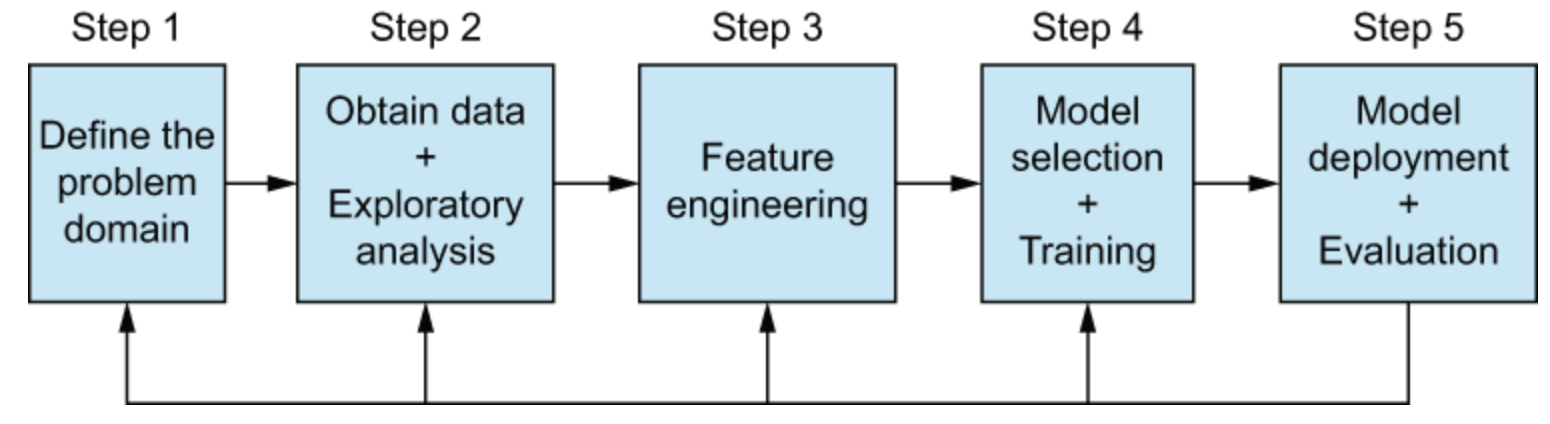
feature-engineeringpijplijn

1 https://www.manning.com/books/feature-engineering-bookcamp
Machine Learning-modellen ontwikkelen voor productie

Data aggregeren uit meerdere bronnen

  • Data combineren uit verschillende gegevenssets
  • Meerdere typen data gebruiken (bijv. numeriek en categorisch)

Dit helpt door:

  • De nauwkeurigheid van modellen te verbeteren
  • Complexere modellen mogelijk te maken

grafieken op een scherm

Machine Learning-modellen ontwikkelen voor productie

Voorbeeld van data-aggregatie

class DataAggregator:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self  # nothing to fit

    def transform(self, X, y=None):
        # Load data from multiple sources
        data1 = pd.read_csv('data1.csv')
        data2 = pd.read_csv('data2.csv')
        data3 = pd.read_csv('data3.csv')

        # Combine data from all sources (including X) into a single data frame
        aggregated_data = pd.concat([X, data1, data2, data3], axis=0)

        return aggregated_data  # Return aggregated data
Machine Learning-modellen ontwikkelen voor productie

Featureconstructie

  • Nieuwe features maken uit bestaande
  • Nieuwe features genereren uit al aanwezige data
  • Modelprestaties verbeteren
  • Interpretatie van het model verbeteren
Machine Learning-modellen ontwikkelen voor productie

Voorbeeld van featureconstructie

class FeatureConstructor:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self

    def transform(self, X, y=None):
        # Calculate the mean of each column in the data
        mean_values = X.mean()

        # Create new features based on the mean values
        X['mean_col1'] = X['col1'] - mean_values['col1']
        X['mean_col2'] = X['col2'] - mean_values['col2']

        return X  # Return the augmented data set
Machine Learning-modellen ontwikkelen voor productie

Featuretransformaties

Bestaande features ter plekke transformeren

  • Dataverdelingen normaliseren
  • Uitschieters verwijderen
  • Nauwkeurigheid en prestaties van het model verbeteren
```py
```py

Machine Learning-modellen ontwikkelen voor productie

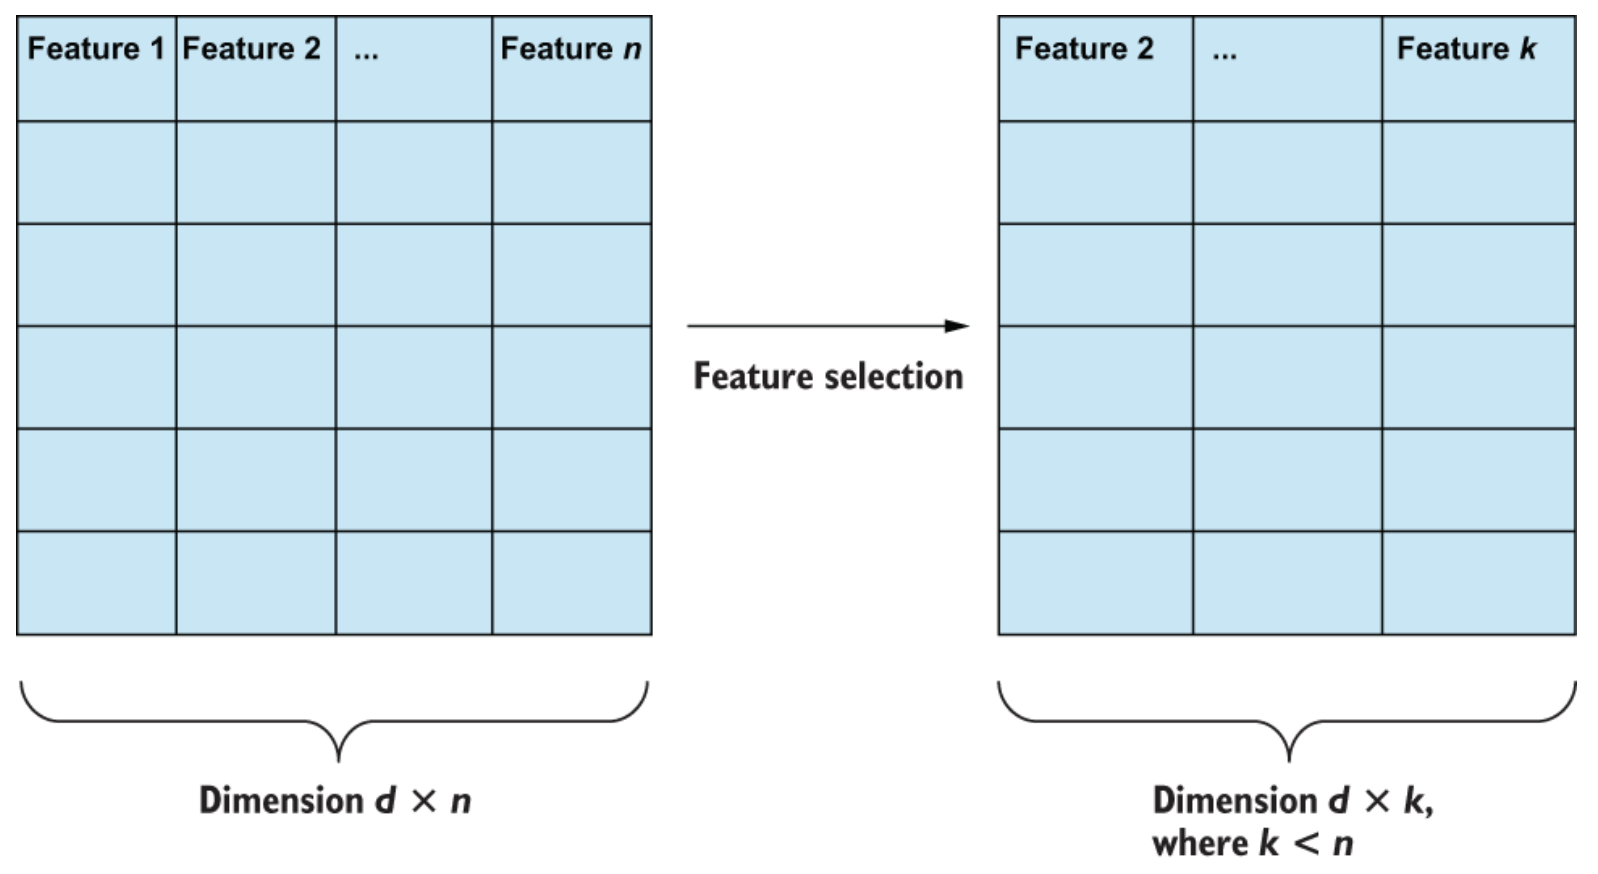
Featureselectie

Een subset features selecteren uit een grotere set door redundante en irrelevante features te verwijderen

  • Vermindert overfitting
  • Verbetert nauwkeurigheid en prestaties van het model
  • Verhoogt de uitlegbaarheid van het model

featureselectie

1 https://www.manning.com/books/feature-engineering-bookcamp
Machine Learning-modellen ontwikkelen voor productie

Voorbeeld van feature engineering (vervolg)

```py
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, chi2

from sklearn.pipeline import Pipeline

pipeline = Pipeline([  # Define feature engineering pipeline

    ('aggregate', DataAggregator()),  # Aggregate data from multiple sources
    ('construction', FeatureConstructor()),  # Feature Construction

    ('scaler', StandardScaler()),  # Feature Transformation

    ('select', SelectKBest(chi2, k=10)),  # Feature Selection
])
X_transformed = pipeline.fit_transform(X)  # Fit and transform data using pipeline
Machine Learning-modellen ontwikkelen voor productie

Meer leren over feature engineering

fe-boek

Machine Learning-modellen ontwikkelen voor productie

Laten we oefenen!

Machine Learning-modellen ontwikkelen voor productie

Preparing Video For Download...