Verzamelingen GRanges bewerken
Introductie tot Bioconductor in R

Paula Andrea Martinez, PhD.
Data Scientist
GRangesList
- De
GRangesList-classis een container voor een verzamelingGRanges- Efficiënt voor veel elementen opslaan.
- Zo maak je een
GRangesListas(mylist, "GRangesList")GRangesList(myGranges1, myGRanges2, ...)
- Terugzetten naar
GRangesunlist(myGRangesList)
- Toegangen
methods(class = "GRangesList")
Wanneer lijsten gebruiken?
- Meerdere GRanges-objecten kun je combineren tot een GRangesList
- GRanges in een lijst gelden als samengestelde kenmerken van een groter object
- Voorbeelden van GRangesLists zijn
- transcripten per gen
- exonen per transcript
- read-alignments
- schuivende vensters
# GRanges-object met 983 genen hg_chrXslidingWindows(hg_chrX, width = 20000, step = 10000)
# slechts twee elementen van de lijst getoond
GRangesList object van lengte 983:
[[1]]
GRanges object met 2 ranges en 0 metadatakolommen:
       seqnames           ranges strand
         <Rle>        <IRanges>  <Rle>
  [1]     chrX [276322, 296321]      +
  [2]     chrX [286322, 303356]      +
[[2]]
GRanges object met 3 ranges en 0 metadatakolommen:
       seqnames           ranges strand
  [1]     chrX [624344, 644343]      +
  [2]     chrX [634344, 654343]      +
  [3]     chrX [644344, 659411]      +
...
GenomicFeatures gebruikt transcriptdatabase- (TxDb-)objecten om metadata op te slaan, genoomlocaties en relaties tussen kenmerken en hun id's te beheren.
library(TxDb.Hsapiens.UCSC.hg38.knownGene)
(hg <- TxDb.Hsapiens.UCSC.hg38.knownGene)
Db type: TxDb
Supporting package: GenomicFeatures
Data source: UCSC
Genome: hg38
Organism: Homo sapiens
Taxonomy ID: 9606
Resource URL: http://genome.ucsc.edu/
Type of Gene ID: Entrez Gene ID
transcript_nrow: 197782
exon_nrow: 581036
cds_nrow: 293052
Db created by: GenomicFeatures package from Bioconductor
Creation time: 2016-09-29 13:02:09 +0000 (Thu, 29 Sep 2016)
Genen, transcripten, exonen
library(TxDb.Hsapiens.UCSC.hg38.knownGene) hg <- TxDb.Hsapiens.UCSC.hg38.knownGene # hg is een TxDb-objectseqlevels(hg) <- c("chrX") # vooraf filteren op chrX# transcripts transcripts(hg, columns = c("tx_id", "tx_name"), filter = NULL) # exons exons(hg, columns = c("tx_id", "exon_id"), filter = list(tx_id = "179161"))
columns en filter kunnen NULL zijn of een van deze:
"gene_id", "tx_id", "tx_name", "tx_chrom", "tx_strand",
"exon_id", "exon_name", "exon_chrom", "exon_strand",
"cds_id", "cds_name", "cds_chrom", "cds_strand" and "exon_rank"
Exonen per transcript
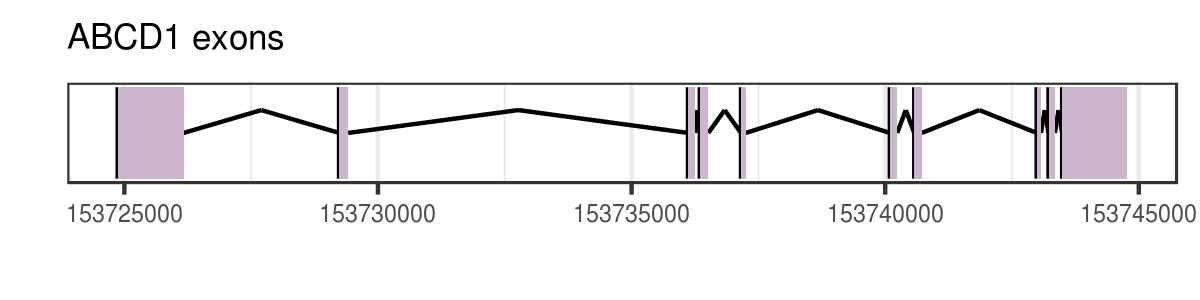
hg <- TxDb.Hsapiens.UCSC.hg38.knownGene seqlevels(hg) <- c("chrX") # vooraf filteren op chromosoom X exonsBytx <- exonsBy(hg, by = "tx") # exonen per transcriptabcd1_179161 <- exonsBytx[["179161"]] # transcript-idwidth(abcd1_179161) # breedte per exon, de paarse delen in de figuur
1299 181 143 169 95 146 146 85 126 1274
Overlaps
# countOverlaps geeft een integer-vecor met aantallen
countOverlaps(query, subject)

# findOverlaps geeft een Hits-object
findOverlaps(query, subject)

# subsetByOverlaps retourneert een GRangesList-object
subsetByOverlaps(query, subject)
- Query en subject zijn GRanges- of GRangesList-objecten.
- Overlaps kunnen volledig of gedeeltelijk zijn.
Nu ben jij aan de beurt om te oefenen!
Introductie tot Bioconductor in R

