Rate limiting

AI in productie brengen met FastAPI

Matt Eckerle

Software and Data Engineering Leader

Introductie van rate limiting
een verkeerslicht


  • Doel: Bepaalt hoe vaak je API-verzoeken mag doen.
  • Respons: Geeft HTTP 429 ("Too Many Requests") als je de limiet overschrijdt.
AI in productie brengen met FastAPI

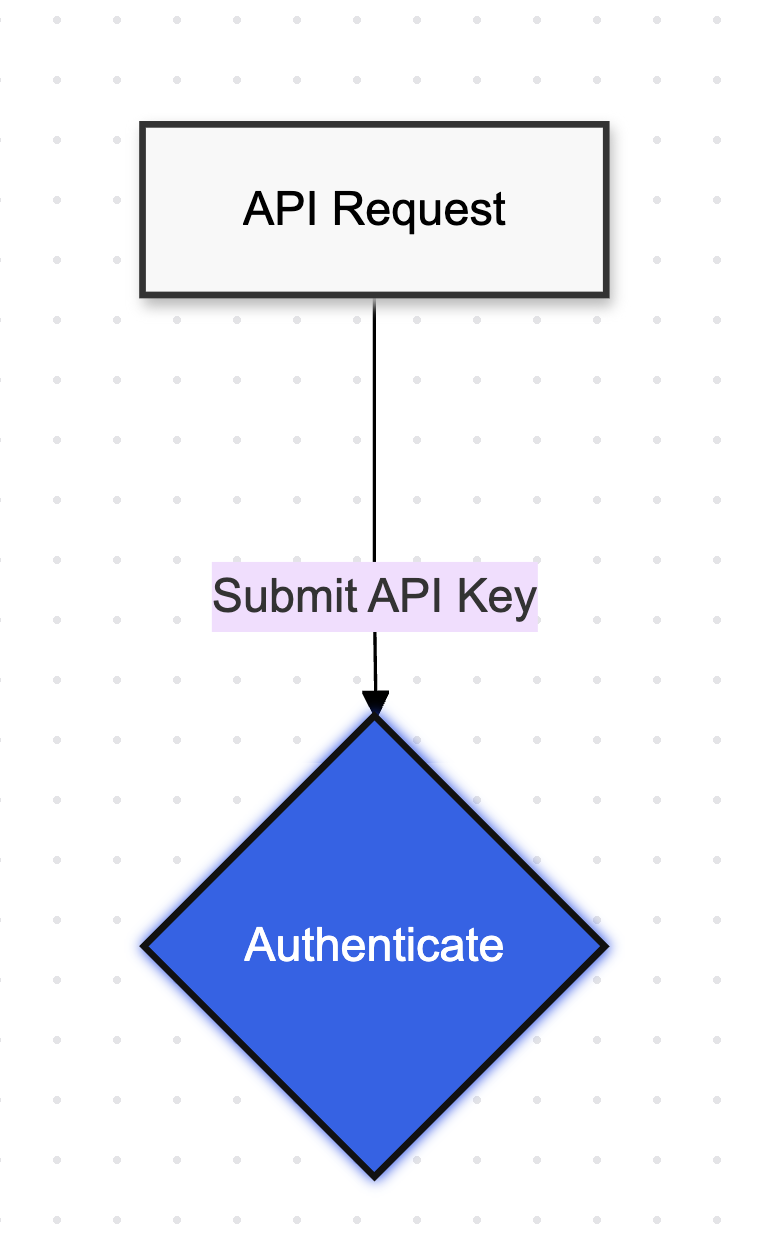
Hoe rate limiting werkt

Deel 1 van het stroomdiagram dat rate limiting uitlegt

AI in productie brengen met FastAPI

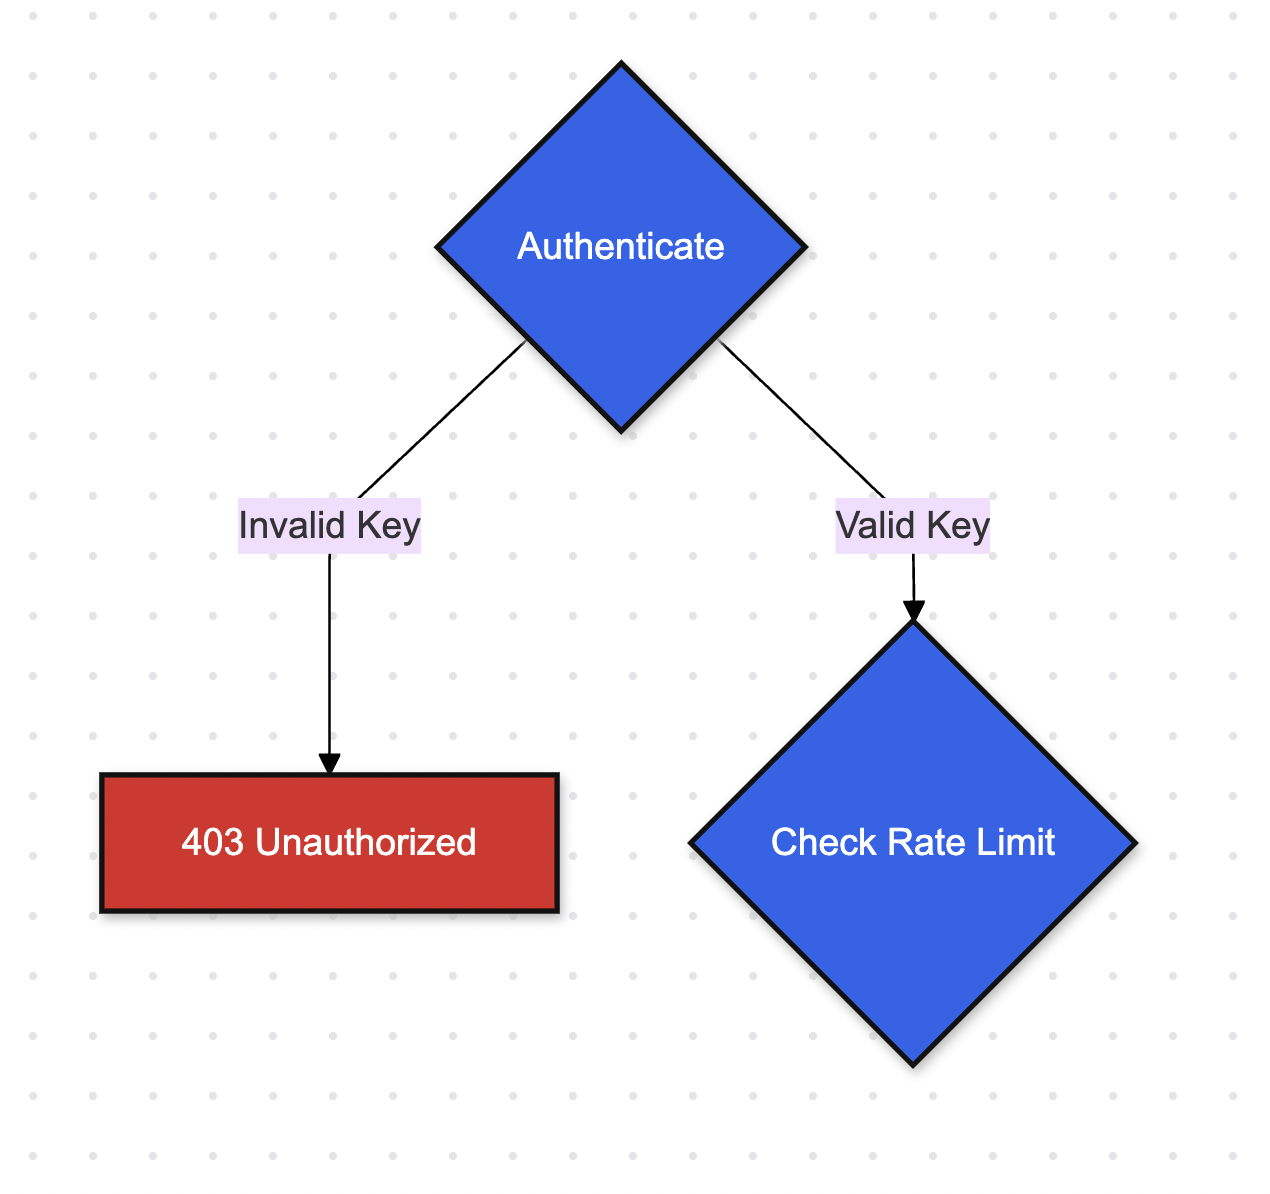
Binnenkomende credentials verifiëren

Deel 2 van het stroomdiagram dat rate limiting uitlegt

AI in productie brengen met FastAPI

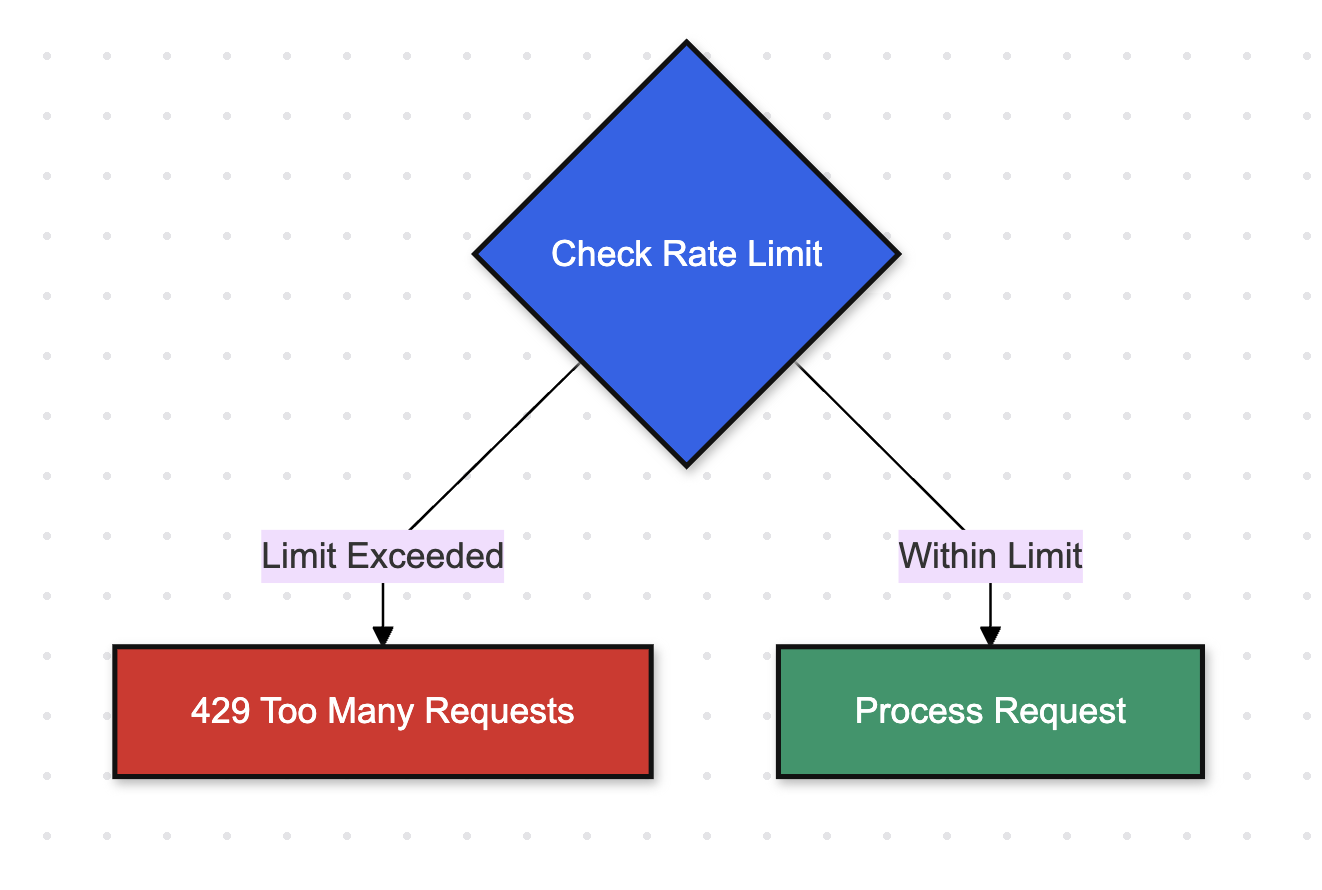
Rate-limitingcontrole

Deel 3 van het stroomdiagram dat rate limiting uitlegt

AI in productie brengen met FastAPI

Onze API instellen

from fastapi import FastAPI, Depends, HTTPException
from fastapi.security import APIKeyHeader
from pydantic import BaseModel

app = FastAPI()
model = SentimentAnalyzer(pkl_file_path)

API_KEY_HEADER = APIKeyHeader(name="X-API-Key")
API_KEY = "your-secret-key"
AI in productie brengen met FastAPI

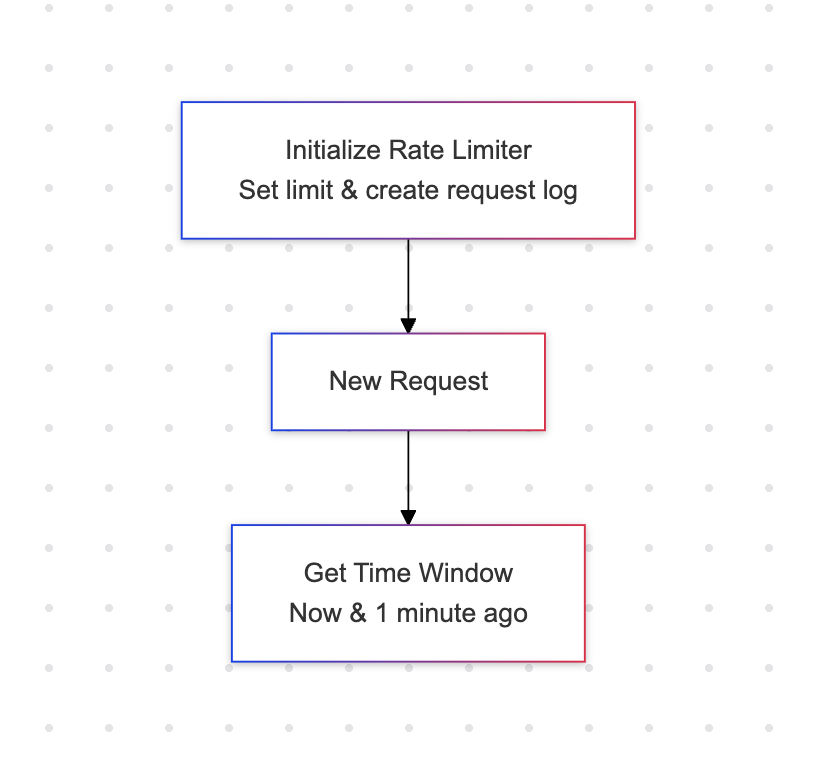
De rate-limiterlogica

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:

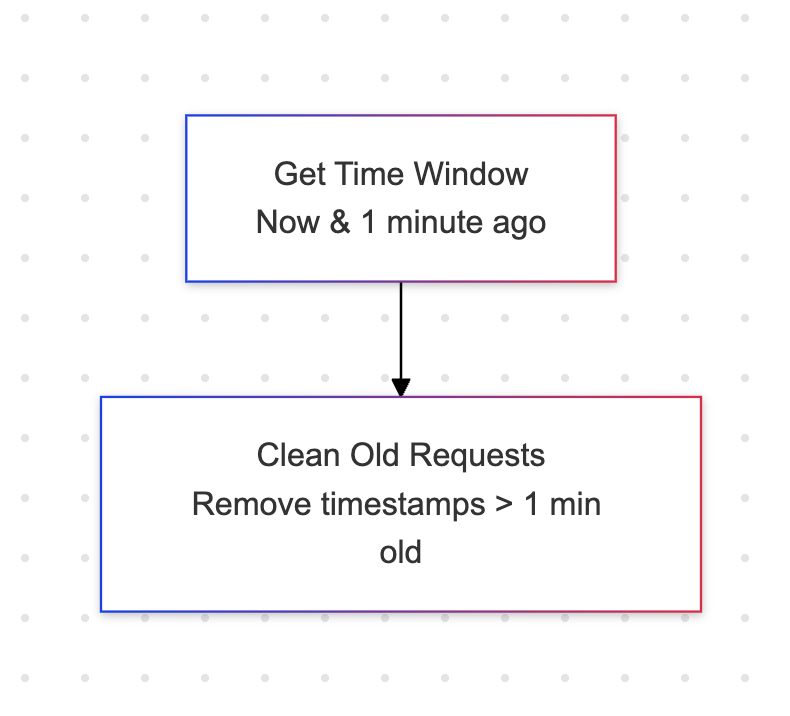
Deel 1 van het stroomdiagram van de logica achter het implementeren van rate limiting

AI in productie brengen met FastAPI

Oude verzoeken verwijderen

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:
now = datetime.now() minute_ago = now - timedelta(minutes=1) self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]

Deel 2 van het stroomdiagram dat rate limiting uitlegt

AI in productie brengen met FastAPI

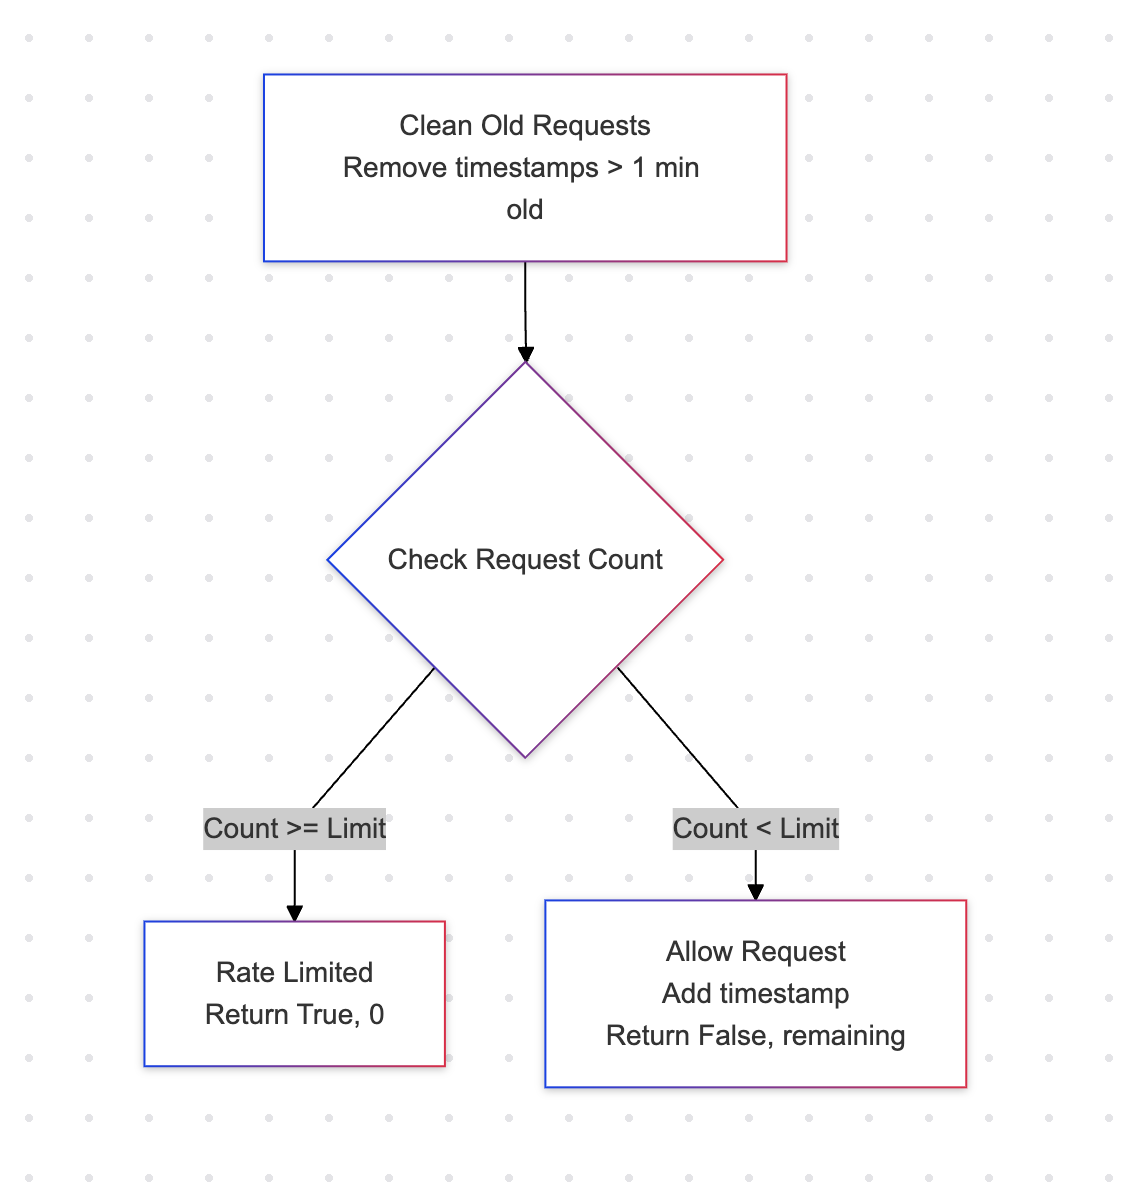
Aantal verzoeken controleren

    def is_rate_limited(self, api_key: str) -> 
  tuple[bool, int]:
        now = datetime.now()
        minute_ago = now - timedelta(minutes=1)

self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]
recent_requests = len(self.requests[api_key]) if recent_requests >= self.requests_per_min: return True, 0 self.requests[api_key].append(now) return False

Een diagram dat de controle weergeeft van het aantal verzoeken door de API: als het aantal boven of gelijk aan de limiet is, retourneer true, anders false.

AI in productie brengen met FastAPI

Controle op rate limit toevoegen

rate_limiter = RateLimiter(requests_per_minute=10)

def test_api_key(api_key: str = Depends(API_KEY_HEADER)): if api_key != API_KEY: raise HTTPException( status_code=403, detail="Invalid API key" ) is_limited, _ = rate_limiter.is_rate_limited(api_key) if is_limited: raise HTTPException( status_code=429, detail="Rate limit exceeded. Please try again later." ) return api_key
AI in productie brengen met FastAPI

Rate limit toepassen op endpoint

@app.post("/predict")
def predict_sentiment(
    request: SentimentRequest,
    api_key: str = Depends(test_api_key)
):
    result = sentiment_model(request.text)

    _, requests_remaining = 
           rate_limiter.is_rate_limited(api_key)

    return {
        "text": request.text,
        "sentiment": result[0]["label"].lower(),
        "confidence": result[0]["score"],
        "requests_remaining": requests_remaining
    }

Verstuur 11 keer een verzoek:

curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -H "X-API-Key: your-secret-key" \
     -d '{"text": "I love this product"}'

Output:

{"detail":"Rate limit overschreden. 
           Probeer het later opnieuw."}
AI in productie brengen met FastAPI

Laten we oefenen!

AI in productie brengen met FastAPI

Preparing Video For Download...