Menghapus Data

Rekayasa Fitur dengan PySpark

John Hogue

Lead Data Scientist, General Mills

Di mana data bisa bermasalah?
  • {{1}} salah tercatat
  • Kejadian unik
  • Salah format
  • Duplikasi
  • Hilang
  • Tidak relevan

Domino

Rekayasa Fitur dengan PySpark

Menghapus Kolom

df.select(['NO', 'UNITNUMBER', 'CLASS']).show()
+----+----------+-----+
|  NO|UNITNUMBER|CLASS|
+----+----------+-----+
|   1|      null|   SF|
| 156|        A8|   SF|
| 157|       207|   SF|
| 158|      701G|   SF|
| 159|        36|   SF|

Beberapa field tidak diperlukan untuk analisis kita

  • 'NO' nomor rekaman otomatis
  • 'UNITNUMBER' data tidak relevan
  • 'CLASS' nilainya konstan
Rekayasa Fitur dengan PySpark

Menghapus Kolom

drop(*cols)

  • *cols – nama kolom atau daftar nama kolom yang akan dihapus.
  • Mengembalikan DataFrame baru dengan kolom yang ditentukan dihapus
# Daftar kolom yang akan dihapus
cols_to_drop = ['NO', 'UNITNUMBER', 'CLASS']

# Hapus kolom df = df.drop(*cols_to_drop)
Rekayasa Fitur dengan PySpark

Penyaringan Teks

  • where(condition)
    • condition – sebuah Column bertipe types.BooleanType atau string ekspresi SQL.
    • Memfilter DataFrame saat kondisi bernilai true
  • like(other)
    • other – pola SQL LIKE
    • Mengembalikan Column boolean
  • ~
    • Operator NOT
df = df.where(~df['POTENTIALSHORTSALE'].like('Not Disclosed'))
Rekayasa Fitur dengan PySpark

Penyaringan Pencilan

Saring data dalam tiga simpangan baku (3σ) dari mean (μ)
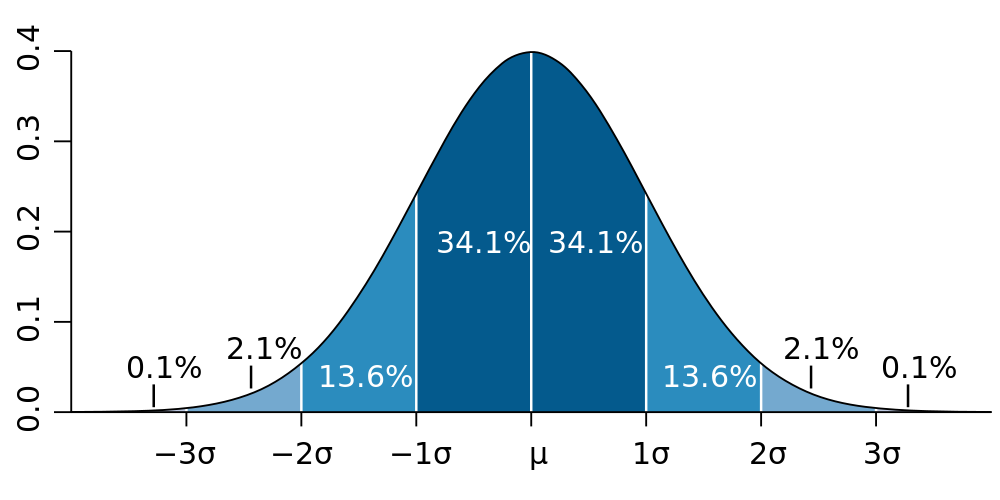
Distribusi Normal Standar

Rekayasa Fitur dengan PySpark

Contoh Penyaringan Nilai

# Hitung nilai untuk penyaringan
std_val = df.agg({'SALESCLOSEPRICE': 'stddev'}).collect()[0][0]
mean_val = df.agg({'SALESCLOSEPRICE': 'mean'}).collect()[0][0]

# Buat batas atas dan bawah tiga simpangan baku (μ ± 3σ) hi_bound = mean_val + (3 * std_val) low_bound = mean_val - (3 * std_val)
# Gunakan where() untuk memfilter DataFrame di antara nilai batas df = df.where((df['LISTPRICE'] < hi_bound) & (df['LISTPRICE'] > low_bound))
Rekayasa Fitur dengan PySpark

Menghapus NA atau NULL

DataFrame.dropna()

  • how: 'any' atau 'all'. Jika 'any', hapus rekaman yang memiliki nilai null apa pun. Jika 'all', hapus hanya jika semua nilainya null.
  • thresh: int, default None. Jika ditentukan, hapus rekaman yang memiliki kurang dari thresh nilai non-null. Ini menimpa parameter how.
  • subset: daftar opsional nama kolom yang dipertimbangkan.
Rekayasa Fitur dengan PySpark

Menghapus NA atau NULL

# Hapus rekaman mana pun dengan nilai NULL
df = df.dropna()

# Hapus rekaman jika LISTPRICE dan SALESCLOSEPRICE keduanya NULL df = df.dropna(how='all', subset['LISTPRICE', 'SALESCLOSEPRICE '])
# Hapus rekaman jika setidaknya dua kolom bernilai NULL df = df.dropna(thresh=2)
Rekayasa Fitur dengan PySpark

Menghapus Duplikasi

Apa itu duplikat?

  • Dua atau lebih rekaman berisi informasi yang sama persis
  • Setelah menghapus kolom atau menggabungkan himpunan data, periksa duplikat

dropDuplicates()

  • Dapat dijalankan untuk seluruh DataFrame atau daftar kolom
  • Di PySpark tidak ada urutan untuk rekaman yang dihapus
# Seluruh DataFrame
df.dropDuplicates()

# Periksa hanya daftar kolom df.dropDuplicates(['streetaddress'])
Rekayasa Fitur dengan PySpark

Ayo berlatih!

Rekayasa Fitur dengan PySpark

Preparing Video For Download...