Feature engineering

Sviluppare modelli di Machine Learning per la produzione

Sinan Ozdemir

Data Scientist and Author

Introduzione al feature engineering

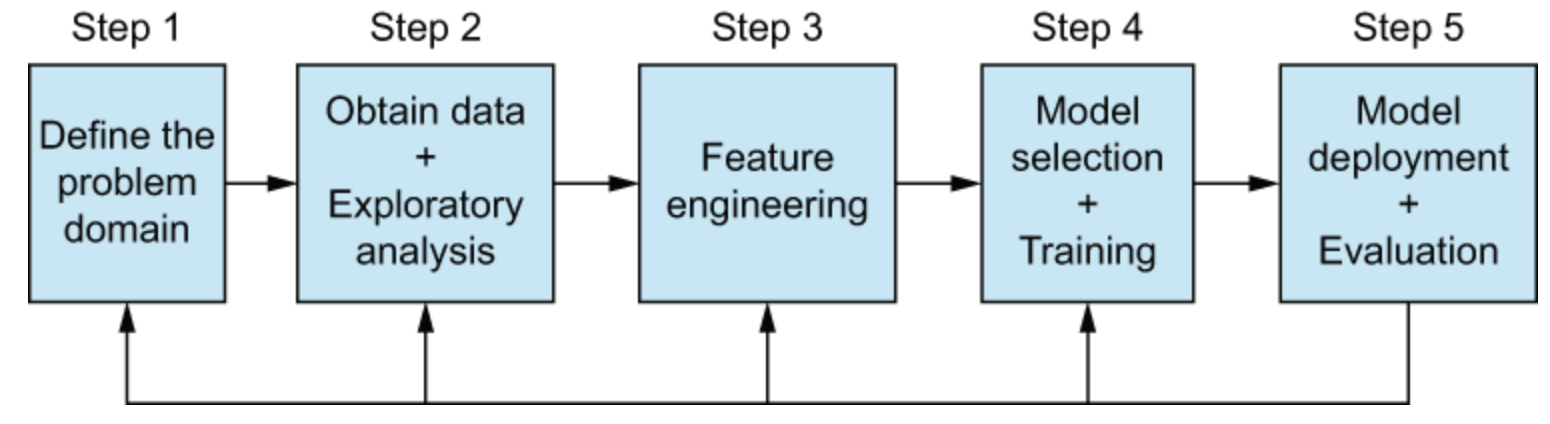
  • Trasformare i dati di training per massimizzare le prestazioni della pipeline di ML
  • Ridurre la complessità computazionale
  • Esempi
    • Aggregare dati da più fonti
    • Costruire nuove feature
    • Applicare trasformazioni alle feature

pipeline di feature engineering

1 https://www.manning.com/books/feature-engineering-bookcamp
Sviluppare modelli di Machine Learning per la produzione

Aggregare dati da più fonti

  • Combinare dati da insiemi di dati diversi
  • Usare tipi di dati multipli (es. numerici e categorici)

Questo aiuta a:

  • Migliorare l'accuratezza dei modelli
  • Abilitare modelli più complessi

grafici su uno schermo

Sviluppare modelli di Machine Learning per la produzione

Esempio di aggregazione dei dati

class DataAggregator:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self  # nothing to fit

    def transform(self, X, y=None):
        # Load data from multiple sources
        data1 = pd.read_csv('data1.csv')
        data2 = pd.read_csv('data2.csv')
        data3 = pd.read_csv('data3.csv')

        # Combine data from all sources (including X) into a single data frame
        aggregated_data = pd.concat([X, data1, data2, data3], axis=0)

        return aggregated_data  # Return aggregated data
Sviluppare modelli di Machine Learning per la produzione

Costruzione di feature

  • Creare nuove feature da quelle esistenti
  • Generare nuove feature da dati preesistenti
  • Migliorare le prestazioni del modello
  • Aumentare l'interpretabilità del modello
Sviluppare modelli di Machine Learning per la produzione

Esempio di costruzione di feature

class FeatureConstructor:
    def __init__(self):
        pass

    def fit(self, X, y=None):
        return self

    def transform(self, X, y=None):
        # Calculate the mean of each column in the data
        mean_values = X.mean()

        # Create new features based on the mean values
        X['mean_col1'] = X['col1'] - mean_values['col1']
        X['mean_col2'] = X['col2'] - mean_values['col2']

        return X  # Return the augmented data set
Sviluppare modelli di Machine Learning per la produzione

Trasformazioni delle feature

Trasformare le feature esistenti in-place

  • Normalizzare le distribuzioni dei dati
  • Rimuovere gli outlier
  • Migliorare accuratezza e prestazioni del modello
```py
```py

Sviluppare modelli di Machine Learning per la produzione

Selezione delle feature

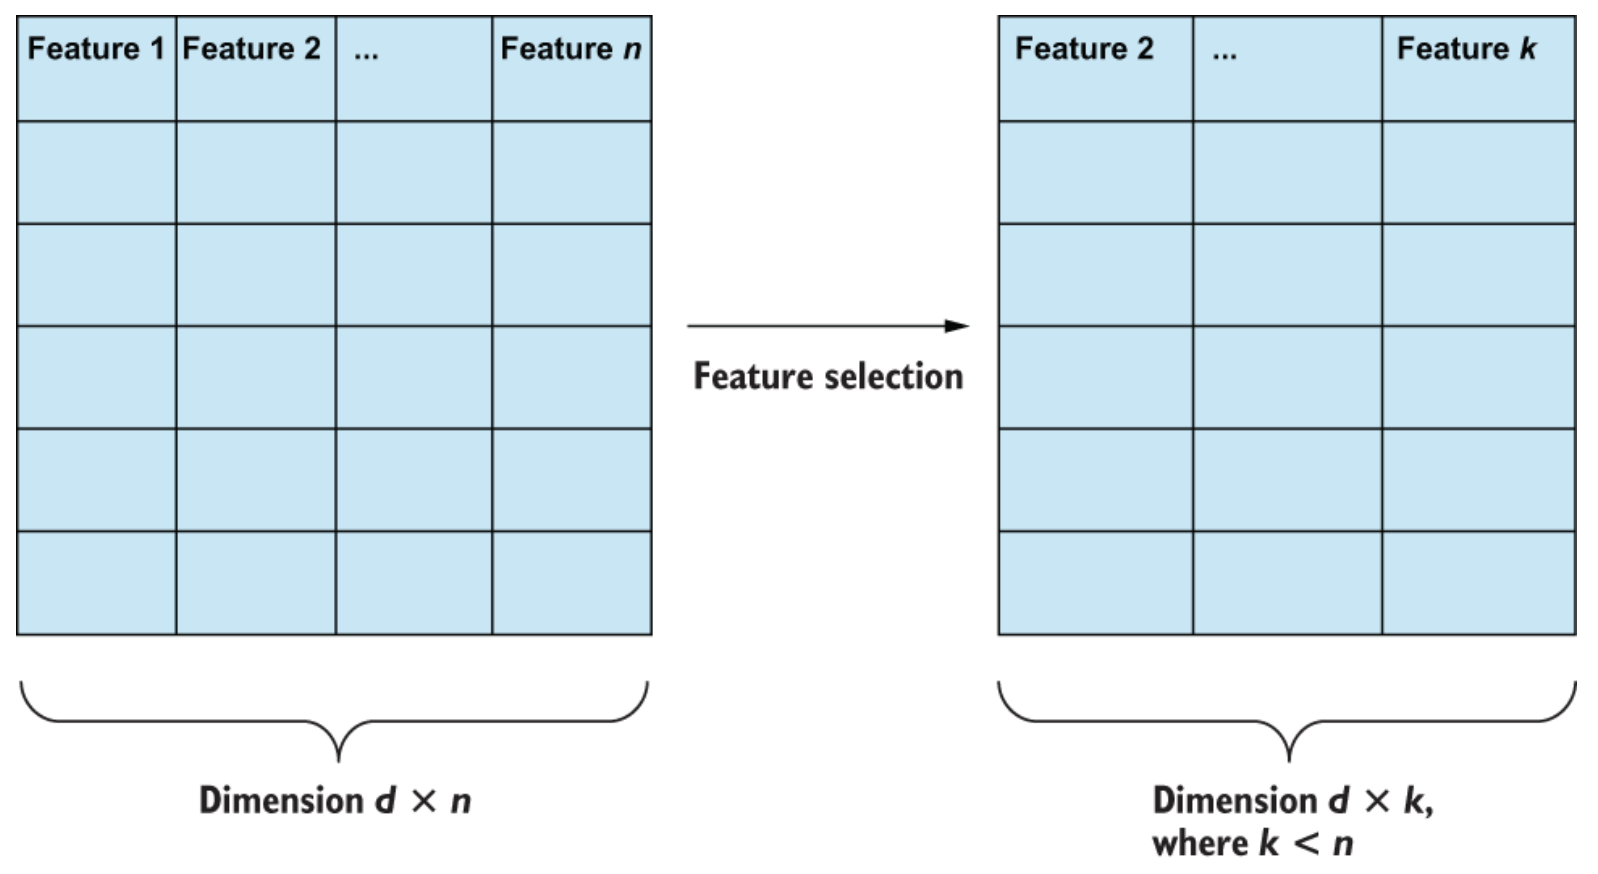
Selezionare un sottoinsieme di feature da un insieme più ampio rimuovendo quelle ridondanti e irrilevanti

  • Riduce l'overfitting
  • Migliora accuratezza e prestazioni del modello
  • Migliora l'interpretabilità del modello

selezione delle feature

1 https://www.manning.com/books/feature-engineering-bookcamp
Sviluppare modelli di Machine Learning per la produzione

Esempio di feature engineering (cont.)

```py
import pandas as pd
from sklearn.preprocessing import StandardScaler
from sklearn.feature_selection import SelectKBest, chi2

from sklearn.pipeline import Pipeline

pipeline = Pipeline([  # Define feature engineering pipeline

    ('aggregate', DataAggregator()),  # Aggregate data from multiple sources
    ('construction', FeatureConstructor()),  # Feature Construction

    ('scaler', StandardScaler()),  # Feature Transformation

    ('select', SelectKBest(chi2, k=10)),  # Feature Selection
])
X_transformed = pipeline.fit_transform(X)  # Fit and transform data using pipeline
Sviluppare modelli di Machine Learning per la produzione

Approfondisci il feature engineering

libro sul FE

Sviluppare modelli di Machine Learning per la produzione

Esercitiamoci!

Sviluppare modelli di Machine Learning per la produzione

Preparing Video For Download...