Inferenza per dati numerici in R
Mine Cetinkaya-Rundel
Associate Professor of the Practice, Duke University
$H_0$: Il punteggio medio di vocabolario è lo stesso in tutte le classi sociali, $\mu_{lower} = \mu_{working} = \mu_{middle} = \mu_{upper}$.
$H_A$: I punteggi medi di vocabolario differiscono in almeno una coppia di classi sociali.
Variabilità totale nel punteggio di vocabolario:
library(broom)
aov(wordsum ~ class, gss) %>%
tidy()
term df sumsq meansq statistic p.value
class 3 236.5644 78.854810 21.73467 0
Residuals 791 2869.8003 3.628066 NA NA
term df sumsq meansq statistic p.value
class 3 236.5644 78.854810 21.73467 0
Residuals 791 2869.8003 3.628066 NA NA
term df sumsq meansq statistic p.value
class 3 236.5644 78.854810 21.73467 0
Residuals 791 2869.8003 3.628066 NA NA
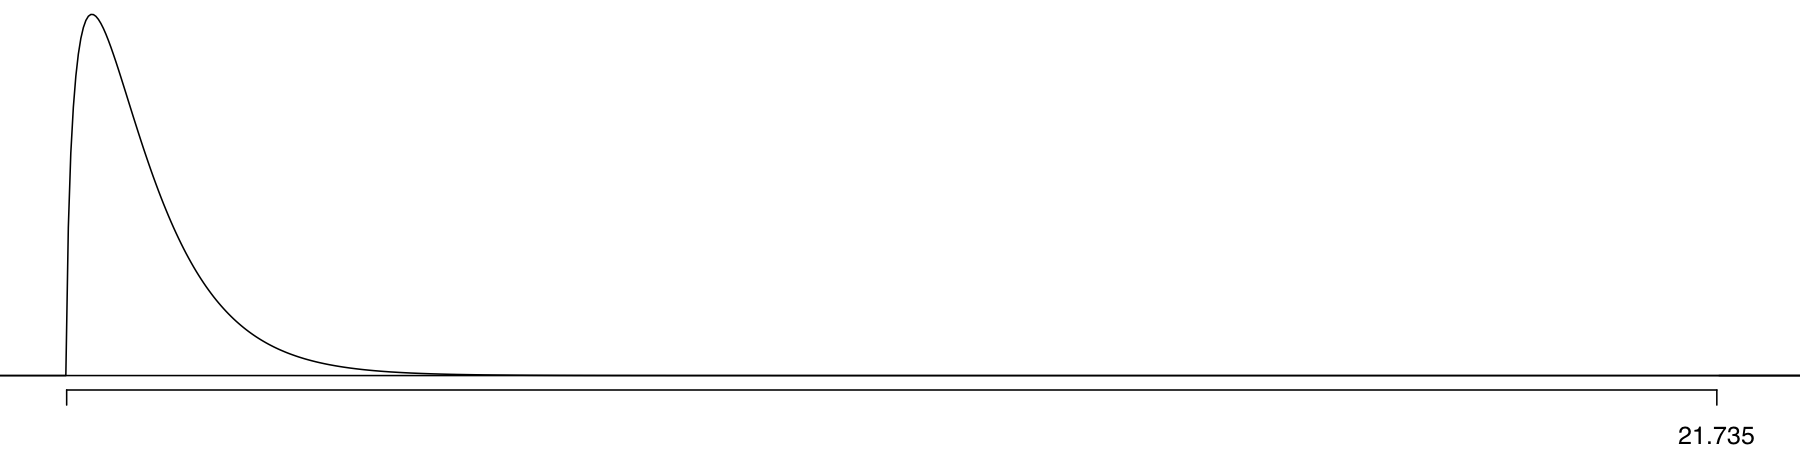
Statistica F = 21.73467 = $\frac{between~group~var}{within~group~var}$
Inferenza per dati numerici in R