Inferenza per dati numerici in R
Mine Cetinkaya-Rundel
Associate Professor of the Practice, Duke University
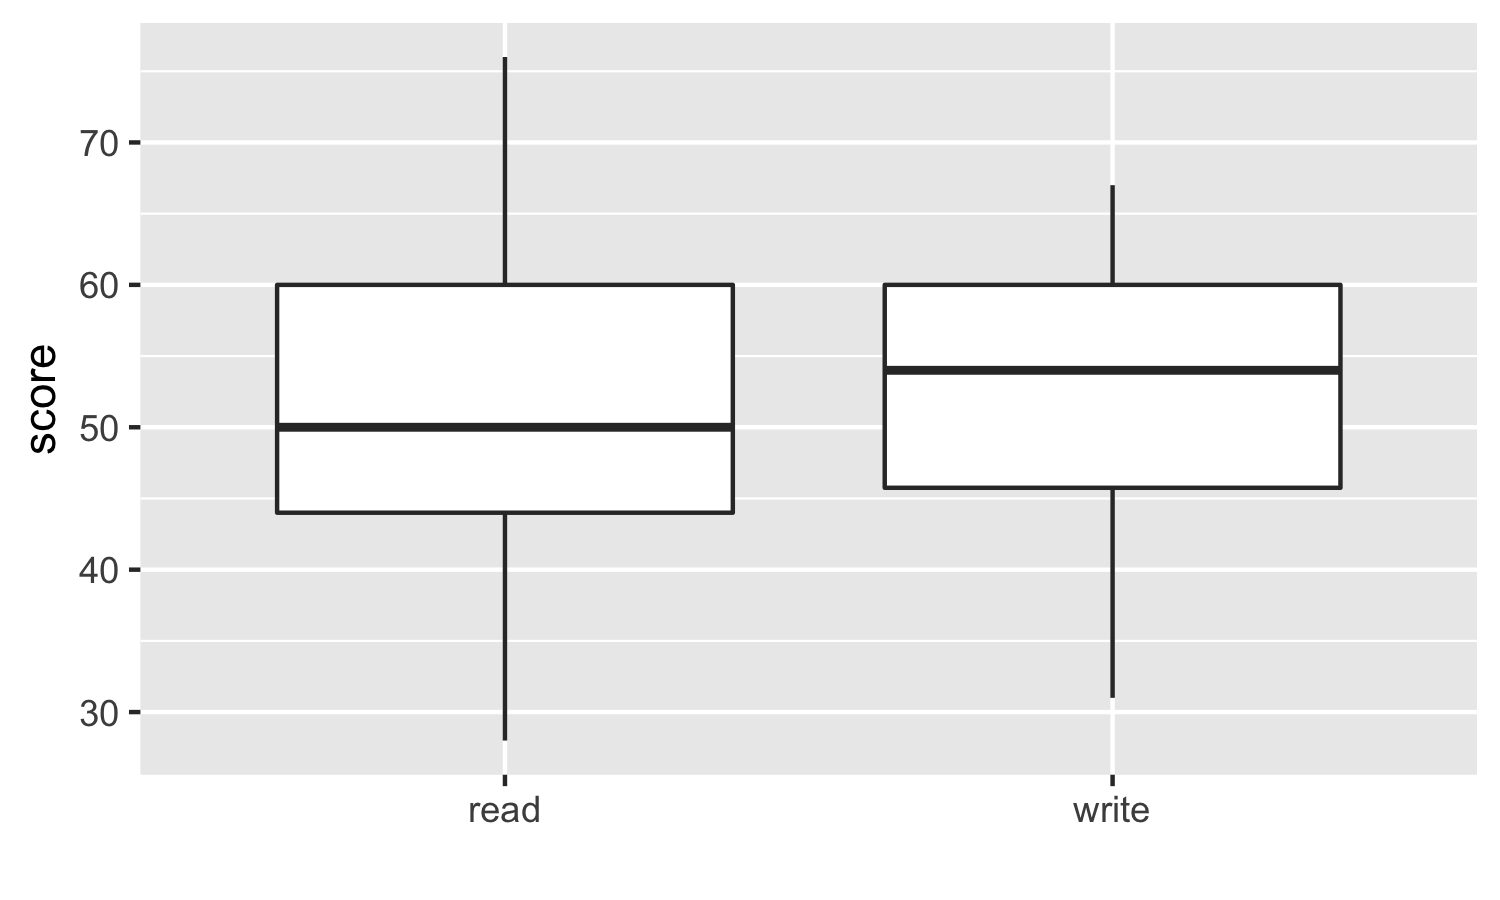
200 osservazioni sono state campionate a caso dal sondaggio High School and Beyond. Gli stessi studenti hanno sostenuto un test di lettura e uno di scrittura. A prima vista, in cosa le distribuzioni dei punteggi di lettura e scrittura sono simili? E in cosa differiscono?

I punteggi di lettura e scrittura per uno stesso studente possono essere considerati indipendenti?
Probabilmente no!
Quando due insiemi di osservazioni hanno questa corrispondenza speciale (non indipendenti), si dicono appaiati.
Per analizzare dati appaiati, è spesso utile guardare alla differenza degli esiti per ogni coppia di osservazioni:
diff = read − write.
| student | read | write | diff |
|---|---|---|---|
| 1 | 57 | 52 | 5 |
| 2 | 68 | 59 | 9 |
| 3 | 44 | 33 | 11 |
| ... | ... | ... | ... |
| 200 | 63 | 65 | -2 |
Costruisci un intervallo di confidenza al 95% per la differenza media tra i punteggi medi di lettura e scrittura.
t.test(hsb2$diff, conf.level = 0.95)
Costruisci un intervallo di confidenza al 95% per la differenza media tra i punteggi medi di lettura e scrittura.
t.test(hsb2$diff, conf.level = 0.95)
One Sample t-test
data: hsb2$diff
t = -0.86731, df = 199, p-value = 0.3868
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
-1.7841424 0.6941424
sample estimates:
mean of x
-0.545
L'IC al 95% per la differenza media dei punteggi di lettura e scrittura (read - write) è (-1,78; 0,69)
vs.
Siamo al 95% confidenti che il punteggio medio di lettura sia da 1,78 punti inferiore a 0,69 punti superiore rispetto al punteggio medio di scrittura.
Inferenza per dati numerici in R