Monitorare e gestire la memoria

Programmazione parallela in R

Nabeel Imam

Data Scientist

La coda e lo spazio
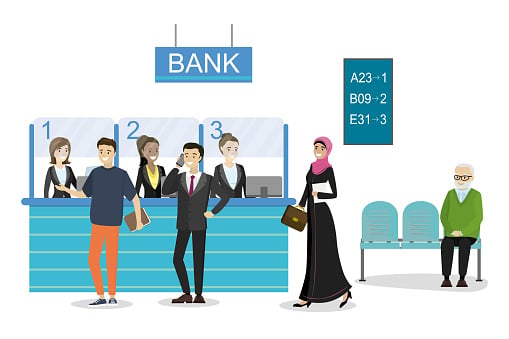
Tre sportelli servono clienti in banca, mentre altri attendono il loro turno.

Programmazione parallela in R

Il flusso parallelo

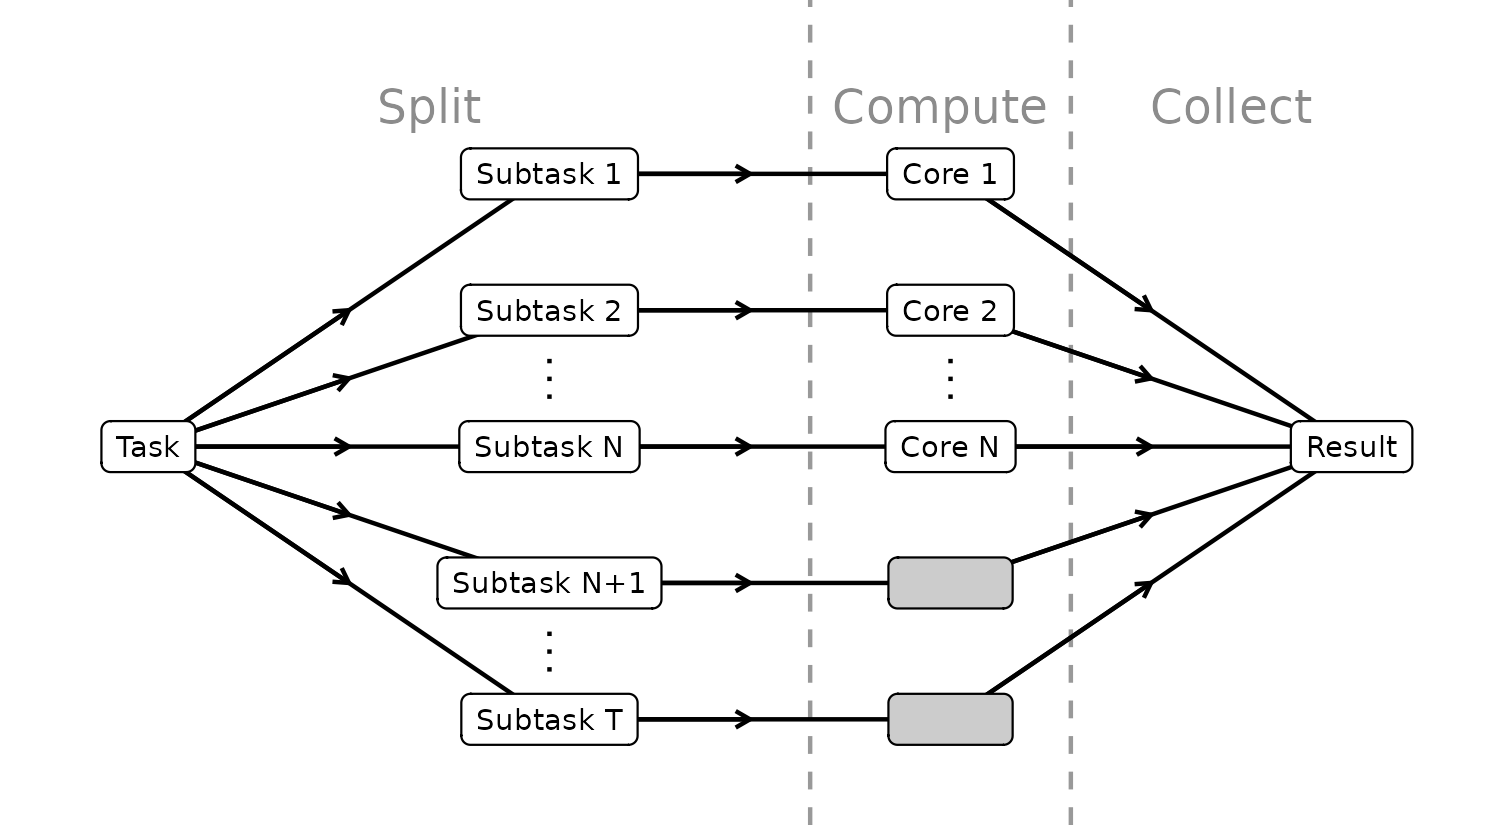
Un flusso parallelo: un'attività è divisa in sotto-attività svolte da core diversi; i risultati vengono combinati.

Programmazione parallela in R

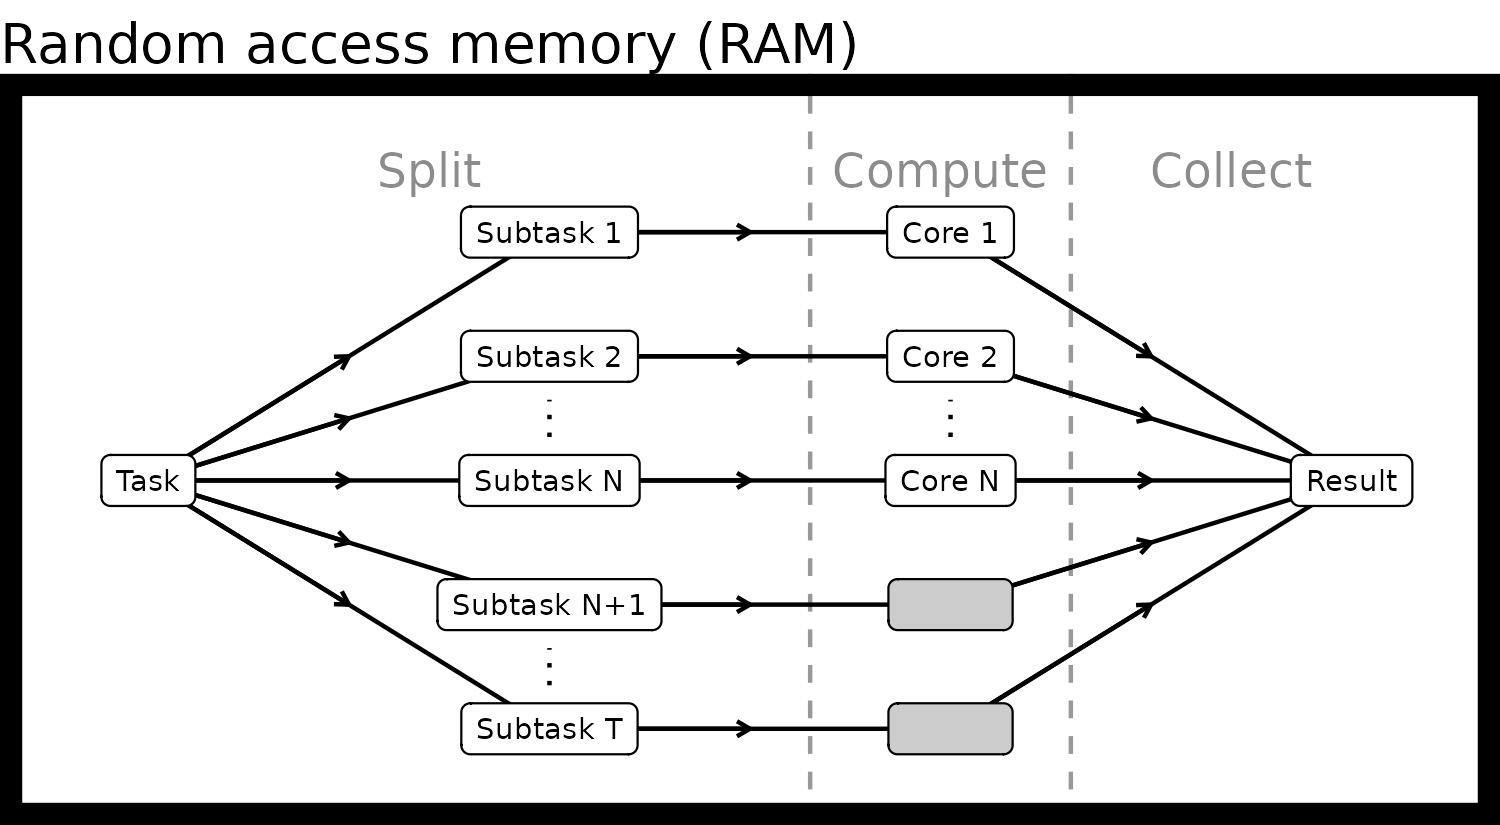
Il flusso parallelo

Il flusso parallelo è eseguito all'interno della memoria ad accesso casuale.
Programmazione parallela in R

I dati sulle nascite

print(ls_files)
 [1] "./births/AK.csv"
 [2] "./births/AL.csv"
 [3] "./births/AR.csv"
 [4] "./births/AZ.csv"
 [5] "./births/CA.csv"
 [6] "./births/CO.csv"
 [7] "./births/CT.csv"
 [8] "./births/DC.csv"
 [9] "./births/DE.csv"
 [10] "./births/FL.csv"
...
Programmazione parallela in R

Mappare con futures

plan(multisession, workers = 2)

ls_df <- future_map(ls_files, read.csv)
plan(sequential)
print(ls_df)
[[1]]
   state month plurality weight_gain_pounds mother_age
      AK     1         1                 30         43
   ...
[[2]]
   state month plurality weight_gain_pounds mother_age
      AL    10         1                 60         33
   ...
...
Programmazione parallela in R

Profilare con due worker

profvis({
  plan(multisession, workers = 2)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

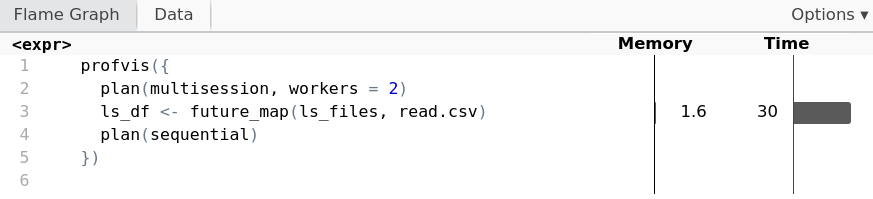
Output di profilazione generato da profvis. La lettura parallela dei CSV con due worker via future_map usa 1,6 MB di memoria; le altre righe non registrano uso.

Programmazione parallela in R

Profilare con quattro worker

profvis({
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

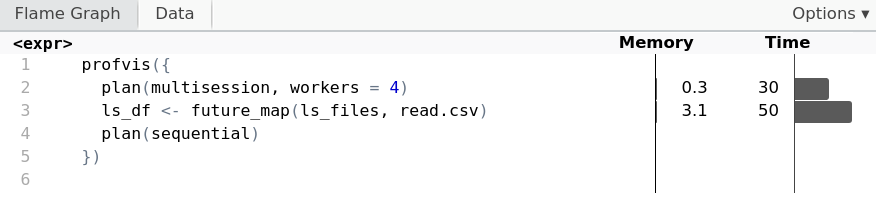
Output di profilazione generato da profvis. La lettura parallela dei CSV con quattro worker via future_map usa 3,1 MB di memoria; la pianificazione multisession usa 0,3 MB.

Programmazione parallela in R

Dietro le quinte

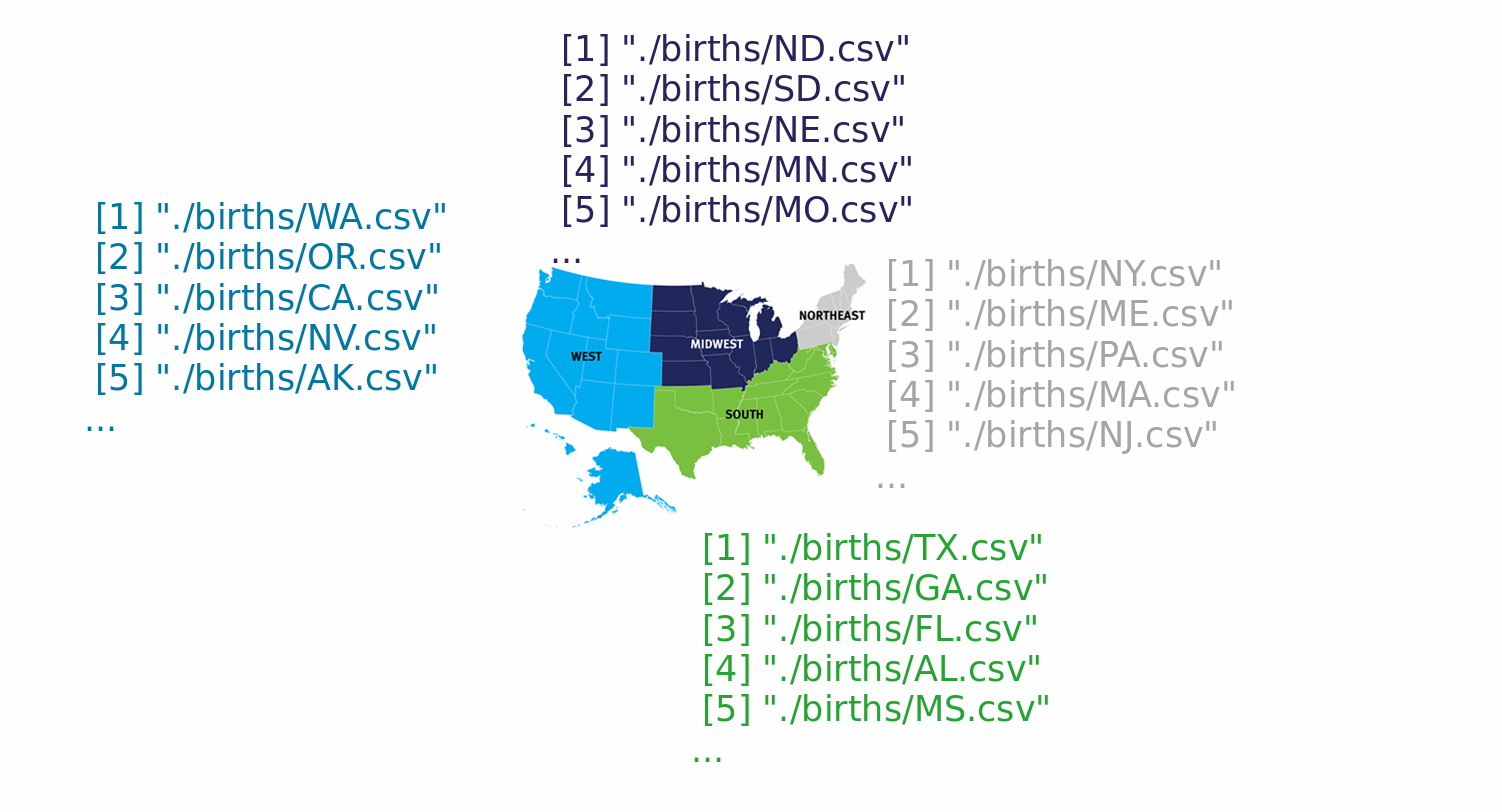
Mappa degli USA divisa in quattro regioni: West, Midwest, South e Northeast. Ogni regione corrisponde a un elenco di file CSV con i dati degli stati.

Programmazione parallela in R

Gestire la memoria con il chunking

config <- furrr_options(chunk_size = 26)

plan(multisession, workers = 4) ls_df <- future_map(ls_files, read.csv,
.options = config) plan(sequential)
Programmazione parallela in R

Gestire la memoria con il chunking

profvis({
  config <- furrr_options(chunk_size = 26)
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv,
             .options = config)
  plan(sequential)
})

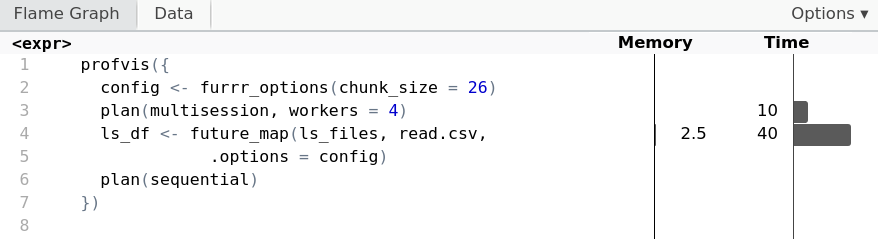
Output di profilazione generato da profvis. Lettura parallela dei CSV con quattro worker via future_map usa 2,5 MB di memoria con chunk_size 26.

Programmazione parallela in R

Chunking con parallel

cl <- makeCluster(4)


ls_df <- parLapply(cl, ls_files, read.csv)
stopCluster(cl)

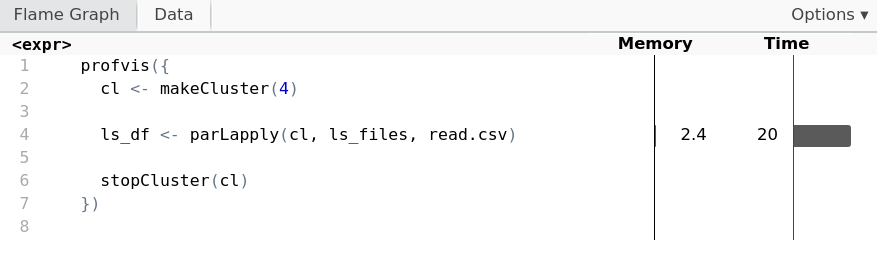
La lettura parallela dei CSV con parLapply usa 2,4 MB di memoria, tutti nella chiamata parLapply.

Programmazione parallela in R

Chunking con parallel

cl <- makeCluster(4)
ls_df <- parLapply(cl, ls_files, read.csv,

chunk.size = 26)
stopCluster(cl)

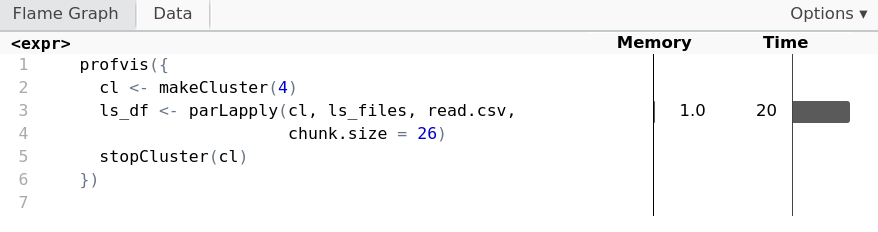
La lettura parallela dei CSV con parLapply usa solo 1 MB di memoria quando chunk.size è 26.

Programmazione parallela in R

Quando usare il chunking?

  • Il chunking è ottimale di default
  • Con oggetti di dati grandi e poca memoria
    • Prova con meno core se possibile
    • Sperimenta alcune dimensioni di chunk per ottimizzare
Programmazione parallela in R

Esercitiamoci!

Programmazione parallela in R

Preparing Video For Download...