Ottimizzare le SVM lineari

Support Vector Machines in R

Kailash Awati

Instructor

SVM lineare, cost predefinito

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  1 
      gamma:  0.5 
Number of Support Vectors:  55
Support Vector Machines in R

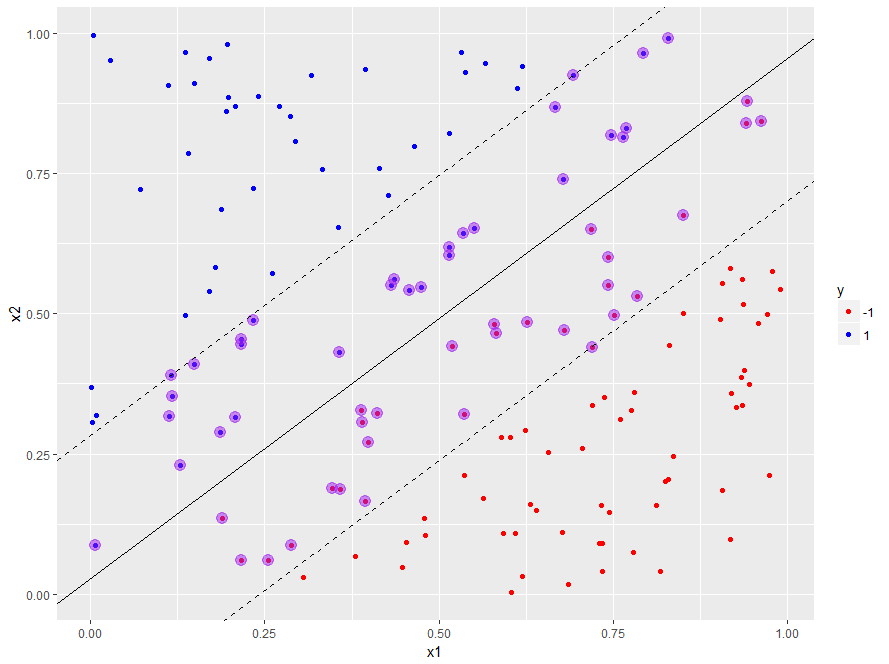
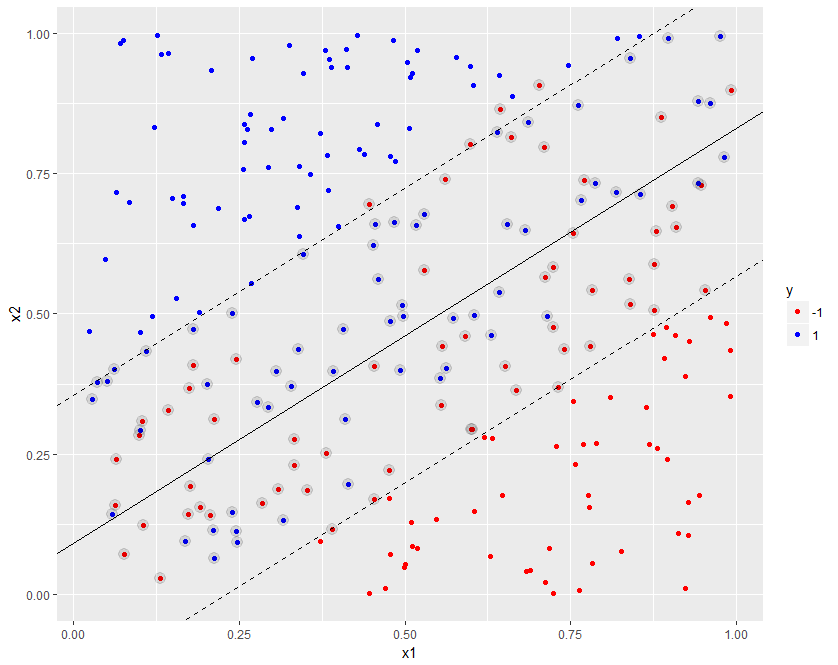
Capitolo 2.3 - dataset linearmente separabile, cost predefinito kernel lineare con vettori di supporto, confini di decisione e margine

Support Vector Machines in R

SVM lineare con cost = 100

library(e1071)
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
# Print model summary
svm_model
Call:
svm(formula = y ~ .,
    data = trainset,
    type = "C-classification", 
    kernel = "linear",
    cost = 100,
    scale = FALSE)

Parameters:
SVM-Type:  C-classification 
 SVM-Kernel:  linear 
       cost:  100 
      gamma:  0.5 
Number of Support Vectors:  6
Support Vector Machines in R

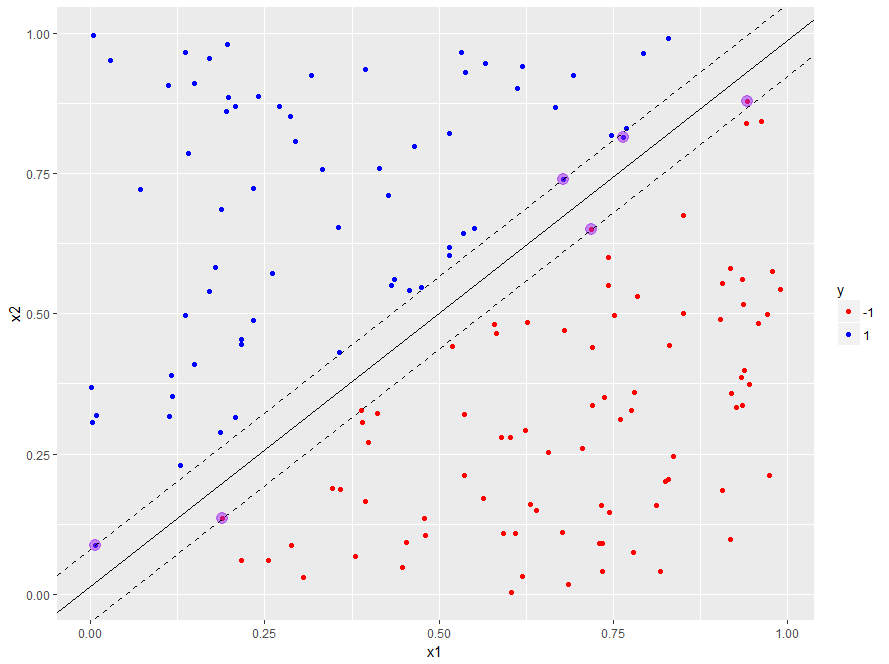
Capitolo 2.3 - dati linearmente separabili, cost = 100 kernel lineare con vettori di supporto, confini di decisione e margine

Support Vector Machines in R

Implicazioni

  • Utile per ridurre il margine se sai che il confine è lineare
  • ...ma nella pratica capita di rado
Support Vector Machines in R

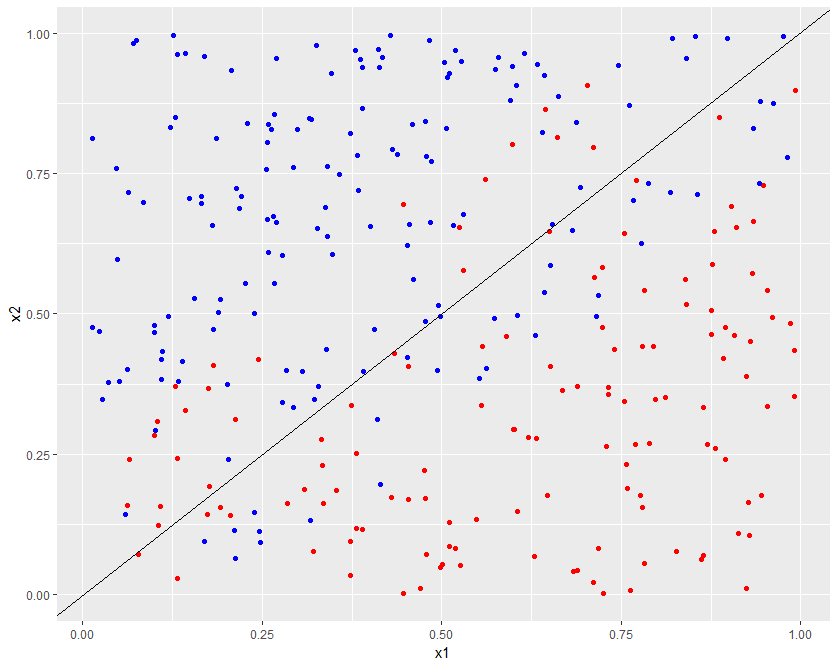
Capitolo 2.3 - dataset non linearmente separabile

Support Vector Machines in R

Dataset non lineare, SVM lineare (cost = 100)

  • Crea un modello con cost=100 usando un training set pari all'80% dei dati
# Build model
library(e1071)
svm_model<- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 100,
                scale = FALSE)
  • Calcola l'accuracy
# Train and test accuracy
pred_train <- predict(svm_model, trainset)
mean(pred_train == trainset$y)
0.8208333
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.85
  • Accuracy media sul test su 50 split casuali train/test: 82,9%
Support Vector Machines in R

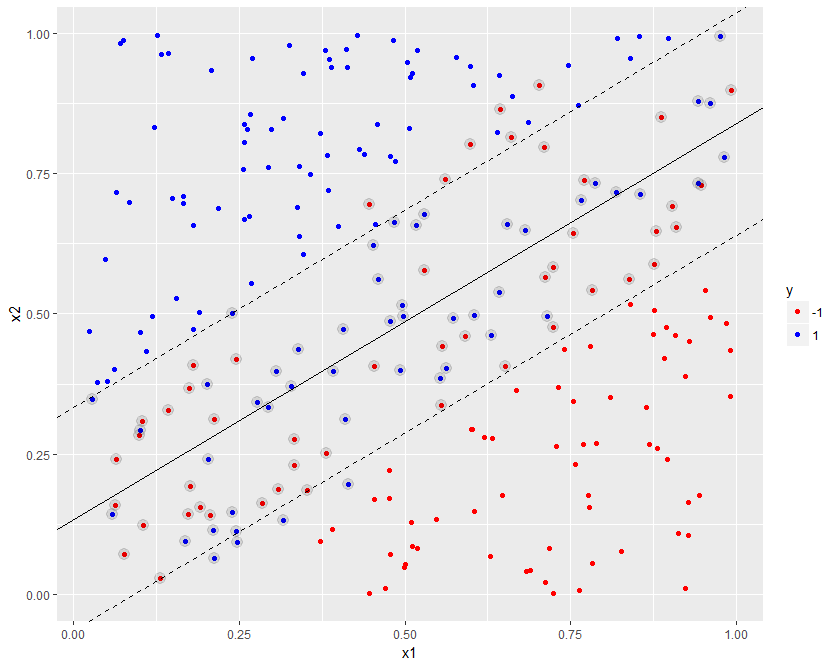
Capitolo 2.3 - dataset non linearmente separabile, cost=100 kernel lineare con vettori di supporto, confini di decisione e margine

Support Vector Machines in R

Dataset non lineare, SVM lineare (cost = 1)

  • Ricostruisci il modello impostando cost = 1
# Trainset contiene l'80% dei dati
# Stesso split train/test di prima.
# Build model
svm_model <- svm(y ~ ., 
                data = trainset, 
                type = "C-classification", 
                kernel = "linear", 
                cost = 1,
                scale = FALSE)
  • Calcola l'accuracy sul test
# Test accuracy
pred_test <- predict(svm_model, testset)
mean(pred_test == testset$y)
0.8666667
  • Accuracy media sul test su 50 split casuali train/test: 83,7%
Support Vector Machines in R

Capitolo 2.3 - dataset non linearmente separabile, cost=1 kernel lineare con vettori di supporto, confini di decisione e margine

Support Vector Machines in R

Esercitiamoci!

Support Vector Machines in R

Preparing Video For Download...