Limitazione della frequenza

Deployment di AI in produzione con FastAPI

Matt Eckerle

Software and Data Engineering Leader

Introduzione alla limitazione della frequenza
un semaforo


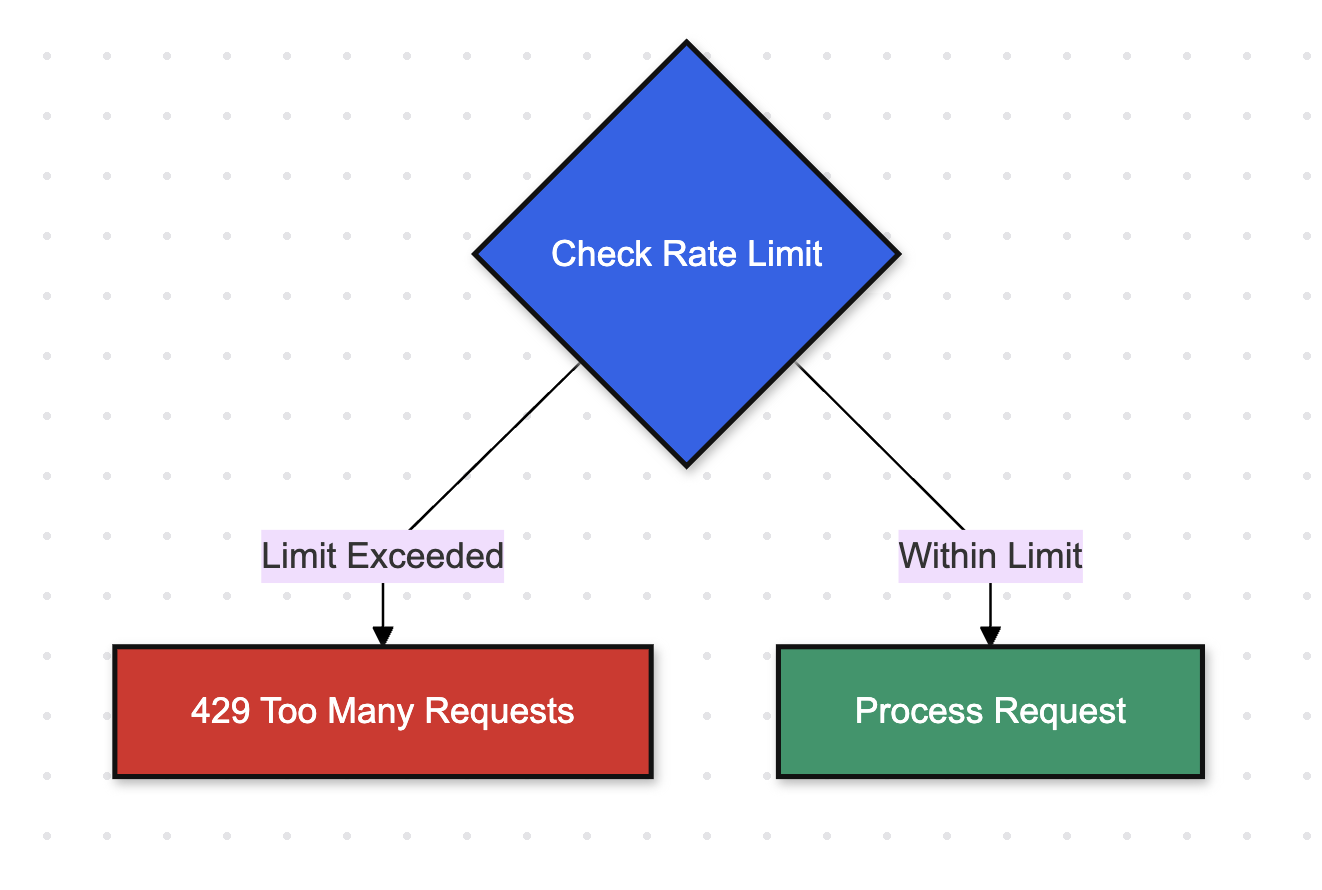
  • Scopo: controlla la frequenza delle richieste API.
  • Risposta: restituisce HTTP 429 ("Too Many Requests") quando superi il limite.
Deployment di AI in produzione con FastAPI

Come funziona la limitazione della frequenza
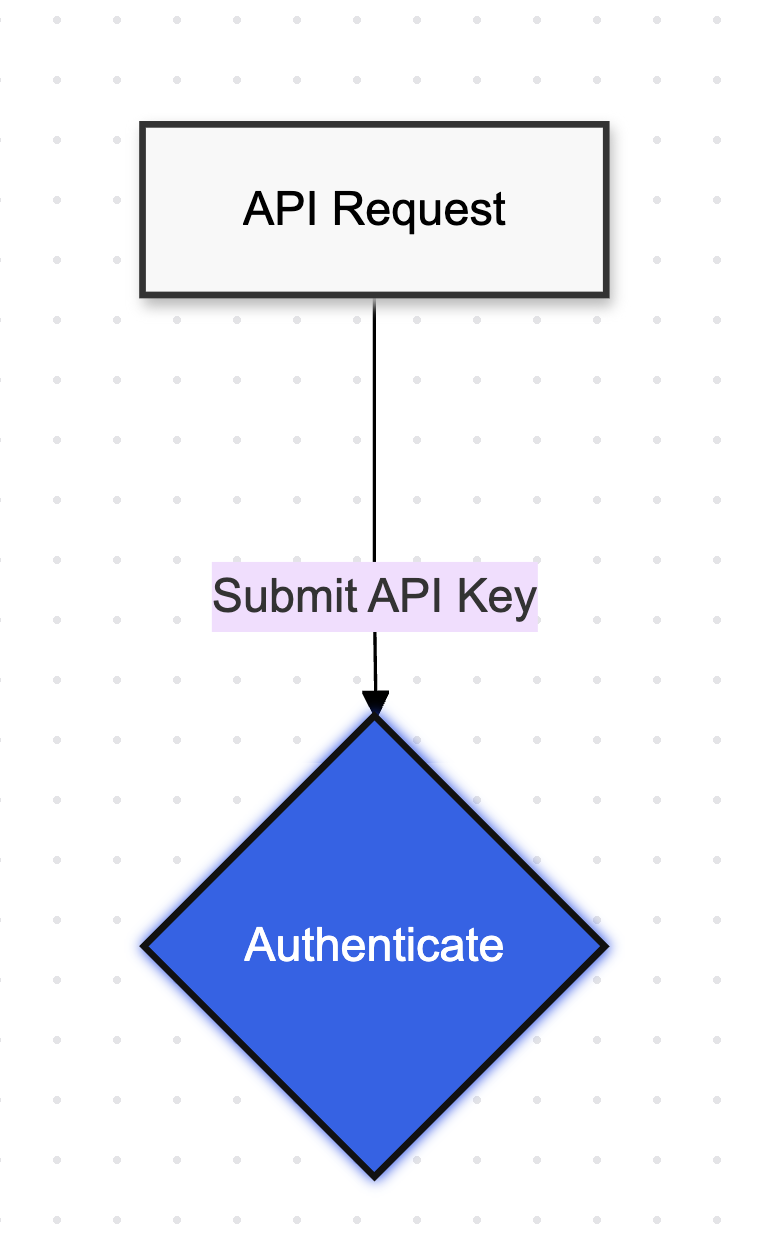
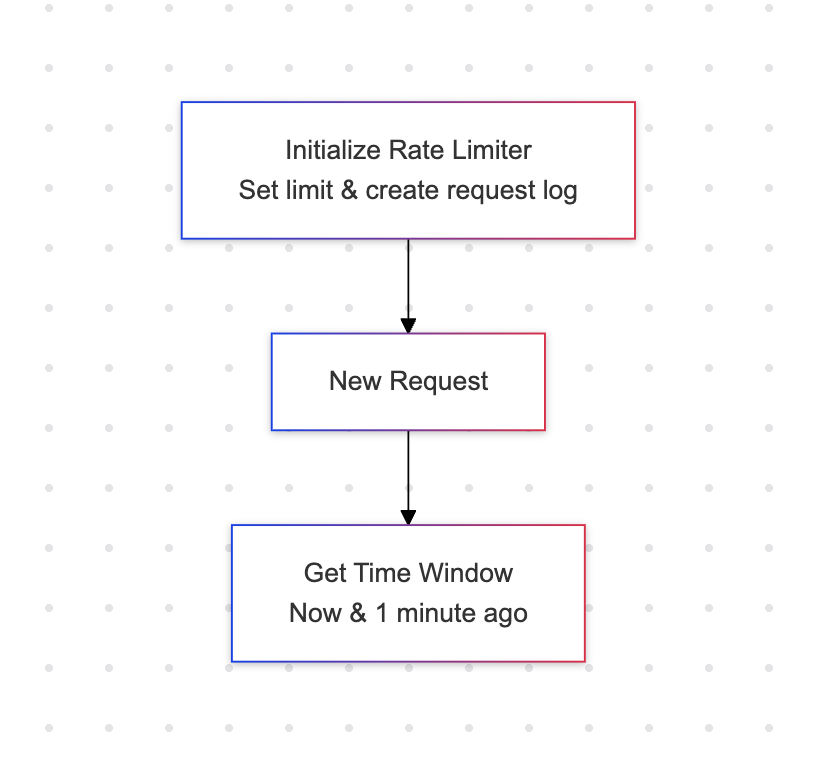
Parte 1 del diagramma di flusso che spiega la limitazione della frequenza

Deployment di AI in produzione con FastAPI

Autenticazione delle credenziali in ingresso
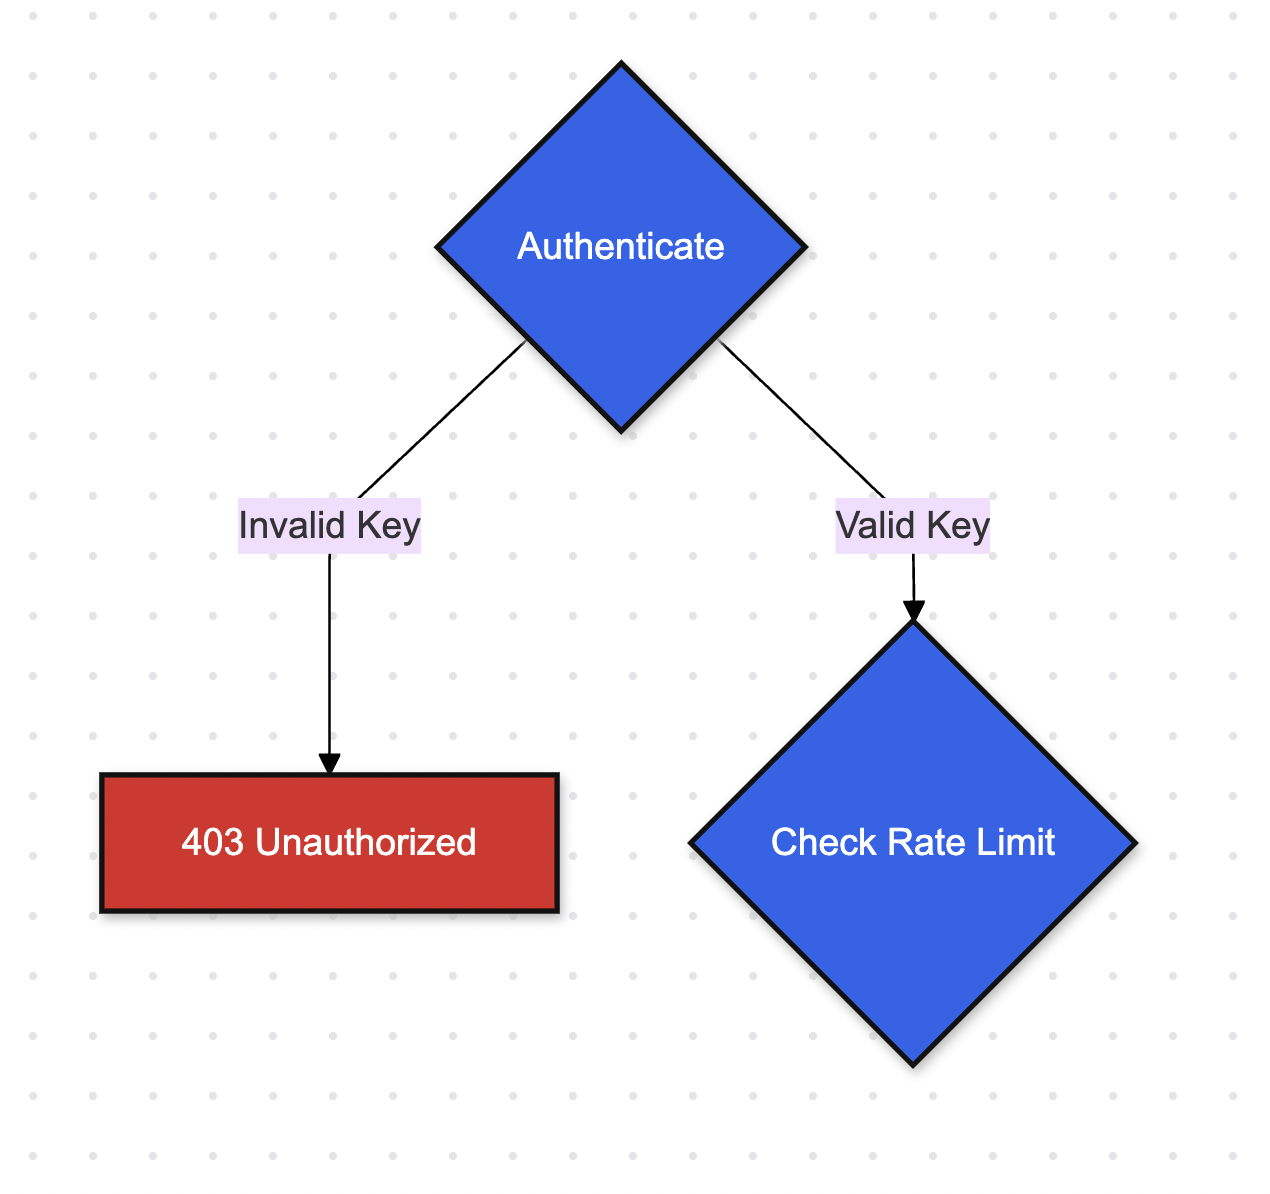
Parte 2 del diagramma di flusso che spiega la limitazione della frequenza

Deployment di AI in produzione con FastAPI

Verifica della limitazione

Parte 3 del diagramma di flusso che spiega la limitazione della frequenza

Deployment di AI in produzione con FastAPI

Configurare la nostra API

from fastapi import FastAPI, Depends, HTTPException
from fastapi.security import APIKeyHeader
from pydantic import BaseModel

app = FastAPI()
model = SentimentAnalyzer(pkl_file_path)

API_KEY_HEADER = APIKeyHeader(name="X-API-Key")
API_KEY = "your-secret-key"
Deployment di AI in produzione con FastAPI

La logica del rate limiter

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:

Parte 1 del diagramma di flusso della logica dietro l'implementazione della limitazione della frequenza

Deployment di AI in produzione con FastAPI

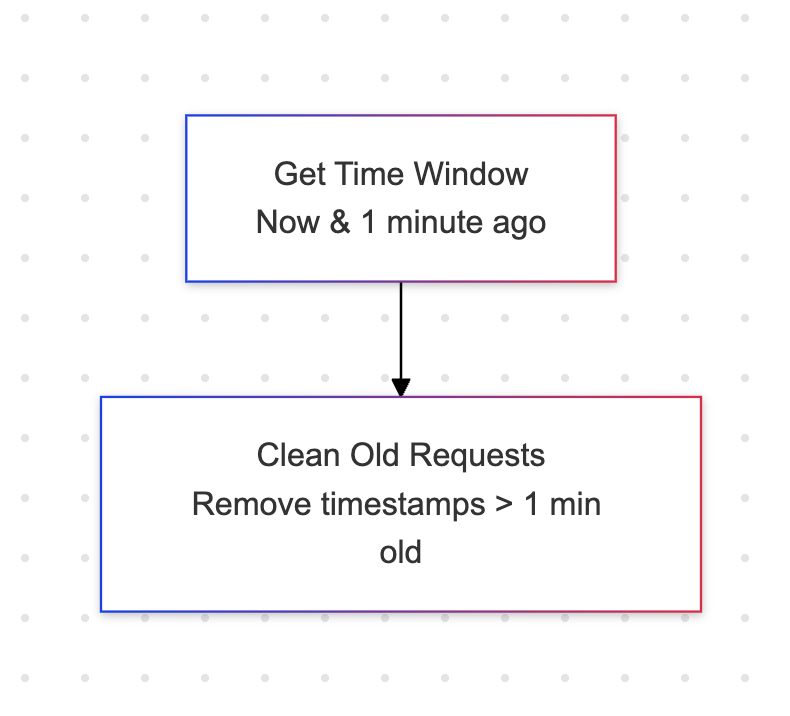
Eliminare le richieste vecchie

from datetime import datetime, timedelta

class RateLimiter:
    def __init__(self, requests_per_min: int = 10):
        self.requests_per_min = requests_per_min
        self.requests = defaultdict(list)

def is_rate_limited( self, api_key: str ) -> tuple[bool, int]:
now = datetime.now() minute_ago = now - timedelta(minutes=1) self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]

Parte 2 del diagramma di flusso che spiega la limitazione della frequenza

Deployment di AI in produzione con FastAPI

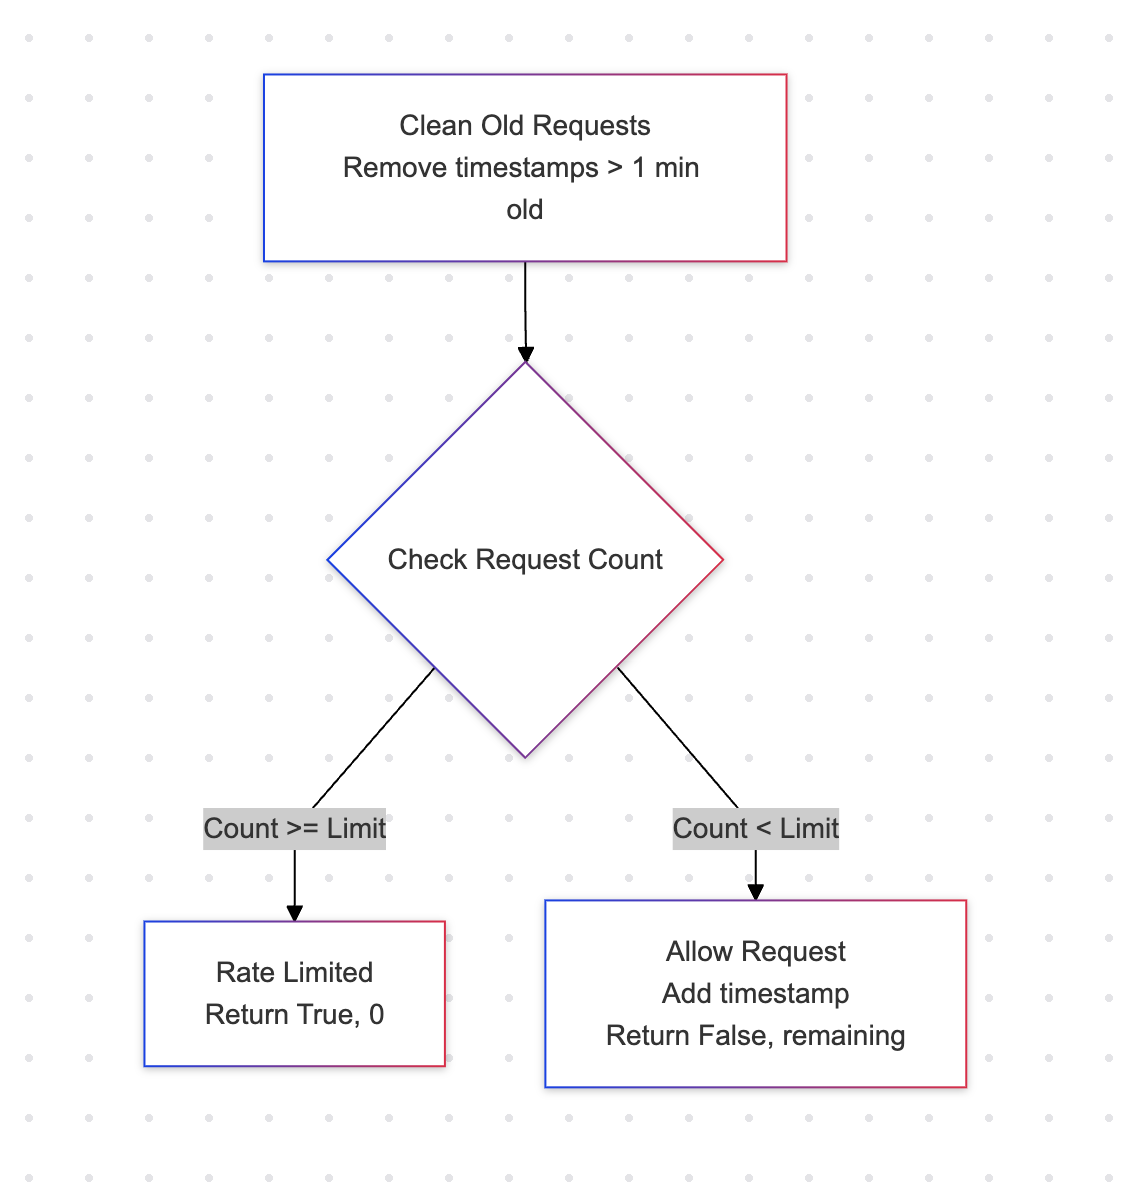
Verificare il numero di richieste

    def is_rate_limited(self, api_key: str) -> 
  tuple[bool, int]:
        now = datetime.now()
        minute_ago = now - timedelta(minutes=1)

self.requests[api_key] = [ req_time for req_time in self.requests[api_key] if req_time > minute_ago ]
recent_requests = len(self.requests[api_key]) if recent_requests >= self.requests_per_min: return True, 0 self.requests[api_key].append(now) return False

Un diagramma che rappresenta il controllo del numero di richieste fatte all'API: se il conteggio è maggiore o uguale al limite, restituisce true; altrimenti restituisce false.

Deployment di AI in produzione con FastAPI

Aggiungi il controllo del limite

rate_limiter = RateLimiter(requests_per_minute=10)

def test_api_key(api_key: str = Depends(API_KEY_HEADER)): if api_key != API_KEY: raise HTTPException( status_code=403, detail="Invalid API key" ) is_limited, _ = rate_limiter.is_rate_limited(api_key) if is_limited: raise HTTPException( status_code=429, detail="Rate limit exceeded. Please try again later." ) return api_key
Deployment di AI in produzione con FastAPI

Applica il limite all'endpoint

@app.post("/predict")
def predict_sentiment(
    request: SentimentRequest,
    api_key: str = Depends(test_api_key)
):
    result = sentiment_model(request.text)

    _, requests_remaining = 
           rate_limiter.is_rate_limited(api_key)

    return {
        "text": request.text,
        "sentiment": result[0]["label"].lower(),
        "confidence": result[0]["score"],
        "requests_remaining": requests_remaining
    }

Invia la richiesta 11 volte:

curl -X POST "http://localhost:8000/predict" \
     -H "Content-Type: application/json" \
     -H "X-API-Key: your-secret-key" \
     -d '{"text": "I love this product"}'

Output:

{"detail":"Rate limit exceeded. 
           Please try again later."}
Deployment di AI in produzione con FastAPI

Esercitiamoci!

Deployment di AI in produzione con FastAPI

Preparing Video For Download...