Suy luận với dữ liệu số trong R
Mine Cetinkaya-Rundel
Associate Professor of the Practice, Duke University
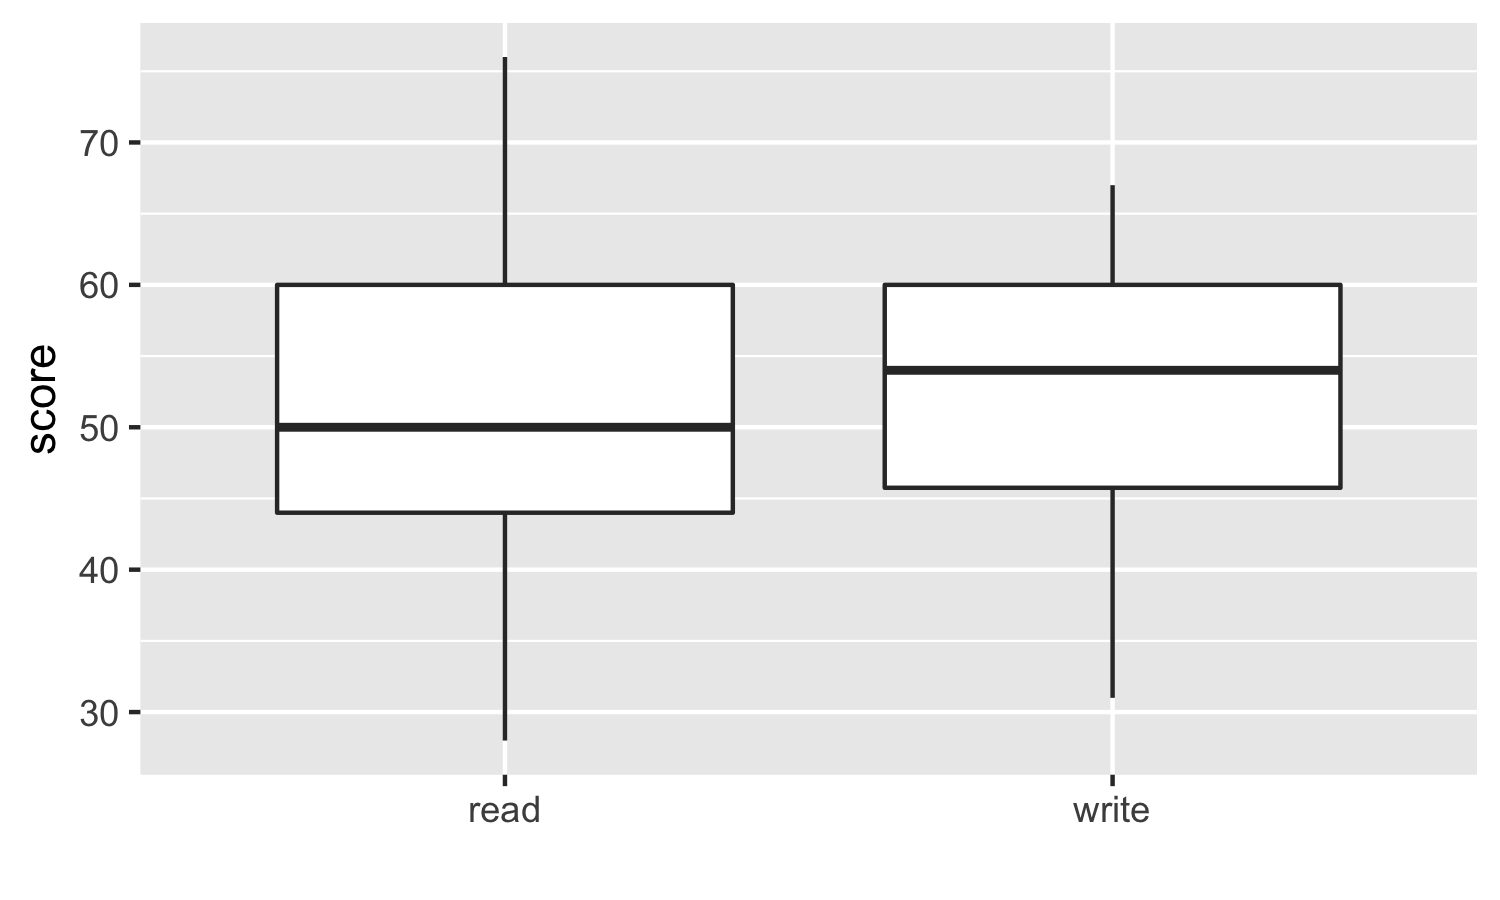
200 quan sát được lấy ngẫu nhiên từ khảo sát High School and Beyond. Cùng các học sinh đó làm bài kiểm tra đọc và viết. Nhìn nhanh, phân phối điểm đọc và viết giống nhau ở điểm nào? Khác nhau ra sao?

Điểm đọc và điểm viết của cùng một học sinh có thể coi là độc lập với nhau không?
Có lẽ là không!
Khi hai bộ quan sát có sự tương ứng đặc biệt này (không độc lập), ta gọi là dữ liệu cặp.
Để phân tích dữ liệu cặp, thường hữu ích khi xét chênh lệch kết quả của từng cặp quan sát:
diff = read − write.
| học_sinh | đọc | viết | diff |
|---|---|---|---|
| 1 | 57 | 52 | 5 |
| 2 | 68 | 59 | 9 |
| 3 | 44 | 33 | 11 |
| ... | ... | ... | ... |
| 200 | 63 | 65 | -2 |
Lập khoảng tin cậy 95% cho chênh lệch trung bình giữa điểm đọc và điểm viết.
t.test(hsb2$diff, conf.level = 0.95)
Lập khoảng tin cậy 95% cho chênh lệch trung bình giữa điểm đọc và điểm viết.
t.test(hsb2$diff, conf.level = 0.95)
One Sample t-test
data: hsb2$diff
t = -0.86731, df = 199, p-value = 0.3868
alternative hypothesis: true mean is not equal to 0
95 percent confidence interval:
-1.7841424 0.6941424
sample estimates:
mean of x
-0.545
Khoảng tin cậy 95% cho chênh lệch trung bình giữa điểm đọc và viết (read - write) là (-1.78, 0.69)
so với
Chúng ta tự tin 95% rằng điểm đọc trung bình thấp hơn 1.78 điểm đến cao hơn 0.69 điểm so với điểm viết trung bình.
Suy luận với dữ liệu số trong R