ChIP-seq với Bioconductor trong R
Peter Humburg
Statistician, Macquarie University


Tải dữ liệu:
reads <- readGAlignments(bam)
reads_gr <- granges(reads[[1]])
Lấy độ dài mảnh trung bình:
frag_length <- fragmentlength(qc_report)["GSM1598218"]
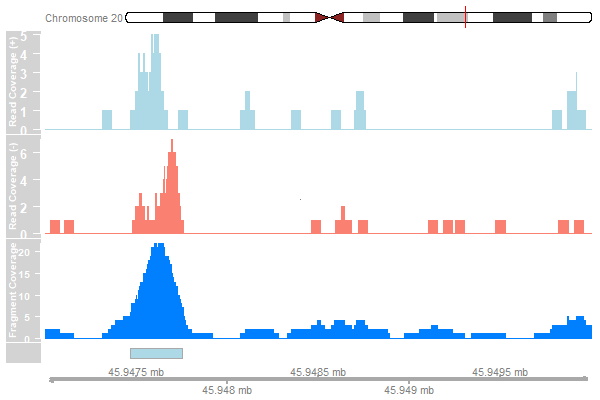
Mở rộng reads và tính coverage:
reads_ext <- resize(reads_gr, width=frag_length)
cover_ext <- coverage(reads_ext)

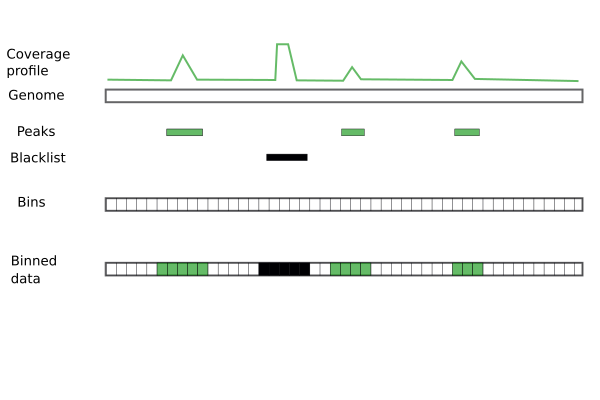
Tạo các bin 200 bp dọc theo bộ gen.
bins <- tileGenome(seqinfo(reads), tilewidth=200,
cut.last.tile.in.chrom=TRUE)
Tìm các bin giao với peaks.
peak_bins_overlap <- findOverlaps(bins, peaks)
peak_bins <- bins[from(peak_bins_overlap), ]
Đếm số reads giao với mỗi bin của peak.
peak_bins$score <- countOverlaps(peak_bins, reads)
count_bins <- function(reads, target, bins){
# Find all bins overlapping peaks
overlap <- from(findOverlaps(bins, target))
target_bins <- bins[overlap, ]
# Count the number of reads overlapping each peak bin
target_bins$score <- countOverlaps(target_bins, reads)
target_bins
}
peak_bins <- count_bins(reads_ext, peaks, bins)
bl_bins <- count_bins(reads_ext, blacklist.hg19, bins)
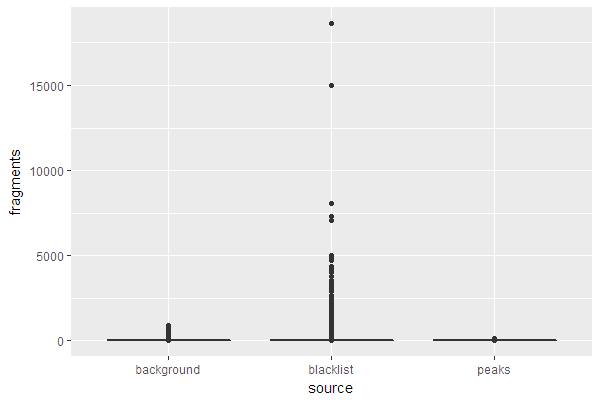
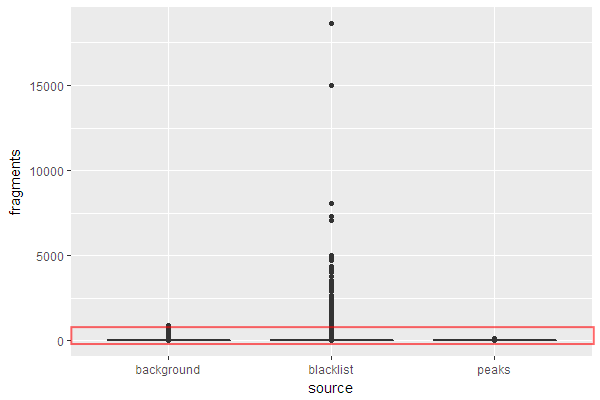
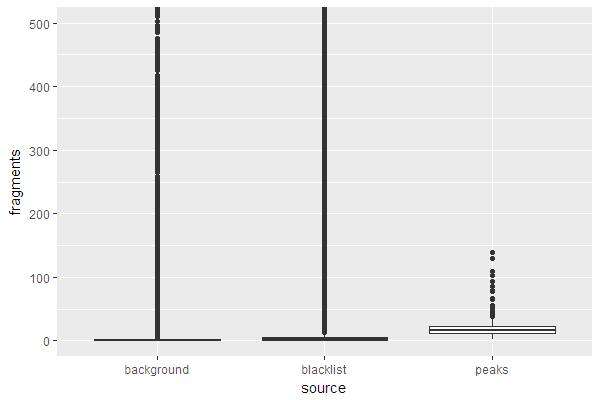
Loại bỏ các bin đã được tính.
bkg_bins <- subset(bins, !bins %in% peak_bins & !bins %in% bl_bins)
Đếm số reads giao với từng bin còn lại.
bkg_bins$score <- countOverlaps(bkg_bins, reads_ext)


ChIP-seq với Bioconductor trong R