Định luật Benford để phát hiện gian lận
Phát hiện gian lận với R

Bart Baesens
Professor Data Science at KU Leuven
Dữ liệu điều tra dân số
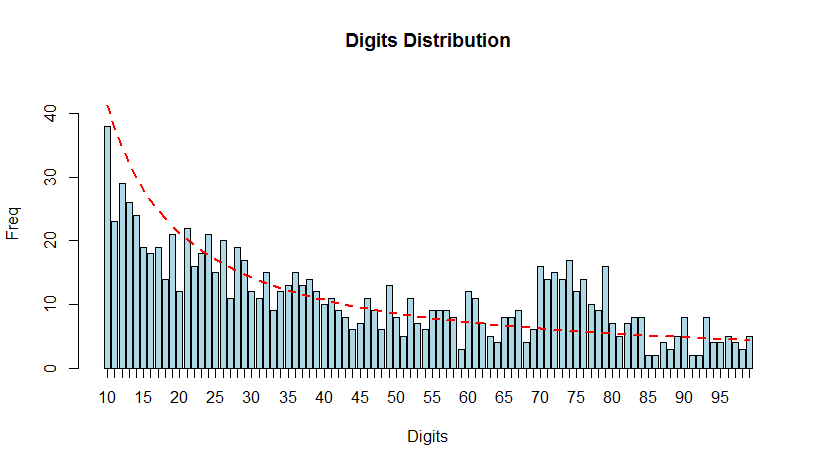
bfd.cen <- benford(census.2009$pop.2009, number.of.digits = 2)
plot(bfd.cen)
Phân tích theo Định luật Benford cho chữ số đầu
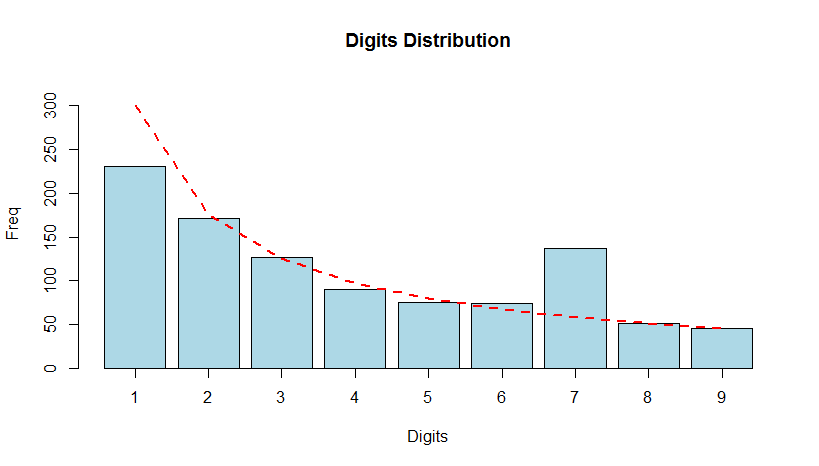
bfd1.exp <- benford(expenses, number.of.digits = 1)
plot(bfd1.exp)
Phân tích theo Định luật Benford cho hai chữ số đầu
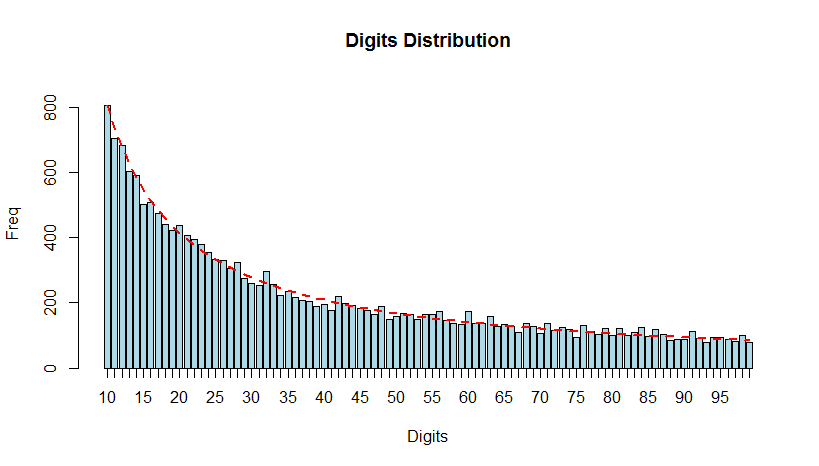
bfd2.exp <- benford(expenses, number.of.digits = 2)
plot(bfd2.exp)