Nhập môn Quản trị Rủi ro Danh mục bằng Python
Dakota Wixom
Quantitative Analyst | QuantCourse.com

Tỷ lệ Sharpe đo lường lợi nhuận đã điều chỉnh rủi ro.
Để tính phiên bản năm 1966 của tỷ lệ Sharpe:
$$ S = \frac{ R_a - r_f }{\sigma_a} $$

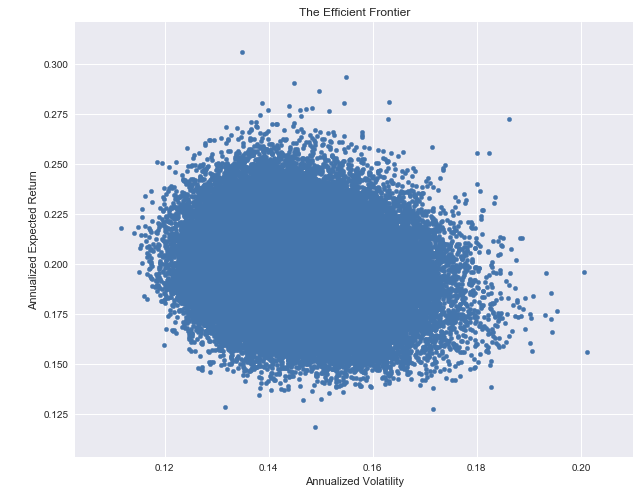
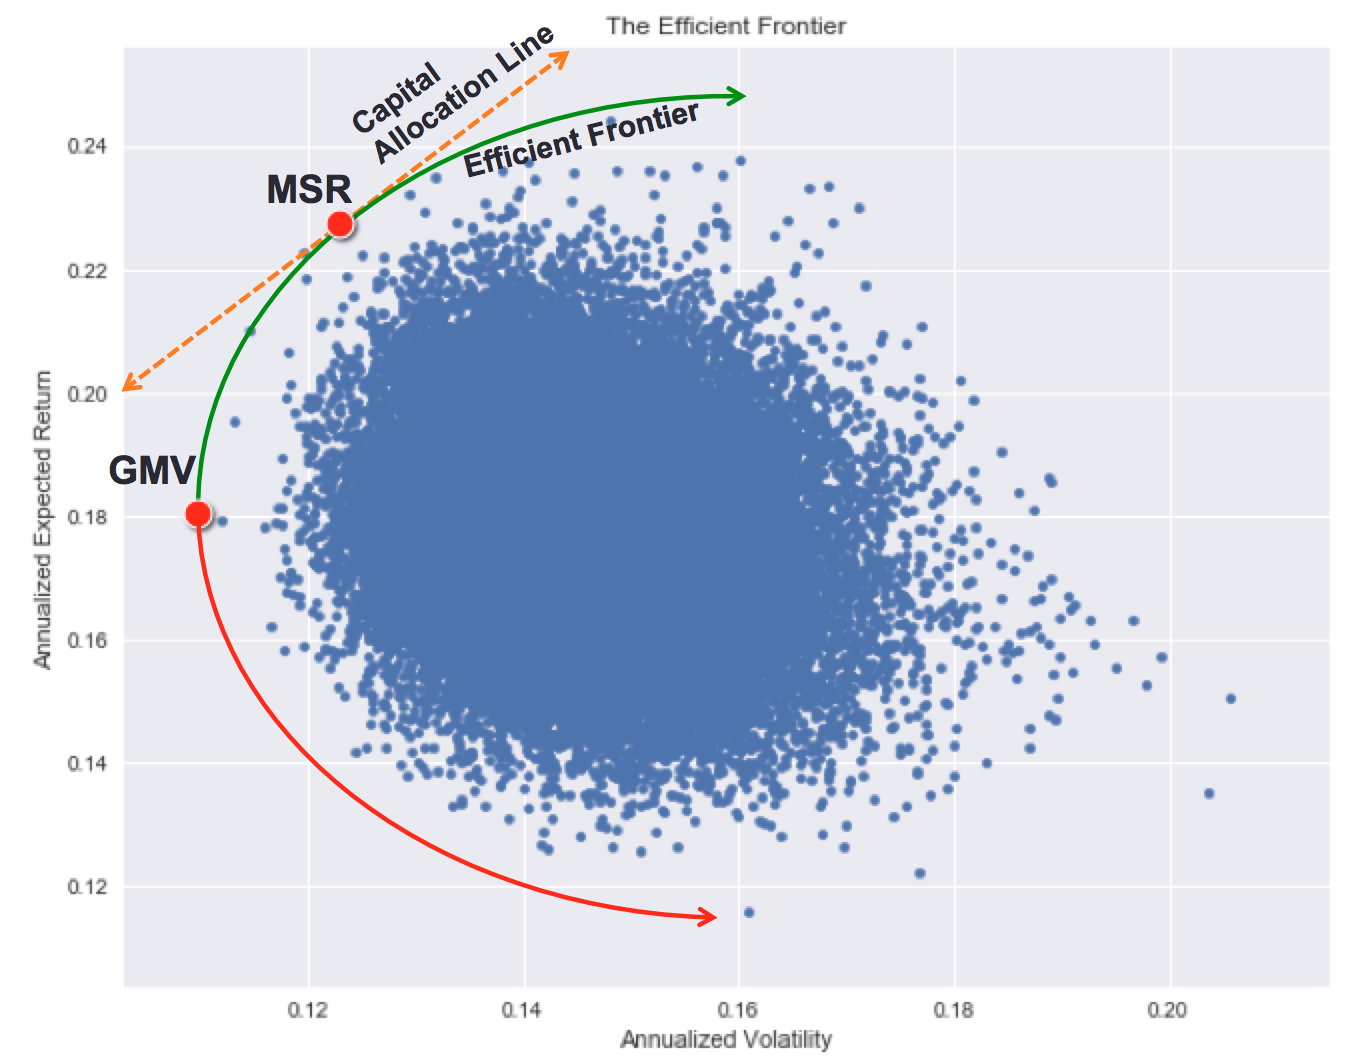
Mọi điểm trên biên hiệu quả đều là một danh mục tối ưu.
Hai điểm phổ biến này gọi là Danh mục Markowitz:

Bạn chọn danh mục tốt nhất như thế nào?
Giả sử có DataFrame df của các danh mục ngẫu nhiên với cột Volatility và Returns:
numstocks = 5
risk_free = 0
df["Sharpe"] = (df["Returns"] - risk_free) / df["Volatility"]
MSR = df.sort_values(by=['Sharpe'], ascending=False)
MSR_weights = MSR.iloc[0, 0:numstocks]
np.array(MSR_weights)
array([0.15, 0.35, 0.10, 0.15, 0.25])
Dù danh mục Max Sharpe Ratio nghe có vẻ hấp dẫn, trong thực tế rất khó dự đoán lợi nhuận.
Giả sử có DataFrame df của các danh mục ngẫu nhiên với cột Volatility và Returns:
numstocks = 5
GMV = df.sort_values(by=['Volatility'], ascending=True)
GMV_weights = GMV.iloc[0, 0:numstocks]
np.array(GMV_weights)
array([0.25, 0.15, 0.35, 0.15, 0.10])
Nhập môn Quản trị Rủi ro Danh mục bằng Python