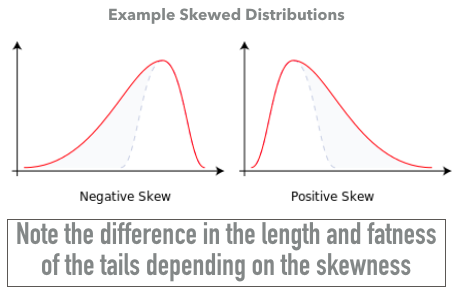
Lệch âm: Khối phân phối tập trung bên phải. Thường là đường cong nghiêng phải
Lệch dương: Khối phân phối tập trung bên trái. Thường là đường cong nghiêng trái
Trong tài chính, bạn thường muốn skewness dương
Skewness trong Python
Giả sử bạn đã nạp sẵn dữ liệu lợi nhuận cổ phiếu trong đối tượng StockData.
Để tính skewness của lợi nhuận:
from scipy.stats import skew
skew(StockData["Returns"].dropna())
0.225
Lưu ý skewness lớn hơn 0 trong ví dụ này, gợi ý phân phối không chuẩn.
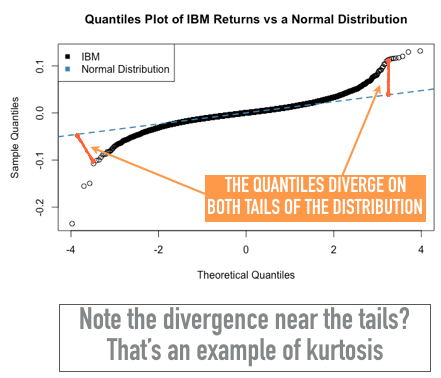
Kurtosis đo độ dày của phần đuôi phân phối
Phần lớn lợi nhuận tài chính là leptokurtic
Leptokurtic: Khi phân phối có excess kurtosis dương (kurtosis lớn hơn 3)
Excess Kurtosis: Trừ 3 khỏi kurtosis mẫu để tính "Excess Kurtosis"
Excess kurtosis trong Python
Giả sử bạn đã nạp sẵn dữ liệu lợi nhuận cổ phiếu trong đối tượng StockData. Để tính excess kurtosis của lợi nhuận:
from scipy.stats import kurtosis
kurtosis(StockData["Returns"].dropna())
2.44
Lưu ý excess kurtosis lớn hơn 0 trong ví dụ này, gợi ý phân phối không chuẩn.
Kiểm định tính chuẩn trong Python
Làm sao thực hiện kiểm định thống kê cho tính chuẩn?
Giả thuyết không của kiểm định Shapiro–Wilk là dữ liệu có phân phối chuẩn.
# Chạy kiểm định chuẩn Shapiro–Wilk trong Python
from scipy import stats
p_value = stats.shapiro(StockData["Returns"].dropna())[1]
if p_value <= 0.05:
     print("Null hypothesis of normality is rejected.")
else:
     print("Null hypothesis of normality is accepted.")
Giá trị p là biến thứ hai được trả về trong danh sách. Nếu p-value nhỏ hơn 0.05, bác bỏ giả thuyết không vì dữ liệu nhiều khả năng không chuẩn.