TfIdf: Nhiều cách hơn để biến đổi văn bản

Phân tích cảm xúc với Python

Violeta Misheva

Data Scientist

Các thành phần của TfIdf là gì?

  • TF: tần suất thuật ngữ: Một từ xuất hiện bao nhiêu lần trong một tài liệu của tập văn bản

  • IDF: nghịch tần số tài liệu: Tỷ lệ log giữa tổng số tài liệu và số tài liệu chứa từ đó

    • Dùng để tính trọng số cho các từ xuất hiện không thường xuyên
Phân tích cảm xúc với Python

Điểm TfIdf của một từ

  • Điểm TfIdf:
TfIdf = tần suất thuật ngữ * nghịch tần số tài liệu
  • BOW không tính đến độ dài tài liệu, TfIdf có.
  • TfIdf nêu bật các từ phổ biến trong một tài liệu nhưng không phổ biến trên nhiều tài liệu.
Phân tích cảm xúc với Python

TfIdf hữu ích thế nào?

Cảm xúc về hãng bay trên Twitter
  • Điểm TfIdf thấp: United, Virgin America
  • Điểm TfIdf cao: quy trình check-in (nếu hiếm trên các tài liệu)
Thêm về TfIdf
  • Vì phạt các từ xuất hiện thường xuyên, ít cần xử lý stop words rõ ràng.
  • Hữu ích trong truy vấn tìm kiếm và truy hồi thông tin để xếp hạng mức liên quan của kết quả.
Phân tích cảm xúc với Python

TfIdf trong Python

# Import the TfidfVectorizer
from sklearn.feature_extraction.text import TfidfVectorizer
  • Tham số của TfidfVectorizer: max_features, ngram_range, stop_words, token_pattern, max_df, min_df
vect = TfidfVectorizer(max_features=100).fit(tweets.text)
X = vect.transform(tweets.text)
Phân tích cảm xúc với Python

TfidfVectorizer

X
<14640x100 sparse matrix of type '<class 'numpy.float64'>'
    with 119182 stored elements in Compressed Sparse Row format>
X_df = pd.DataFrame(X_txt.toarray(), columns=vect.get_feature_names())
X_df.head()
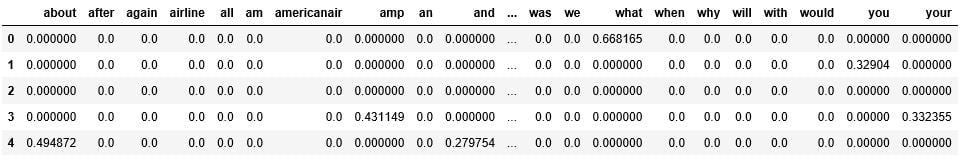
5 hàng đầu của dữ liệu tạo bằng TfIdf

Phân tích cảm xúc với Python

Hãy luyện tập!

Phân tích cảm xúc với Python

Preparing Video For Download...