Feature Engineering với PySpark
John Hogue
Lead Data Scientist, General Mills

df.select(['NO', 'UNITNUMBER', 'CLASS']).show()
+----+----------+-----+
| NO|UNITNUMBER|CLASS|
+----+----------+-----+
| 1| null| SF|
| 156| A8| SF|
| 157| 207| SF|
| 158| 701G| SF|
| 159| 36| SF|
Nhiều trường không cần cho phân tích
'NO' số thứ tự tự sinh'UNITNUMBER' dữ liệu không liên quan'CLASS' toàn giá trị cố định drop(*cols)
*cols – tên một cột hoặc danh sách tên cột cần xóa.# Danh sách cột cần xóa cols_to_drop = ['NO', 'UNITNUMBER', 'CLASS']# Xóa các cột df = df.drop(*cols_to_drop)
where(condition)types.BooleanType hoặc chuỗi biểu thức SQL.like(other)~df = df.where(~df['POTENTIALSHORTSALE'].like('Not Disclosed'))
Lọc dữ liệu trong phạm vi ba độ lệch chuẩn (3σ) quanh trung bình (μ)
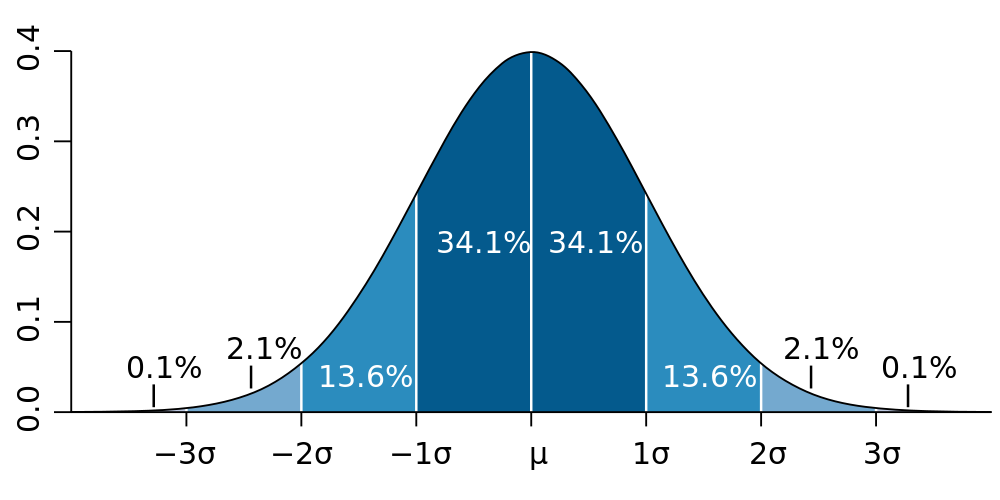
# Tính các giá trị dùng để lọc std_val = df.agg({'SALESCLOSEPRICE': 'stddev'}).collect()[0][0] mean_val = df.agg({'SALESCLOSEPRICE': 'mean'}).collect()[0][0]# Tạo ngưỡng trên/dưới theo ba độ lệch chuẩn (μ ± 3σ) hi_bound = mean_val + (3 * std_val) low_bound = mean_val - (3 * std_val)# Dùng where() để lọc DataFrame trong khoảng giá trị df = df.where((df['LISTPRICE'] < hi_bound) & (df['LISTPRICE'] > low_bound))
DataFrame.dropna()
how: 'any' hoặc 'all'. Với 'any', xóa bản ghi nếu có bất kỳ giá trị null. Với 'all', chỉ xóa khi tất cả giá trị đều null.thresh: int, mặc định None. Nếu đặt, xóa bản ghi có ít hơn thresh giá trị không null. Ghi đè tham số how.subset: danh sách tùy chọn các tên cột để xét.# Xóa mọi bản ghi có giá trị NULL df = df.dropna()# Xóa bản ghi nếu cả LISTPRICE và SALESCLOSEPRICE đều NULL df = df.dropna(how='all', subset['LISTPRICE', 'SALESCLOSEPRICE '])# Xóa bản ghi nếu có ít nhất hai cột là NULL df = df.dropna(thresh=2)
Thế nào là bản ghi trùng lặp?
dropDuplicates()
# Toàn bộ DataFrame df.dropDuplicates()# Chỉ kiểm tra theo danh sách cột df.dropDuplicates(['streetaddress'])
Feature Engineering với PySpark