Feature Engineering với PySpark
John Hogue
Lead Data Scientist, General Mills
df.describe(['LISTPRICE']).show()
+-------+------------------+
|summary| LISTPRICE|
+-------+------------------+
| count| 5000|
| mean| 263419.365|
| stddev|143944.10818036905|
| min| 100000|
| max| 99999|
+-------+------------------+
pyspark.sql.functions.mean(col)pyspark.sql.functions.skewness(col)pyspark.sql.functions.min(col)cov(col1, col2)corr(col1, col2)mean(col)df.agg({'SALESCLOSEPRICE': 'mean'}).collect()
[Row(avg(SALESCLOSEPRICE)=262804.4668)]
cov(col1, col2)df.cov('SALESCLOSEPRICE', 'YEARBUILT')
1281910.3840634783

Vẽ biểu đồ DataFrame của PySpark bằng thư viện chuẩn như Seaborn cần chuyển sang Pandas
CẢNH BÁO: Hãy lấy mẫu DataFrame PySpark trước khi chuyển sang Pandas!
sample(withReplacement, fraction, seed=None)withReplacement cho phép lặp lại trong mẫufraction % bản ghi giữ lạiseed hạt giống ngẫu nhiên để tái lập# Lấy mẫu 50% DataFrame PySpark và đếm số hàng
df.sample(False, 0.5, 42).count()
2504
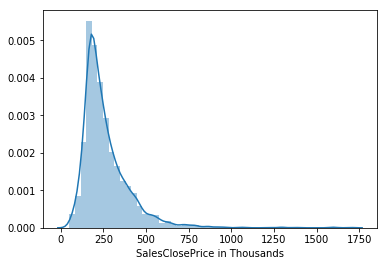
Seaborn distplot()
seaborn.distplot(a)a : Series, mảng 1 chiều, hoặc list. Dữ liệu quan sát.# Import thư viện trực quan hóa bạn thích import seaborn as sns# Lấy mẫu dataframe sample_df = df.select(['SALESCLOSEPRICE']).sample(False, 0.5, 42)# Chuyển mẫu sang Pandas DataFrame pandas_df = sample_df.toPandas()# Vẽ biểu đồ sns.distplot(pandas_df)

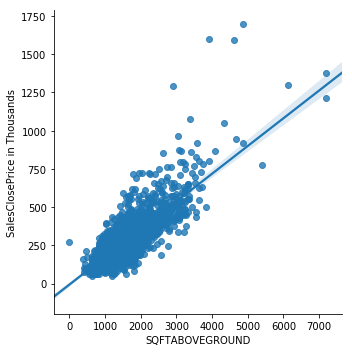
Seaborn lmplot()
seaborn.lmplot(x, y, data)x, y : chuỗi, biến đầu vào; phải là tên cột trong dữ liệu.data : Pandas DataFrame# Import thư viện trực quan hóa bạn thích import seaborn as sns# Chọn cột s_df = df.select(['SALESCLOSEPRICE', 'SQFTABOVEGROUND']) # Lấy mẫu dataframe s_df = s_df.sample(False, 0.5, 42)# Chuyển sang Pandas DataFrame pandas_df = s_df.toPandas()# Vẽ biểu đồ sns.lmplot(x='SQFTABOVEGROUND', y='SALESCLOSEPRICE', data=pandas_df)

Feature Engineering với PySpark