Xử lý dữ liệu thiếu

Feature Engineering với PySpark

John Hogue

Lead Data Scientist, General Mills

Dữ liệu biến mất như thế nào trong kỷ nguyên số?

Thu thập dữ liệu

  • Cảm biến hỏng

Quy tắc lưu trữ dữ liệu

  • 2017-01-01 vs January 1st, 2017

Nối dữ liệu rời rạc

  • Hàng tháng sang hàng tuần

Cố ý để trống

  • Lo ngại về quyền riêng tư

Thiếu

Feature Engineering với PySpark

Các loại thiếu dữ liệu

Thiếu hoàn toàn ngẫu nhiên

  • Dữ liệu thiếu là một tập con hoàn toàn ngẫu nhiên

Thiếu ngẫu nhiên

  • Thiếu có điều kiện theo một quan sát khác

Thiếu không ngẫu nhiên

  • Thiếu do cách dữ liệu được thu thập
Feature Engineering với PySpark

Đánh giá giá trị thiếu

Khi nào nên loại bỏ các dòng có dữ liệu thiếu?

  • Giá trị thiếu hiếm gặp
  • Thiếu hoàn toàn ngẫu nhiên

isNull()

  • Trả về True nếu biểu thức hiện tại là null.
df.where(df['ROOF'].isNull()).count()
765
Feature Engineering với PySpark

Vẽ biểu đồ giá trị thiếu

# Import library
import seaborn as sns

# subset the dataframe sub_df = df.select(['ROOMAREA1'])
# sample the dataframe sample_df = sub_df.sample(False, .5, 4)
# Convert to Pandas DataFrame pandas_df = sample_df.toPandas()
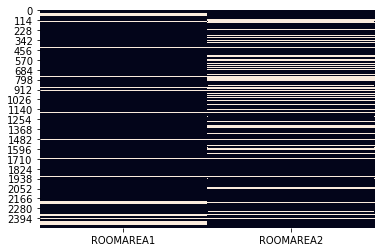
# Plot it sns.heatmap(data=pandas_df.isnull())
Feature Engineering với PySpark

Bản đồ nhiệt giá trị thiếu

Bản đồ nhiệt dữ liệu thiếu

Feature Engineering với PySpark

Bù giá trị thiếu

Quy trình thay thế giá trị thiếu

Dựa trên quy tắc

  • Giá trị theo logic nghiệp vụ

Dựa trên thống kê

  • Dùng mean, median, v.v.

Dựa trên mô hình

  • Dùng mô hình để dự đoán giá trị
Feature Engineering với PySpark

Bù giá trị thiếu

** fillna(value, subset=None)

  • value giá trị dùng để thay thế phần thiếu
  • subset danh sách cột cần thay thế phần thiếu
# Thay giá trị thiếu bằng 0
df.fillna(0, subset=['DAYSONMARKET'])
# Thay bằng giá trị mean của cột đó
col_mean = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
df.fillna(col_mean, subset=['DAYSONMARKET'])
Feature Engineering với PySpark

Cùng luyện tập nào!

Feature Engineering với PySpark

Preparing Video For Download...