Điều chỉnh dữ liệu

Feature Engineering với PySpark

John Hogue

Lead Data Scientist, General Mills

Vì sao cần biến đổi dữ liệu?
Phép biến đổi

Feature Engineering với PySpark

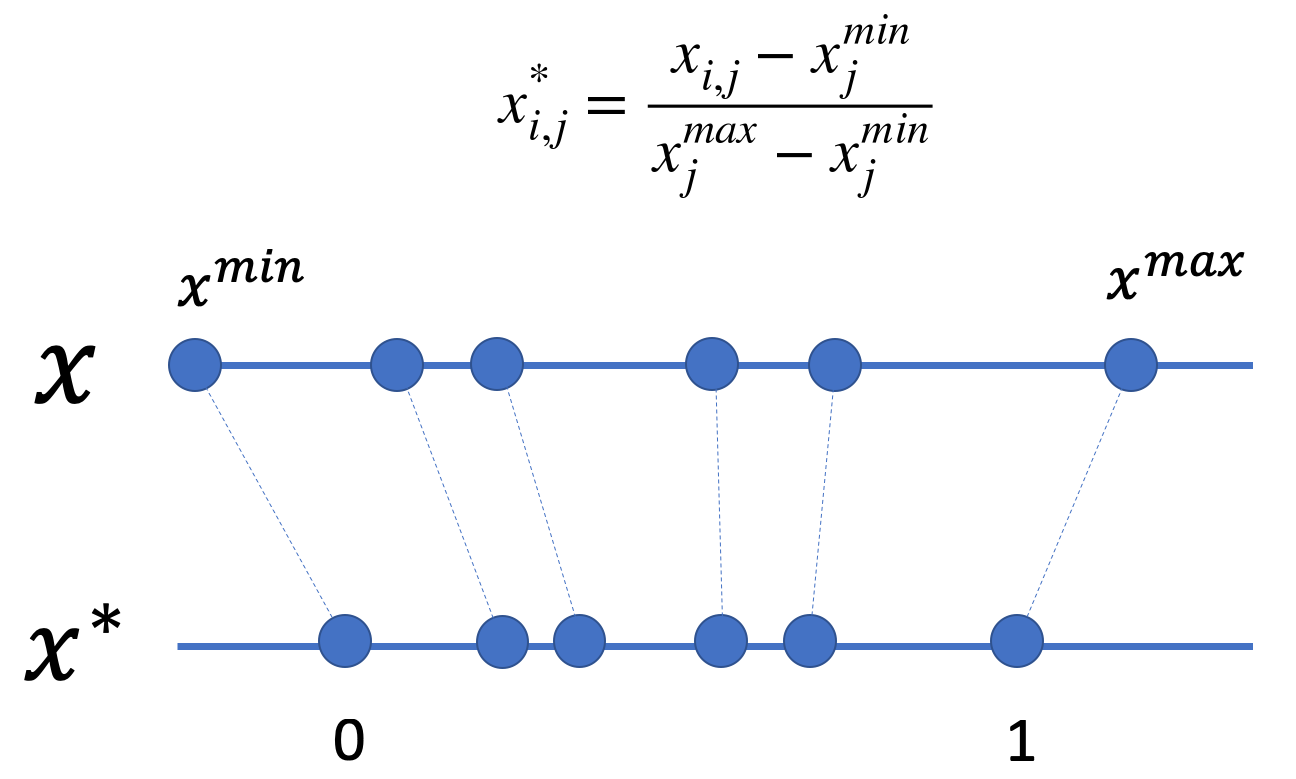
MinMax Scaling là gì

Chuẩn hóa MinMax

Feature Engineering với PySpark

Chuẩn hóa MinMax

# define min and max values and collect them
max_days = df.agg({'DAYSONMARKET': 'max'}).collect()[0][0]
min_days = df.agg({'DAYSONMARKET': 'min'}).collect()[0][0]

# create a new column based off the scaled data df = df.withColumn("scaled_days", (df['DAYSONMARKET'] - min_days) / (max_days - min_days))
df[['scaled_days']].show(5)
+--------------------+
|         scaled_days|
+--------------------+
|0.044444444444444446|
|0.017777777777777778|
| 0.12444444444444444|
| 0.08444444444444445|
| 0.09333333333333334|
+--------------------+
only showing top 5 rows
Feature Engineering với PySpark

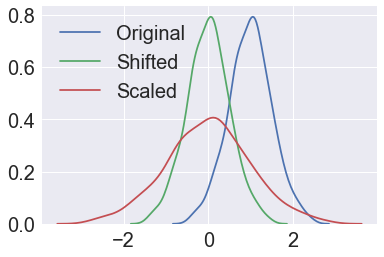
Standardization là gì?

Biến đổi dữ liệu về phân phối chuẩn tắc

  • z = (x - μ)/ σ
  • Trung bình μ bằng 0
  • Độ lệch chuẩn σ bằng 1

Chuẩn hóa

Feature Engineering với PySpark

Chuẩn hóa

mean_days = df.agg({'DAYSONMARKET': 'mean'}).collect()[0][0]
stddev_days = df.agg({'DAYSONMARKET': 'stddev'}).collect()[0][0]

# Create a new column with the scaled data df = df.withColumn("ztrans_days", (df['DAYSONMARKET'] - mean_days) / stddev_days)
df.agg({'ztrans_days': 'mean'}).collect()
[Row(avg(ztrans_days)=-3.6568525985103407e-16)]
df.agg({'ztrans_days': 'stddev'}).collect()
[Row(stddev(ztrans_days)=1.0000000000000009)]
Feature Engineering với PySpark

Log Scaling là gì

Phân phối chưa chuẩn hóa
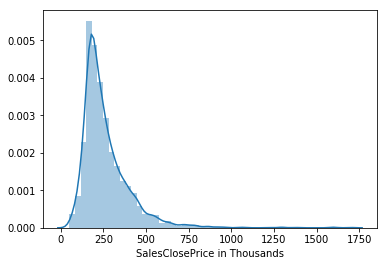
Biểu đồ phân phối gốc

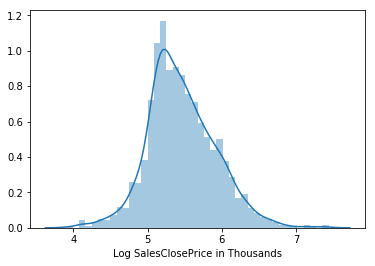
Phân phối theo log

Biểu đồ phân phối theo log

Feature Engineering với PySpark

Log Scaling

# import the log function
from pyspark.sql.functions import log
# Recalculate log of SALESCLOSEPRICE
df = df.withColumn('log_SalesClosePrice', log(df['SALESCLOSEPRICE']))
Feature Engineering với PySpark

Cùng luyện tập nào!

Feature Engineering với PySpark

Preparing Video For Download...