pandas로 빠르고 간편한 데이터 적재
Amany Mahfouz
Instructor
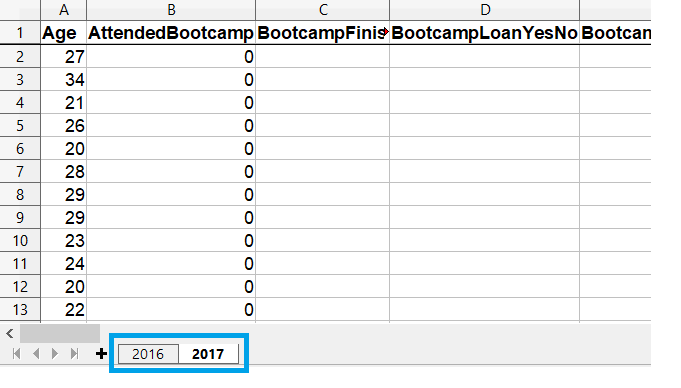
read_excel()은 기본적으로 첫 번째 시트를 로드합니다sheet_name 키워드를 사용합니다read_excel()에 전달한 인수는 읽는 모든 시트에 적용됩니다
# 위치 인덱스로 두 번째 시트 가져오기 survey_data_sheet2 = pd.read_excel('fcc_survey.xlsx', sheet_name=1)# 이름으로 두 번째 시트 가져오기 survey_data_2017 = pd.read_excel('fcc_survey.xlsx', sheet_name='2017')print(survey_data_sheet2.equals(survey_data_2017))
True
sheet_name=None을 read_excel()에 전달하면 통합 문서의 모든 시트를 읽습니다survey_responses = pd.read_excel("fcc_survey.xlsx", sheet_name=None)
print(type(survey_responses))
<class 'collections.OrderedDict'>
for key, value in survey_responses.items():
print(key, type(value))
2016 <class 'pandas.core.frame.DataFrame'>
2017 <class 'pandas.core.frame.DataFrame'>
# 로드한 모든 시트를 담을 빈 데이터프레임 생성 all_responses = pd.DataFrame()# 딕셔너리의 데이터프레임을 순회 for sheet_name, frame in survey_responses.items(): # 데이터의 연도를 알 수 있도록 열 추가 frame["Year"] = sheet_name# 데이터프레임을 all_responses에 추가 all_responses = pd.concat([all_responses, frame])# 데이터의 연도 확인 print(all_responses.Year.unique())
['2016' '2017']
pandas로 빠르고 간편한 데이터 적재