Python을 활용한 신용 위험 모델링
Michael Crabtree
Data Scientist, Ford Motor Company
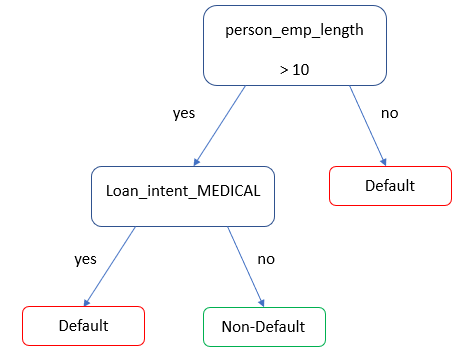
loan_status의 부도 확률을 예측하는 간단한 결정 트리| 대출 | 실제 대출 상태 | 예측 대출 상태 | 대출 상환 가치 | 매각 가치 | 손익 |
|---|---|---|---|---|---|
| 1 | 0 | 1 | $1,500 | $250 | -$1,250 |
| 2 | 0 | 1 | $1,200 | $250 | -$950 |
xgboost Python 패키지의 일부로, 여기서는 xgb라고 부릅니다.fit()으로 학습합니다# Create a logistic regression model
clf_logistic = LogisticRegression()
# Train the logistic regression
clf_logistic.fit(X_train, np.ravel(y_train))
# Create a gradient boosted tree model
clf_gbt = xgb.XGBClassifier()
# Train the gradient boosted tree
clf_gbt.fit(X_train,np.ravel(y_train))
.predict()와 .predict_proba() 모두로 예측합니다.predict_proba()는 0과 1 사이의 값을 생성합니다.predict()는 loan_status에 대해 1 또는 0을 생성합니다# Predict probabilities of default
gbt_preds_prob = clf_gbt.predict_proba(X_test)
# Predict loan_status as a 1 or 0
gbt_preds = clf_gbt.predict(X_test)
# gbt_preds_prob
array([[0.059, 0.940], [0.121, 0.989]])
# gbt_preds
array([1, 1, 0...])
learning_rate: 값이 작을수록 각 단계가 더 보수적으로 진행됩니다max_depth: 각 트리가 도달할 수 있는 깊이를 설정하며, 값이 클수록 더 복잡해집니다xgb.XGBClassifier(learning_rate = 0.2,
max_depth = 4)
Python을 활용한 신용 위험 모델링