Python을 활용한 신용 위험 모델링
Michael Crabtree
Data Scientist, Ford Motor Company
''인 경우| 결측 데이터 유형 | 발생 가능한 결과 |
|---|---|
| 숫자형 열의 NULL | 오류 |
| 문자형 열의 NULL | 오류 |
| 결측 데이터 | 해석 | 조치 |
|---|---|---|
loan_status의 NULL |
최근 승인된 대출 | 예측 데이터에서 제거 |
person_age의 NULL |
나이가 기록되지 않거나 공개되지 않음 | 중간값으로 대체 |
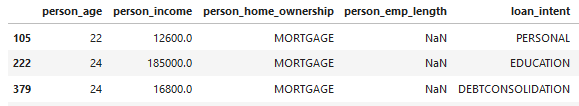
isnull() 함수로 널 값을 쉽게 찾을 수 있음sum() 함수로 널 레코드 개수를 쉽게 셀 수 있음.any() 메서드는 모든 열을 검사함null_columns = cr_loan.columns[cr_loan.isnull().any()]
cr_loan[null_columns].isnull().sum()
# Total number of null values per column
person_home_ownership 25
person_emp_length 895
loan_intent 25
loan_int_rate 3140
cb_person_default_on_file 15
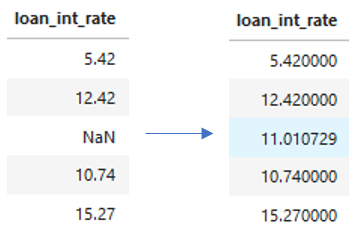
.fillna() 같은 방법으로 결측 데이터를 대체cr_loan['loan_int_rate'].fillna((cr_loan['loan_int_rate'].mean()), inplace = True)
.drop() 메서드로 레코드를 완전히 제거indices = cr_loan[cr_loan['person_emp_length'].isnull()].index
cr_loan.drop(indices, inplace=True)
Python을 활용한 신용 위험 모델링