신용 모델 성능
Python을 활용한 신용 위험 모델링

Michael Crabtree
Data Scientist, Ford Motor Company
모델 정확도 측정
- 정확도 계산하기
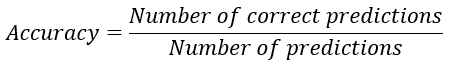
- scikit-learn의
.score()메서드 사용
# Check the accuracy against the test data
clf_logistic1.score(X_test,y_test)
0.81
loan_status값의 81%를 정확히 예측함
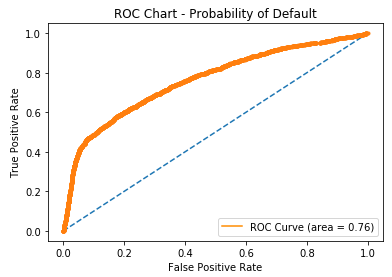
ROC 곡선 차트
- Receiver Operating Characteristic 곡선
- 참 양성 비율(민감도)과 거짓 양성 비율(위양성률)을 플로팅
fallout, sensitivity, thresholds = roc_curve(y_test, prob_default)
plt.plot(fallout, sensitivity, color = 'darkorange')
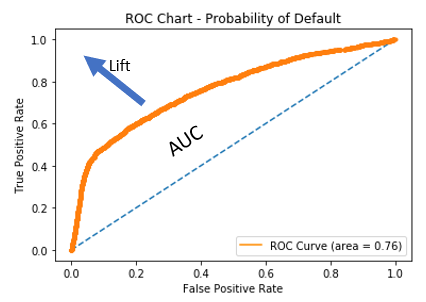
ROC 차트 분석
- Area Under Curve (AUC): 곡선과 무작위 예측 사이의 면적
부도 임계값
- 임계값: 확률이 부도로 간주되는 기준점
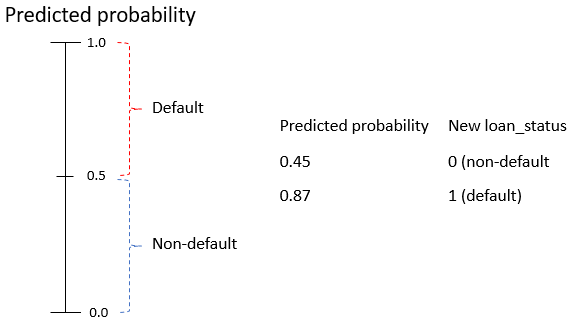
임계값 설정
- 임계값
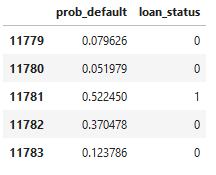
0.5를 기준으로 대출 재라벨링
preds = clf_logistic.predict_proba(X_test)
preds_df = pd.DataFrame(preds[:,1], columns = ['prob_default'])
preds_df['loan_status'] = preds_df['prob_default'].apply(lambda x: 1 if x > 0.5 else 0)
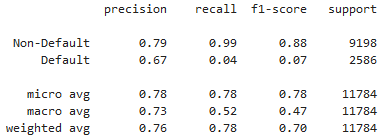
신용 분류 보고서
- scikit-learn의
classification_report()
from sklearn.metrics import classification_report
classification_report(y_test, preds_df['loan_status'], target_names=target_names)
분류 지표 선택하기
classification_report()에서 특정 구성 요소를 선택해 저장하기- scikit-learn의
precision_recall_fscore_support()함수 사용
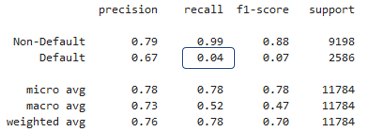
from sklearn.metrics import precision_recall_fscore_support
precision_recall_fscore_support(y_test,preds_df['loan_status'])[1][1]

