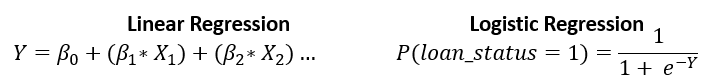Python을 활용한 신용 위험 모델링
Michael Crabtree
Data Scientist, Ford Motor Company
0.86처럼 0과 1 사이의 확률 값입니다loan_status가 1이면 채무 불이행, 0이면 정상 상환입니다0.86처럼 0과 1 사이의 확률 값입니다loan_status가 1이면 채무 불이행, 0이면 정상 상환입니다| 채무 불이행 확률 | 해석 | 예측된 대출 상태 |
|---|---|---|
| 0.4 | 채무 불이행 가능성 낮음 | 0 |
| 0.90 | 채무 불이행 가능성 매우 높음 | 1 |
| 0.1 | 채무 불이행 가능성 매우 낮음 | 0 |
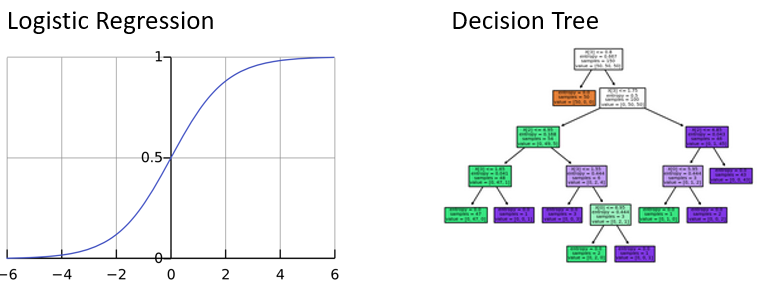
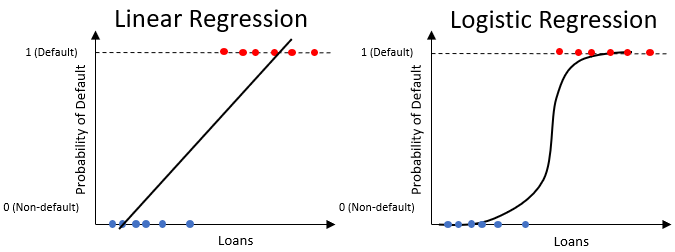
0과 1 사이의 값만 생성합니다from sklearn.linear_model import LogisticRegression
clf_logistic = LogisticRegression(solver='lbfgs')
.fit() 메서드로 학습시킵니다clf_logistic.fit(training_columns, np.ravel(training_labels))
loan_status를 제외한 데이터의 모든 열loan_status(0,1)| 데이터 하위 집합 | 용도 | 비율 |
|---|---|---|
| 훈련 | 데이터를 학습해 예측값을 생성 | 60% |
| 테스트 | 새로운 데이터로 학습 결과를 테스트 | 40% |
X = cr_loan.drop('loan_status', axis = 1)
y = cr_loan[['loan_status']]
train_test_split() 함수를 사용합니다X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=.4, random_state=123)
test_size: 테스트 세트로 사용할 데이터 비율random_state: 재현성을 위한 난수 시드 값Python을 활용한 신용 위험 모델링