모델 평가와 구현
Python을 활용한 신용 위험 모델링

Michael Crabtree
Data Scientist, Ford Motor Company
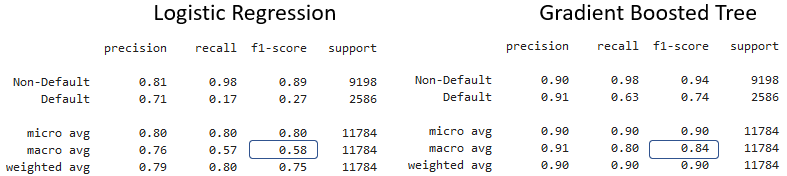
분류 보고서 비교하기
classification_report()로 보고서를 생성하고 비교해 보세요
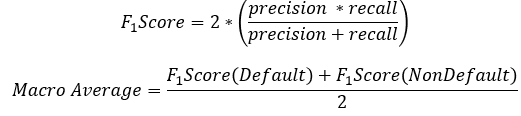
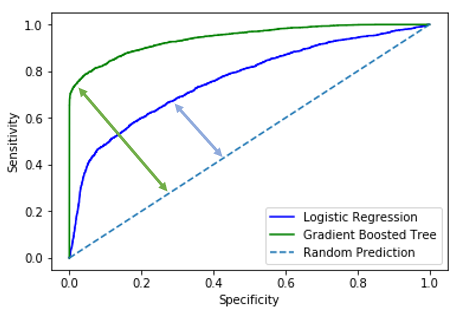
ROC 및 AUC 분석
- 성능이 더 좋은 모델일수록 리프트가 더 큽니다
- 리프트가 클수록 AUC 점수도 높아집니다
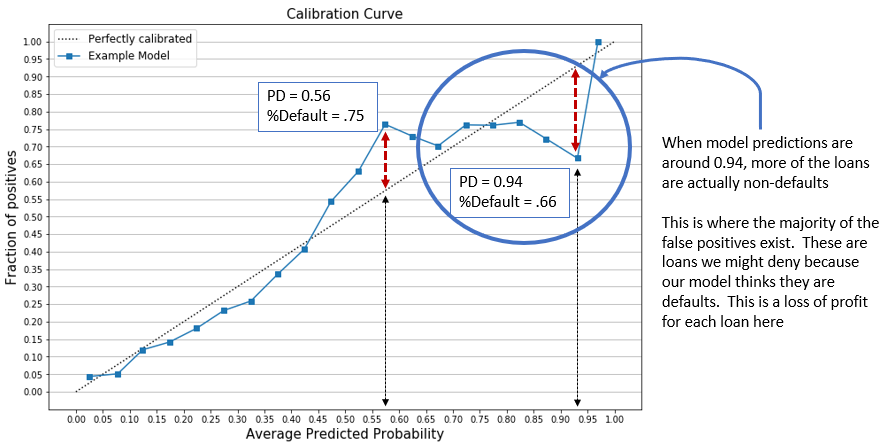
보정 곡선 그리기
plt.plot(mean_predicted_value, fraction_of_positives, label="%s" % "Example Model")
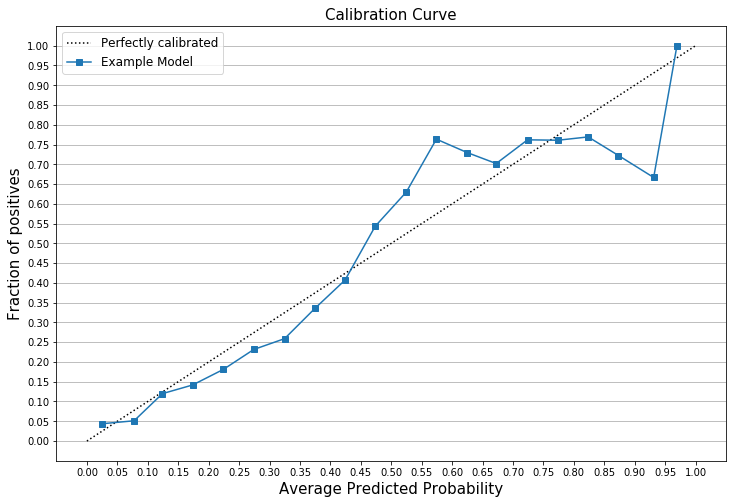
보정 곡선 확인하기
- 예시로 완벽한 보정선 위아래로 두 지점을 선택했습니다
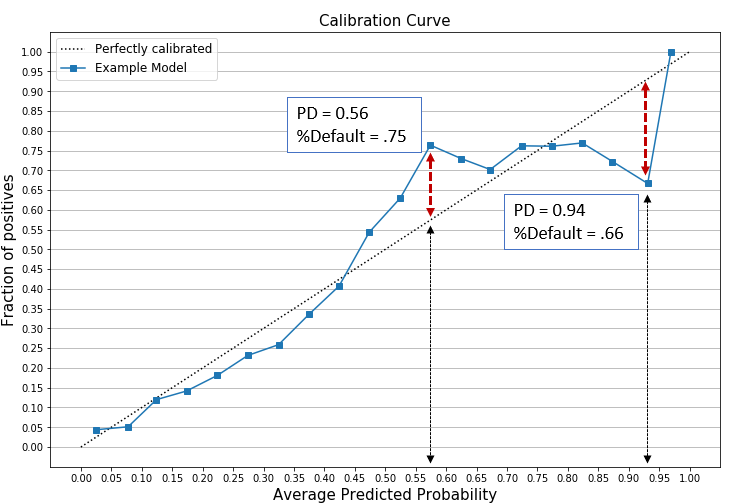
보정 곡선 해석하기
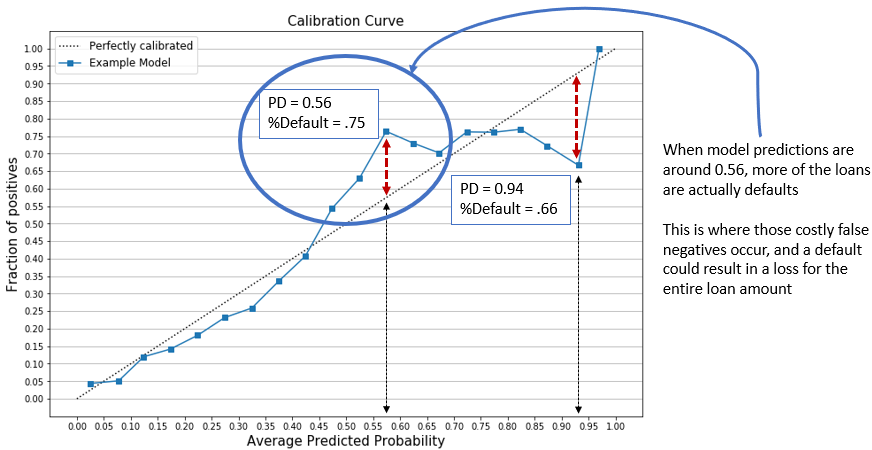
보정 곡선 해석하기