Python의 statsmodels로 배우는 중급 회귀
Maarten Van den Broeck
Content Developer at DataCamp
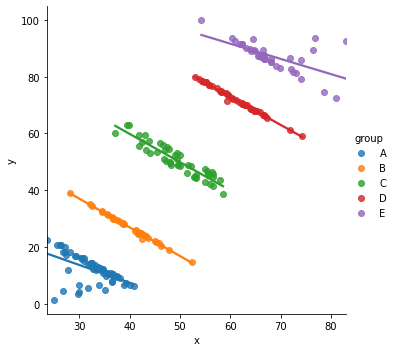
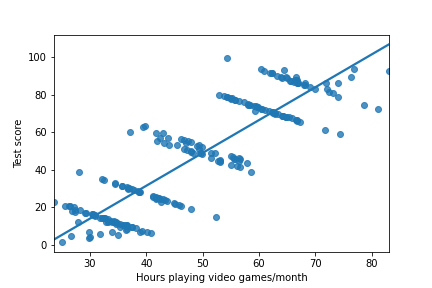
심슨의 역설은 전체 데이터셋에서의 모델 추세가 데이터셋의 하위 집합에서의 추세와 매우 다를 때 발생합니다.
trend = 기울기 계수
mdl_whole = ols("y ~ x",
                 data=simpsons_paradox).fit()

print(mdl_whole.params)
Intercept           -38.554
x                     1.751
mdl_by_group = ols("y ~ group + group:x + 0",
                   data = simpsons_paradox).fit()

print(mdl_by_group.params)
  groupA    groupB    groupC    groupD    groupE
 32.5051   67.3886   99.6333  132.3932  123.8242
groupA:x  groupB:x  groupC:x  groupD:x  groupE:x
 -0.6266   -1.0105   -0.9940   -0.9908   -0.5364
sns.regplot(x="x",
            y="y",
            data=simpsons_paradox,
            ci=None)
sns.lmplot(x="x",
           y="y",
           data=simpsons_paradox,
           hue="group",
           ci=None)
가능하면 데이터셋을 시각화하십시오.
최적의 모델은 일반적으로 정해져 있지 않습니다. 데이터와 해결하려는 질문에 따라 달라집니다.
모델링 전에 질문을 명확히 하십시오.