NMT 모델 학습

Keras로 배우는 Machine Translation

Thushan Ganegedara

Data Scientist and Author

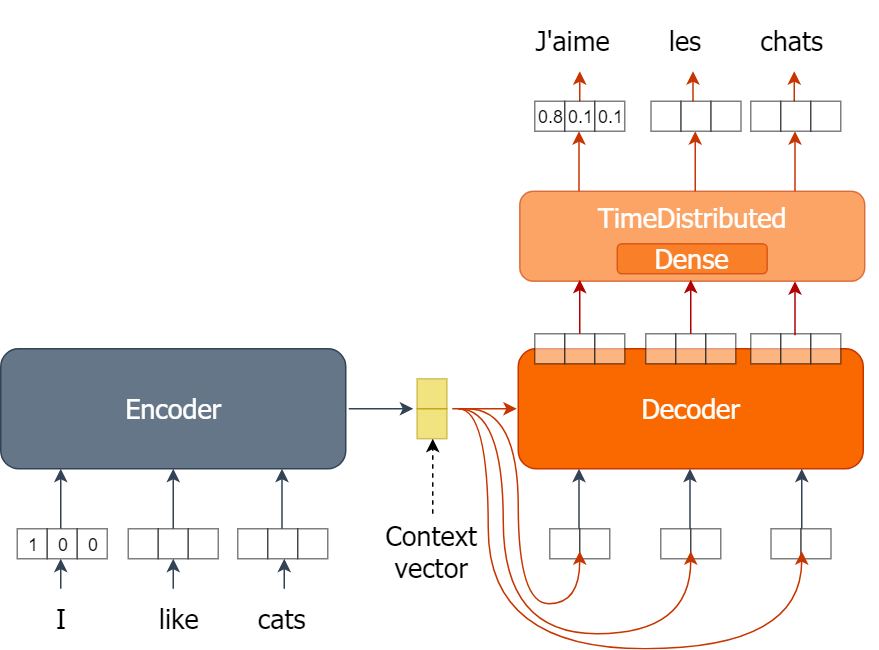
모델 다시 보기

  • 인코더 GRU
    • 영어 단어를 입력으로 받습니다
    • 컨텍스트 벡터를 출력합니다
  • 디코더 GRU
    • 컨텍스트 벡터를 입력으로 받습니다
    • GRU 출력 시퀀스를 생성합니다
  • 디코더 예측 층
    • GRU 출력 시퀀스를 입력으로 받습니다
    • 프랑스어 단어의 예측 확률을 출력합니다

Keras로 배우는 Machine Translation

파라미터 최적화

  • GRU 층과 Dense 층에는 파라미터가 있습니다
  • 보통 W(가중치)와 b(바이어스)로 표시됩니다(무작위 초기화)
  • 입력을 유용한 출력으로 변환합니다
  • 옵티마이저로 손실을 최소화하도록 시간이 지남에 따라 변경됩니다
    • 손실: 다음의 차이로 계산
      • 예측값(모델이 생성한 프랑스어 단어)
      • 실제값(실제 프랑스어 단어)
  • 모델 컴파일 시 지정합니다
nmt.compile(optimizer='adam', loss='categorical_crossentropy', metrics=['acc'])
Keras로 배우는 Machine Translation

모델 학습

  • 학습 반복
    for ei in range(n_epochs): # 데이터셋 한 번 순회
      for i in range(0,data_size,bsize): # 배치 하나 처리
    
  • 학습 배치 가져오기
      en_x = sents2seqs('source', en_text[i:i+bsize], onehot=True, reverse=True)
      de_y = sents2seqs('target', en_text[i:i+bsize], onehot=True)
    
  • 배치 단위 학습
      nmt.train_on_batch(en_x, de_y)
    
  • 모델 평가
      res = nmt.evaluate(en_x, de_y, batch_size=bsize, verbose=0)
    
Keras로 배우는 Machine Translation

모델 학습

  • 학습 손실과 정확도 확인
      res = nmt.evaluate(en_x, de_y, batch_size=bsize, verbose=0)
      print("Epoch {} => Train Loss:{}, Train Acc: {}".format(
        ei+1,res[0], res[1]*100.0))
    
Epoch 1 => Train Loss:4.8036723136901855, Train Acc: 5.215999856591225
...
Epoch 1 => Train Loss:4.718592643737793, Train Acc: 47.0880001783371
...
Epoch 5 => Train Loss:2.8161656856536865, Train Acc: 56.40000104904175
Epoch 5 => Train Loss:2.527724266052246, Train Acc: 54.368001222610474
Epoch 5 => Train Loss:2.2689621448516846, Train Acc: 54.57599759101868
Epoch 5 => Train Loss:1.9934935569763184, Train Acc: 56.51199817657471
Epoch 5 => Train Loss:1.7581449747085571, Train Acc: 55.184000730514526
Epoch 5 => Train Loss:1.5613118410110474, Train Acc: 55.11999726295471
Keras로 배우는 Machine Translation

과적합 방지

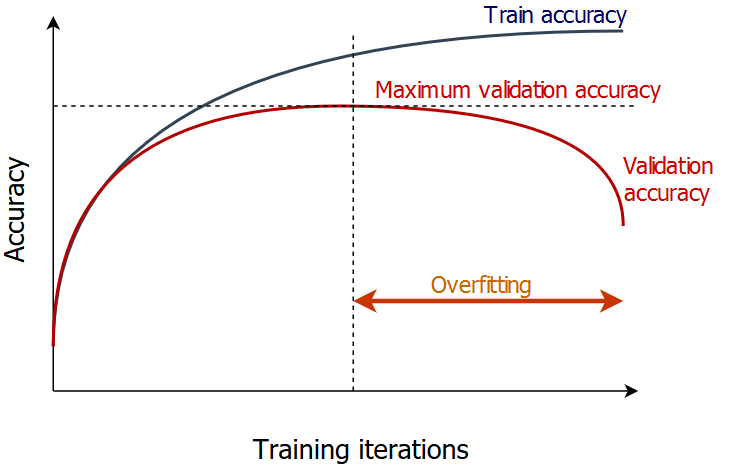
  • 데이터셋을 두 부분으로 분리합니다
    • 학습 세트 - 모델을 학습합니다
    • 검증 세트 - 모델 정확도를 모니터링합니다
  • 검증 정확도가 더 이상 증가하지 않으면 학습을 중단합니다.

과적합 지점

Keras로 배우는 Machine Translation

데이터셋 분할

  • 학습/검증 데이터셋 크기를 정의합니다

    train_size, valid_size = 800, 200
    
  • 데이터 인덱스를 무작위로 섞습니다

    inds = np.arange(len(en_text))
    np.random.shuffle(inds)
    
  • 학습/검증 인덱스를 얻습니다

    train_inds = inds[:train_size]
    valid_inds = inds[train_size:train_size+valid_size]
    
Keras로 배우는 Machine Translation

데이터셋 분할

  • 다음과 같이 데이터셋을 분리합니다:
    • 학습 인덱스의 데이터 → 학습 세트
    • 검증 인덱스의 데이터 → 검증 세트
tr_en = [en_text[ti] for ti in train_inds]
tr_fr = [fr_text[ti] for ti in train_inds]

v_en = [en_text[ti] for ti in valid_inds]
v_fr = [fr_text[ti] for ti in valid_inds]
Keras로 배우는 Machine Translation

검증과 함께 모델 학습

n_epochs, bsize = 5, 250
for ei in range(n_epochs):

for i in range(0,train_size,bsize): en_x = sents2seqs('source', tr_en[i:i+bsize], onehot=True, pad_type='pre') de_y = sents2seqs('target', tr_fr[i:i+bsize], onehot=True) nmt.train_on_batch(en_x, de_y)
v_en_x = sents2seqs('source', v_en, onehot=True, pad_type='pre') v_de_y = sents2seqs('target', v_fr, onehot=True)
res = nmt.evaluate(v_en_x, v_de_y, batch_size=valid_size, verbose=0) print("Epoch: {} => Loss:{}, Val Acc: {}".format(ei+1,res[0], res[1]*100.0))
Epoch 1 => Train Loss:4.8036723136901855, Train Acc: 5.215999856591225
Keras로 배우는 Machine Translation

Lass uns üben!

Keras로 배우는 Machine Translation

Preparing Video For Download...