메모리 모니터링 및 관리

R의 병렬 프로그래밍

Nabeel Imam

Data Scientist

대기열과 공간
은행에서 세 명의 창구 직원이 고객을 응대하고, 일부 고객은 차례를 기다리고 있습니다.

R의 병렬 프로그래밍

병렬 흐름

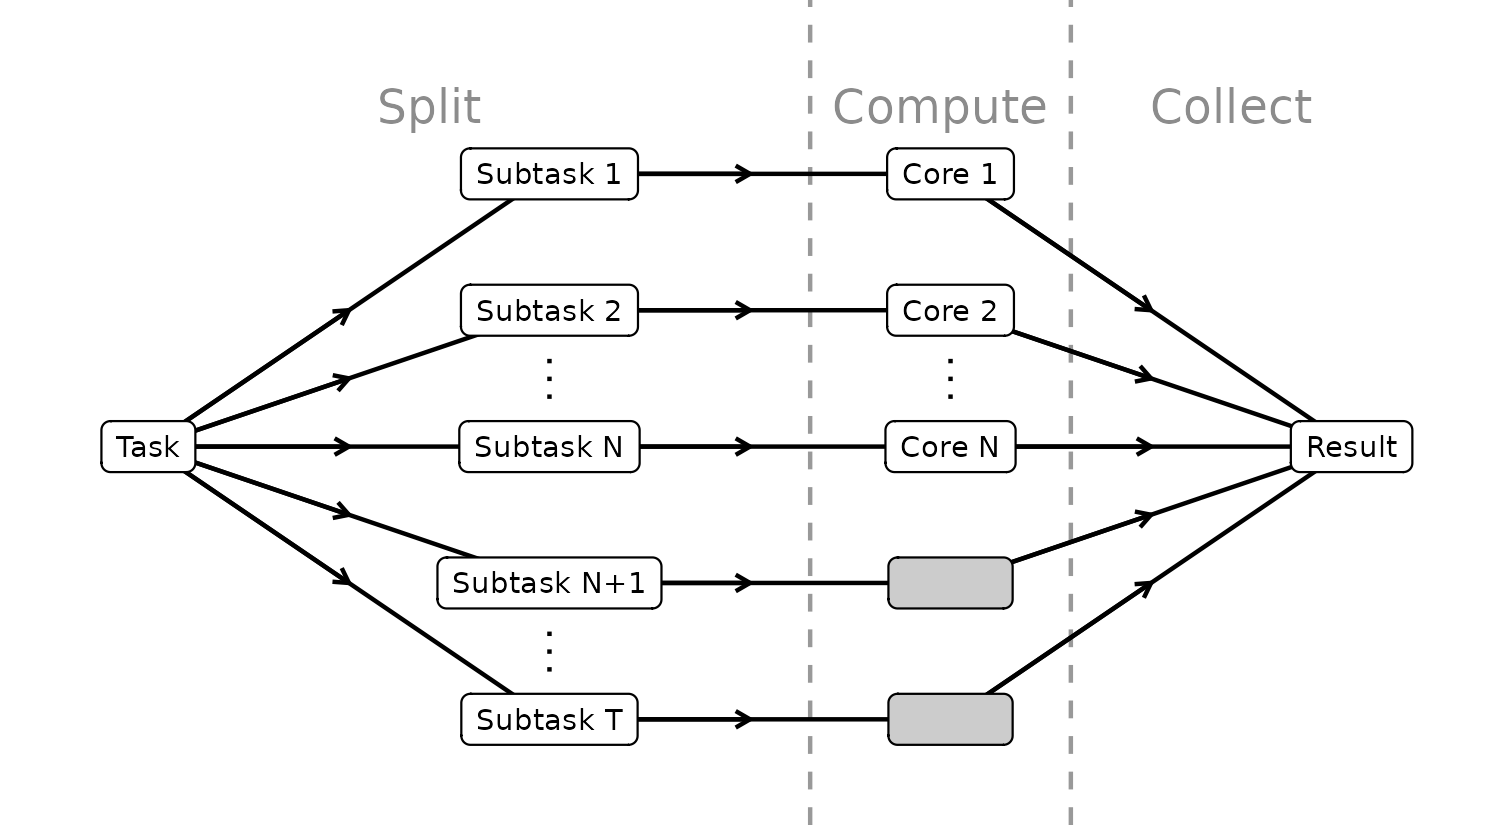
병렬 흐름이 표시되어 있습니다. 하나의 작업이 여러 개의 소작업으로 분할되고, 각 소작업은 서로 다른 코어에서 처리된 후 결과가 합쳐집니다.

R의 병렬 프로그래밍

병렬 흐름

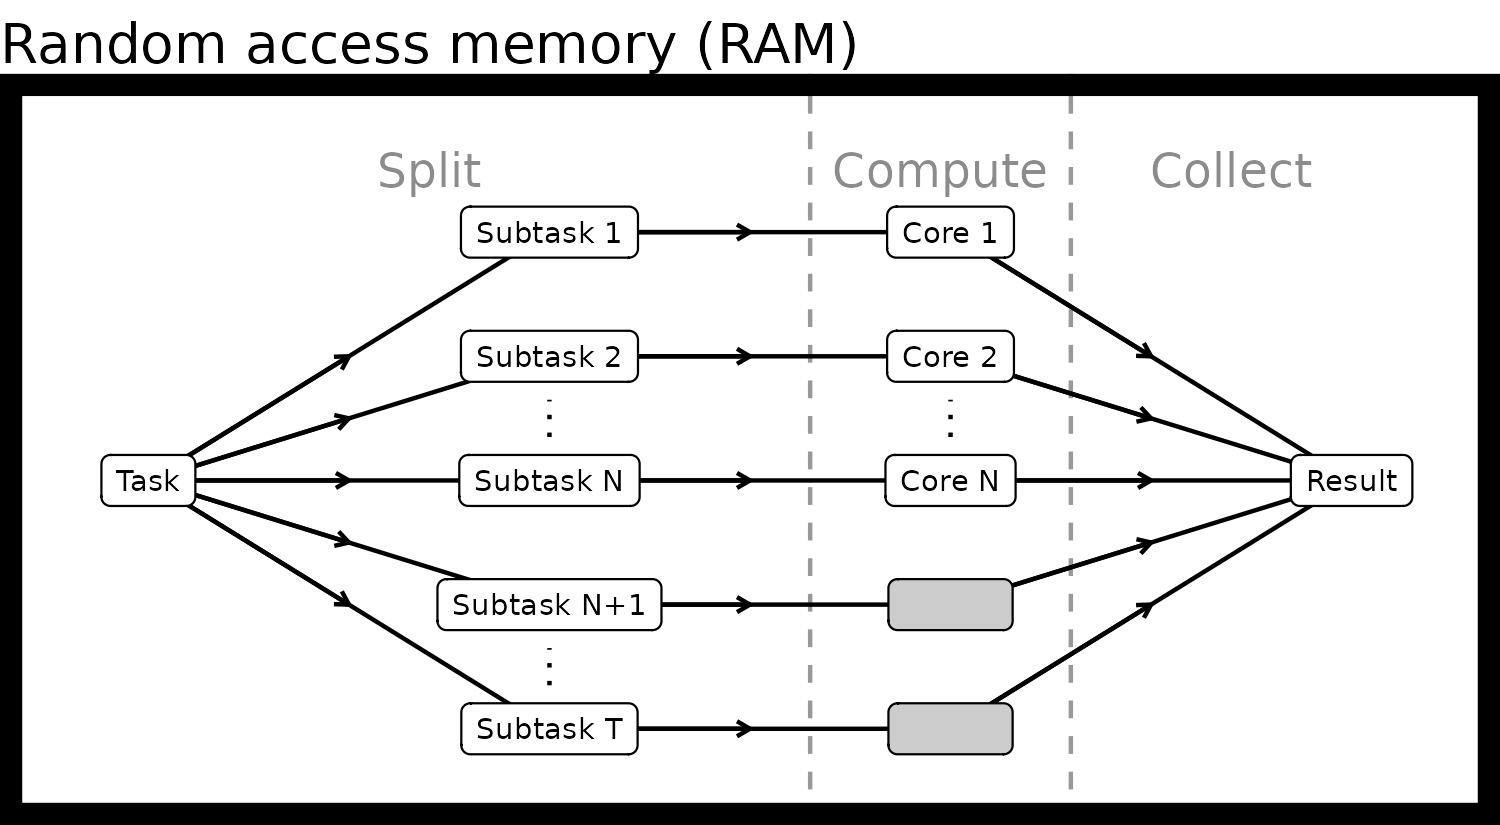
병렬 워크플로우는 RAM(랜덤 액세스 메모리) 내에서 실행됩니다.

R의 병렬 프로그래밍

출생 데이터

print(ls_files)
 [1] "./births/AK.csv"
 [2] "./births/AL.csv"
 [3] "./births/AR.csv"
 [4] "./births/AZ.csv"
 [5] "./births/CA.csv"
 [6] "./births/CO.csv"
 [7] "./births/CT.csv"
 [8] "./births/DC.csv"
 [9] "./births/DE.csv"
 [10] "./births/FL.csv"
...
R의 병렬 프로그래밍

futures로 매핑

plan(multisession, workers = 2)

ls_df <- future_map(ls_files, read.csv)
plan(sequential)
print(ls_df)
[[1]]
   state month plurality weight_gain_pounds mother_age
      AK     1         1                 30         43
   ...
[[2]]
   state month plurality weight_gain_pounds mother_age
      AL    10         1                 60         33
   ...
...
R의 병렬 프로그래밍

워커 2개로 프로파일링

profvis({
  plan(multisession, workers = 2)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

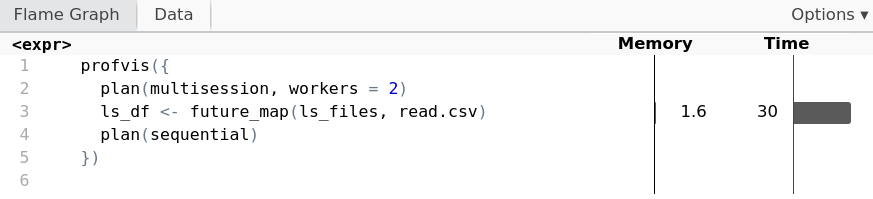
profvis 함수로 생성된 코드 프로파일링 결과. future_map을 사용하여 워커 2개로 CSV 파일을 병렬 읽기하면 1.6메가바이트의 메모리를 사용하며, 나머지 코드는 사용량이 나타나지 않습니다.

R의 병렬 프로그래밍

워커 4개로 프로파일링

profvis({
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv)
  plan(sequential)
})

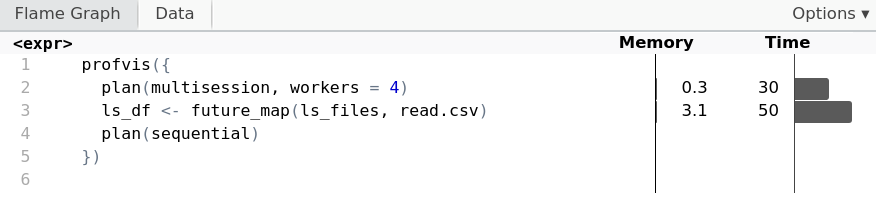
profvis 함수로 생성된 코드 프로파일링 결과. future_map을 사용하여 워커 4개로 CSV 파일을 병렬 읽기하면 3.1메가바이트의 메모리를 사용하며, 멀티세션 설정에는 0.3메가바이트가 사용됩니다.

R의 병렬 프로그래밍

내부 동작 원리

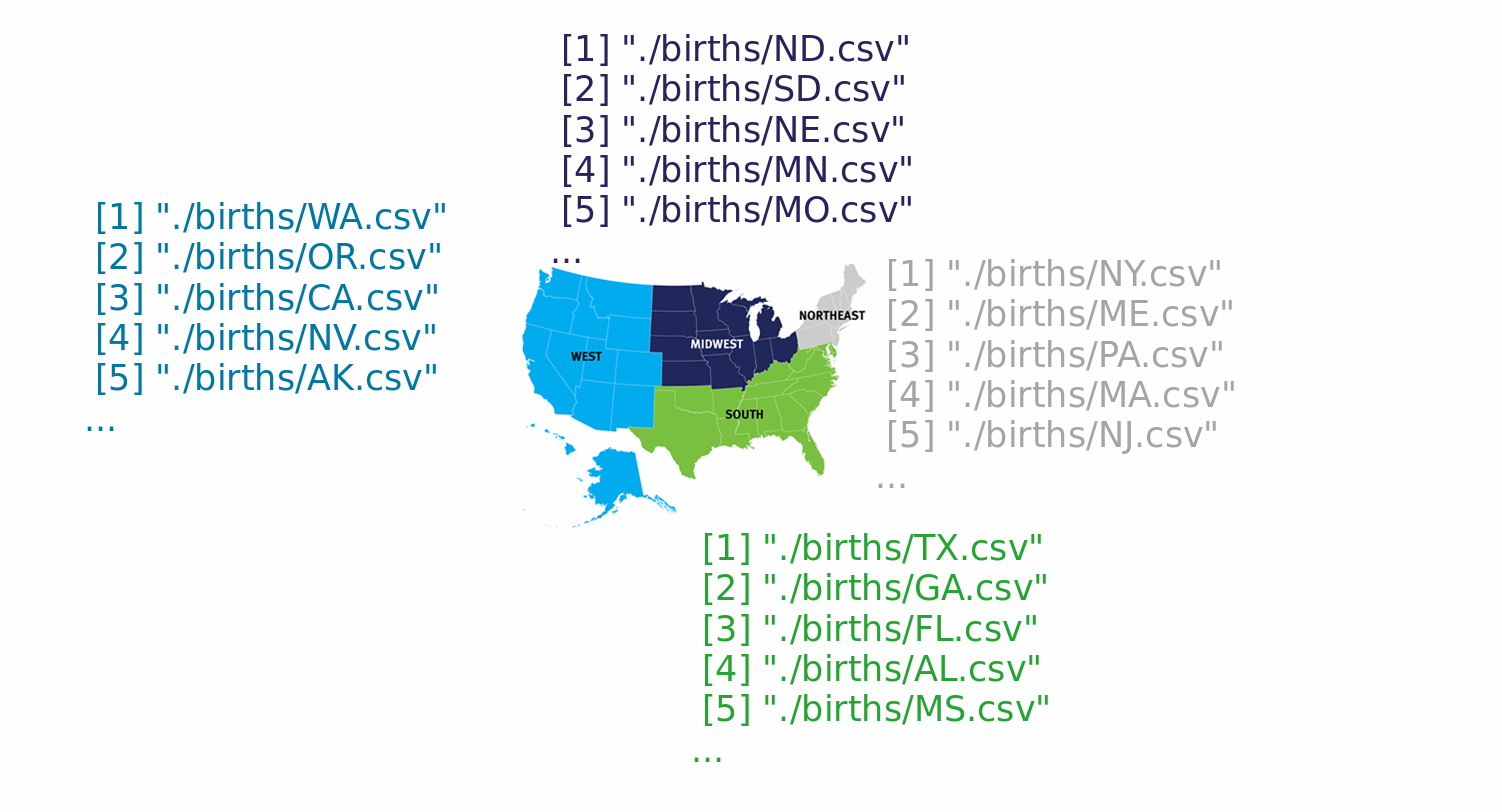
미국 지도로, 서부·중서부·남부·북동부의 4개 지역으로 구분되어 있습니다. 각 지역은 해당 지역 주(州) 데이터를 담은 CSV 파일 목록에 대응됩니다.

R의 병렬 프로그래밍

청킹으로 메모리 관리

config <- furrr_options(chunk_size = 26)

plan(multisession, workers = 4) ls_df <- future_map(ls_files, read.csv,
.options = config) plan(sequential)
R의 병렬 프로그래밍

청킹으로 메모리 관리

profvis({
  config <- furrr_options(chunk_size = 26)
  plan(multisession, workers = 4)
  ls_df <- future_map(ls_files, read.csv,
             .options = config)
  plan(sequential)
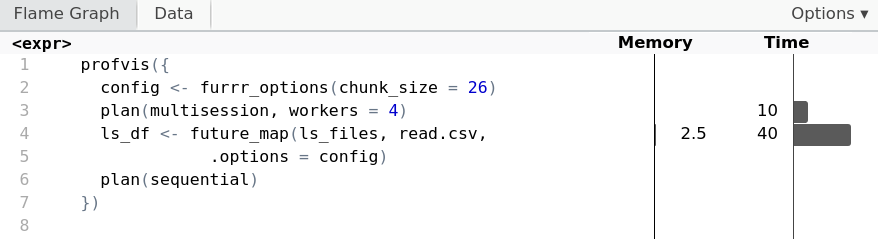
})

profvis 함수로 생성된 코드 프로파일링 결과. 청크 크기 26으로 워커 4개를 사용하여 CSV 파일을 병렬 읽기하면 2.5메가바이트의 메모리를 사용합니다.

R의 병렬 프로그래밍

parallel로 청킹

cl <- makeCluster(4)


ls_df <- parLapply(cl, ls_files, read.csv)
stopCluster(cl)

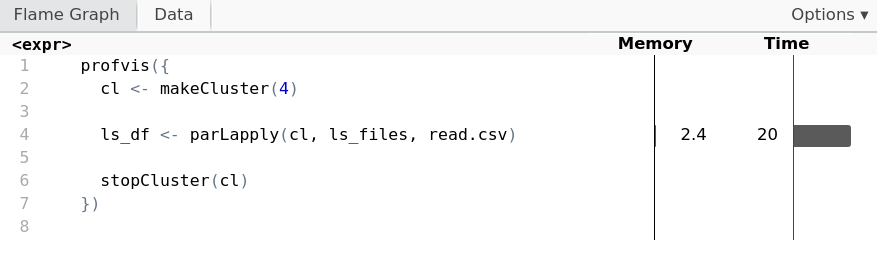
parLapply를 사용하여 CSV 파일을 병렬 읽기하면 2.4메가바이트의 메모리를 사용하며, 모든 메모리는 parLapply 호출 시 사용됩니다.

R의 병렬 프로그래밍

parallel로 청킹

cl <- makeCluster(4)
ls_df <- parLapply(cl, ls_files, read.csv,

chunk.size = 26)
stopCluster(cl)

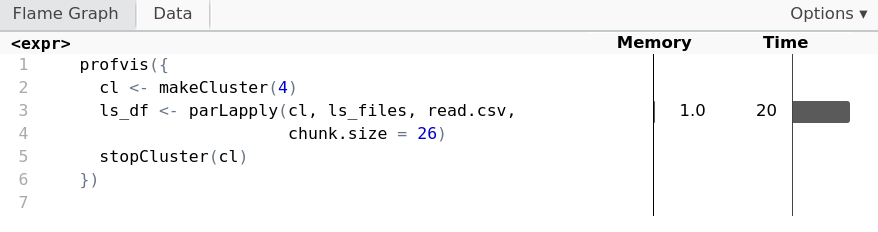
청크 크기를 26으로 설정하면 parLapply를 사용한 CSV 병렬 읽기 시 메모리 사용량이 1메가바이트에 불과합니다.

R의 병렬 프로그래밍

언제 청킹을 사용할까요?

  • 기본적으로 청킹은 최적으로 수행됩니다
  • 대용량 데이터 객체로 메모리가 부족할 경우
    • 가능하면 더 적은 코어 사용을 시도해 보세요
    • 몇 가지 청크 크기를 실험하여 최적값을 찾으세요
R의 병렬 프로그래밍

연습해 봅시다!

R의 병렬 프로그래밍

Preparing Video For Download...