一意性制約

Pythonによるデータクリーニング

Adel Nehme

VP of AI Curriculum, DataCamp

重複値とは何ですか?

すべての列の値は同じです

firstname lastname 住所 高さ 体重
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
Pythonによるデータクリーニング

重複値とは何ですか?

ほとんどの列で同じ値を持つ

名 姓 住所 身長 体重
Justin Saddlemyer Boulevard du Jardin Botanique 3, Bruxelles 193 cm 87 kg
Pythonによるデータクリーニング

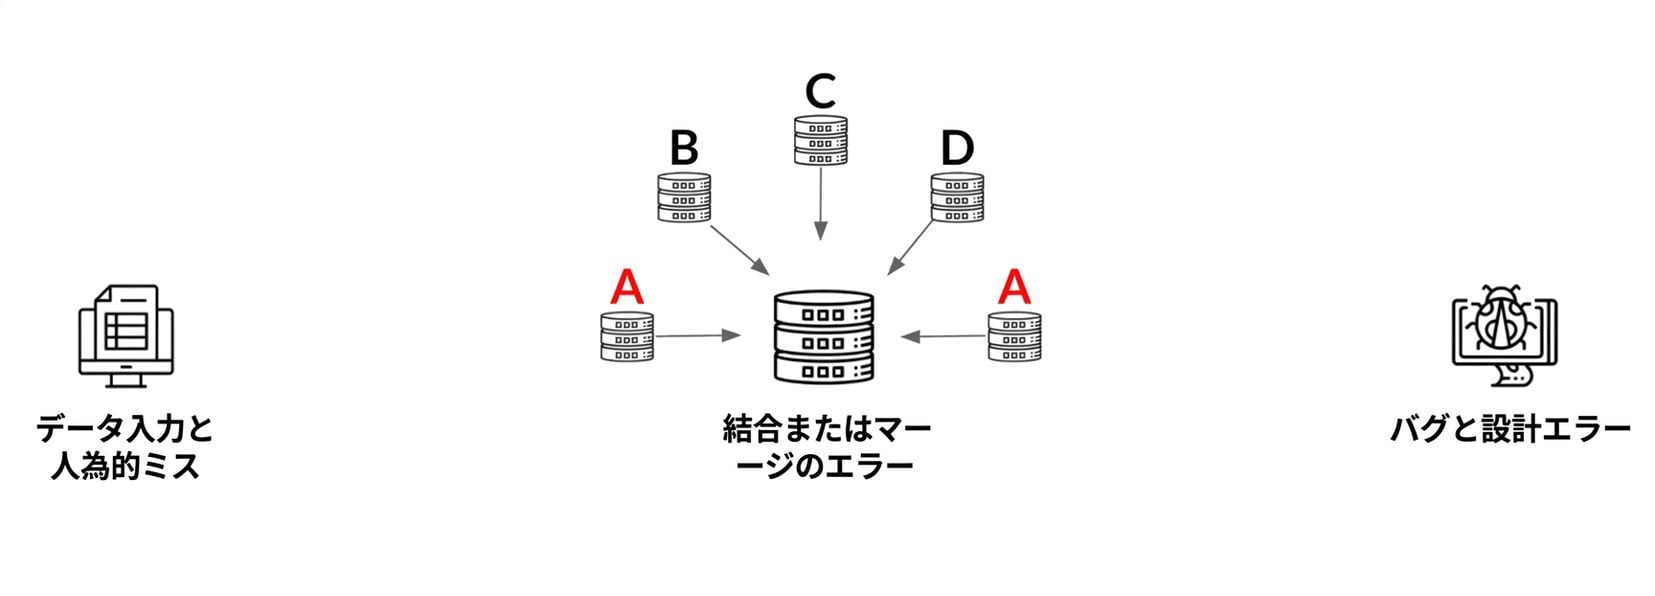
なぜ発生するのでしょうか?

duplicate_1

Pythonによるデータクリーニング

なぜ発生するのでしょうか?

duplicate_2

Pythonによるデータクリーニング

なぜ発生するのでしょうか?

duplicate_3

Pythonによるデータクリーニング

重複値を見つけるには?

# Print the header
height_weight.head()
  first_name last_name                       address  height  weight
0       Lane     Reese              534-1559 Nam St.     181      64
1       Ivor    Pierce             102-3364 Non Road     168      66
2      Roary    Gibson   P.O. Box 344, 7785 Nisi Ave     191      99
3    Shannon    Little  691-2550 Consectetuer Street     185      65
4      Abdul       Fry                4565 Risus St.     169      65
Pythonによるデータクリーニング

重複値を見つけるには?

# Get duplicates across all columns
duplicates = height_weight.duplicated()
print(duplicates)
1       False
...     ....
22      True
23      False
...     ...
Pythonによるデータクリーニング

重複値を見つけるには?

# Get duplicate rows
duplicates = height_weight.duplicated()
height_weight[duplicates]
    first_name last_name                               address  height  weight
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
Pythonによるデータクリーニング

重複行の見つけ方?

.duplicated() メソッド

subset: 重複をチェックすべき列名のリスト。

keep: 重複値を最初('first')、最後('last')、またはすべて(False)保持するかどうか。

# Column names to check for duplication
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
Pythonによるデータクリーニング

重複行の見つけ方?

# Output duplicate values
height_weight[duplicates]
    first_name last_name                               address  height  weight
1         Ivor    Pierce                     102-3364 Non Road     168      66
22        Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
101       Ivor    Pierce                     102-3364 Non Road     168      88
102       Cole    Palmer                       8366 At, Street     178      91
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
Pythonによるデータクリーニング

重複行の見つけ方?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
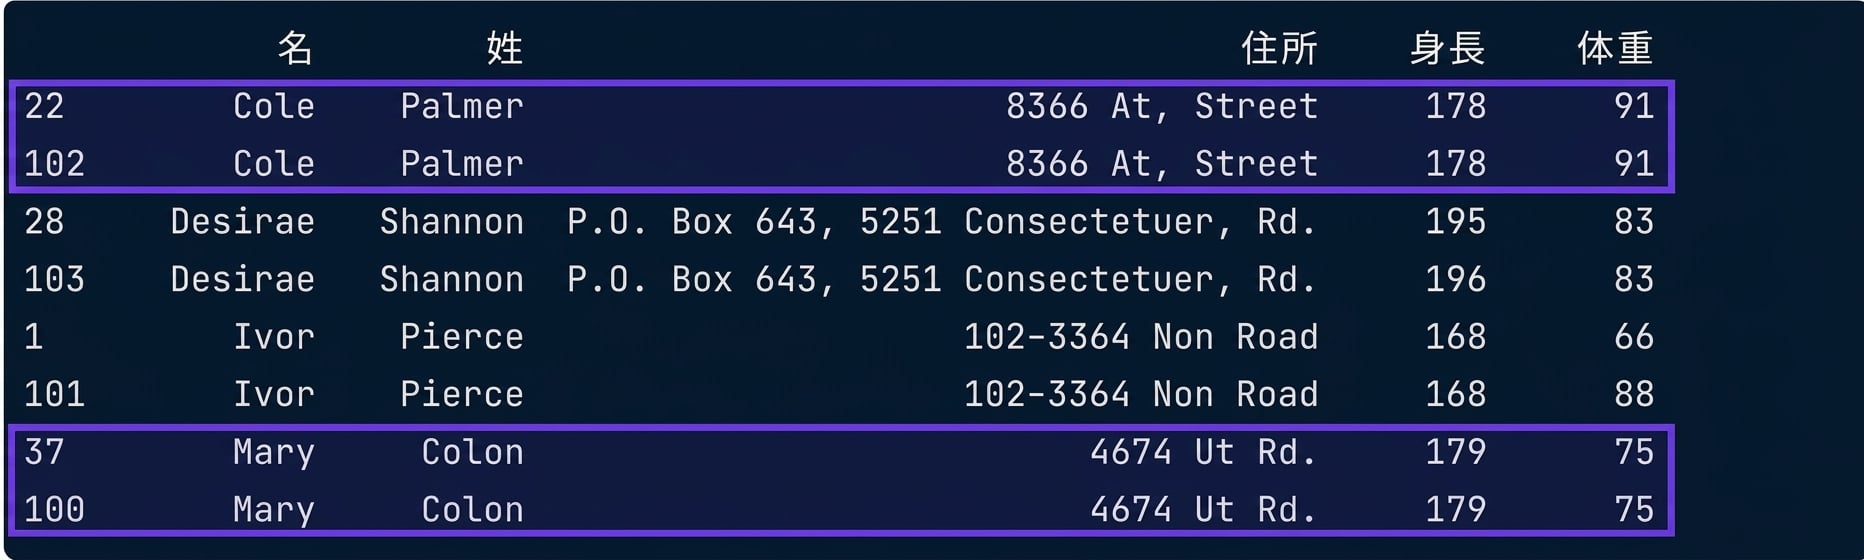
    first_name last_name                               address  height  weight
22        Cole    Palmer                       8366 At, Street     178      91
102       Cole    Palmer                       8366 At, Street     178      91
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
37        Mary     Colon                           4674 Ut Rd.     179      75
100       Mary     Colon                           4674 Ut Rd.     179      75
Pythonによるデータクリーニング

重複行の見つけ方?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')
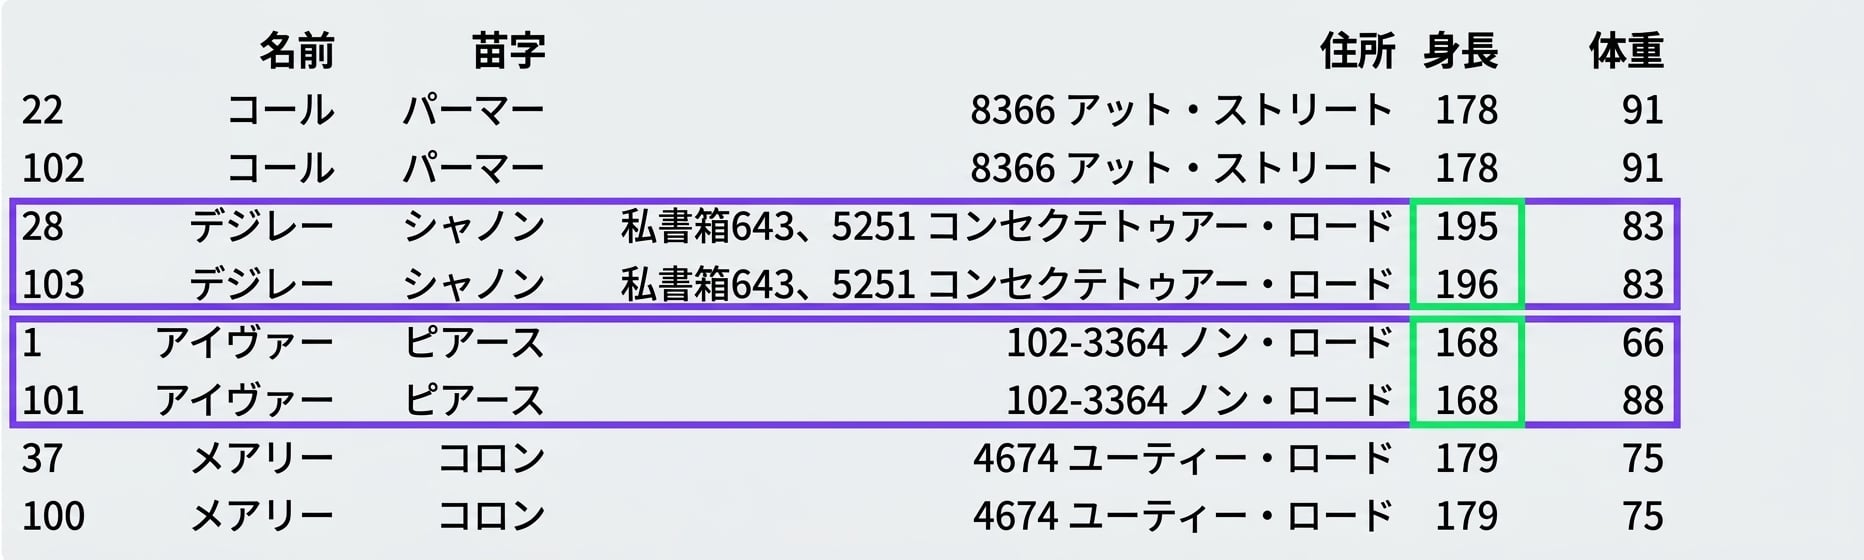
13完全な重複.png

Pythonによるデータクリーニング

重複行の見つけ方?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

13部分的な重複.png

Pythonによるデータクリーニング

重複値をどう扱うか?

# Output duplicate values
height_weight[duplicates].sort_values(by = 'first_name')

13完全な重複.png

Pythonによるデータクリーニング

重複値をどう扱うか?

.drop_duplicates() メソッド

subset: 重複をチェックすべき列名のリスト。

keep: 重複値を最初('first')、最後('last')、またはすべて(False)保持するかどうか。

inplace: DataFrame 内で重複行を直接削除し、新しいオブジェクトを作成せずに (True)。

# Drop duplicates
height_weight.drop_duplicates(inplace = True)
Pythonによるデータクリーニング

重複値をどう扱うか?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')
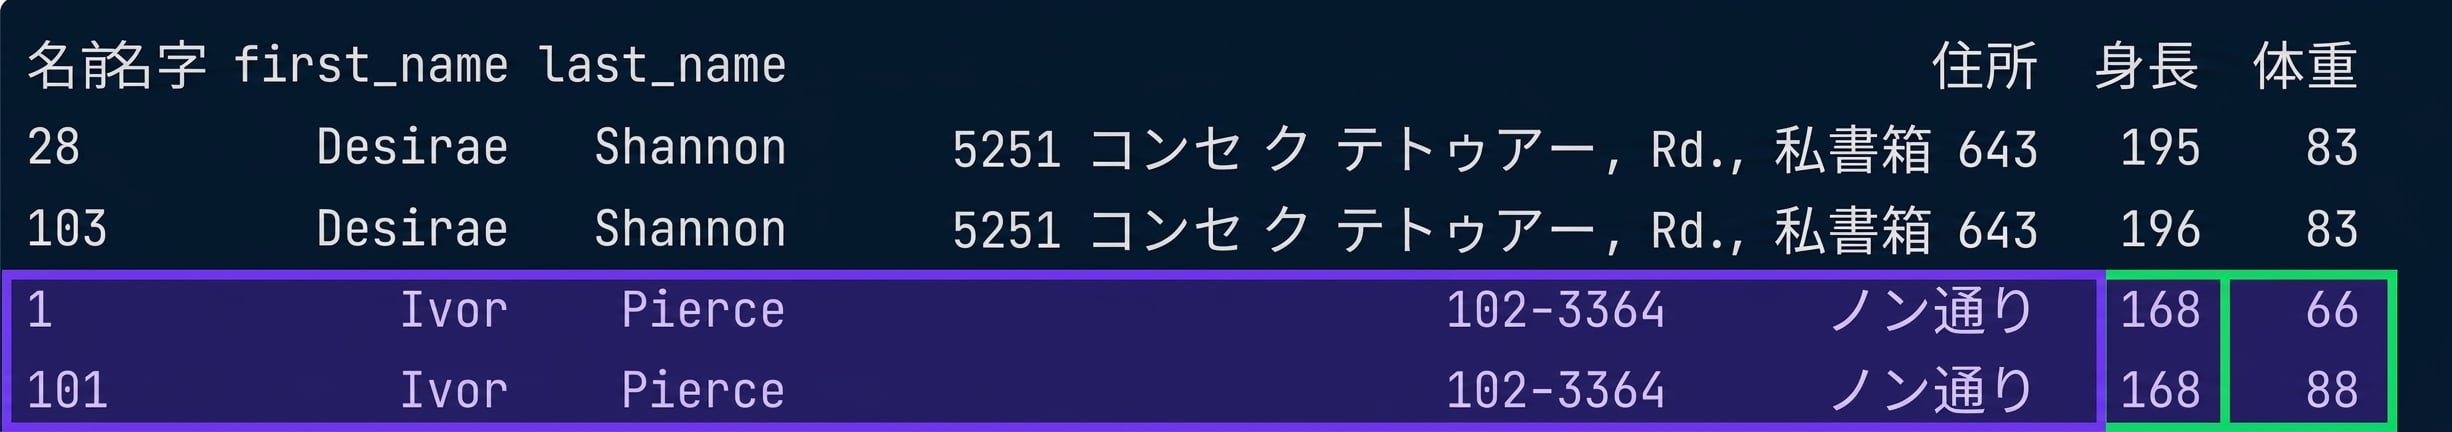
    first_name last_name                               address  height  weight
28     Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     195      83
103    Desirae   Shannon  P.O. Box 643, 5251 Consectetuer, Rd.     196      83
1         Ivor    Pierce                     102-3364 Non Road     168      66
101       Ivor    Pierce                     102-3364 Non Road     168      88
Pythonによるデータクリーニング

重複値をどう扱うか?

# Output duplicate values
column_names = ['first_name','last_name','address']
duplicates = height_weight.duplicated(subset = column_names, keep = False)
height_weight[duplicates].sort_values(by = 'first_name')

13重複の集約.png

Pythonによるデータクリーニング

重複値をどう扱うか?

.groupby()と.agg()の方法

# Group by column names and produce statistical summaries
column_names = ['first_name','last_name','address']
summaries = {'height': 'max', 'weight': 'mean'}
height_weight = height_weight.groupby(by = column_names).agg(summaries).reset_index()

# Make sure aggregation is done duplicates = height_weight.duplicated(subset = column_names, keep = False) height_weight[duplicates].sort_values(by = 'first_name')
first_name    last_name    address    height    weight

Pythonによるデータクリーニング

お疲れさまでした!

Pythonによるデータクリーニング

Preparing Video For Download...