微調整の準備

Python で学ぶ LLM の入門

Jasmin Ludolf

Senior Data Science Content Developer, DataCamp

パイプラインと自動クラス

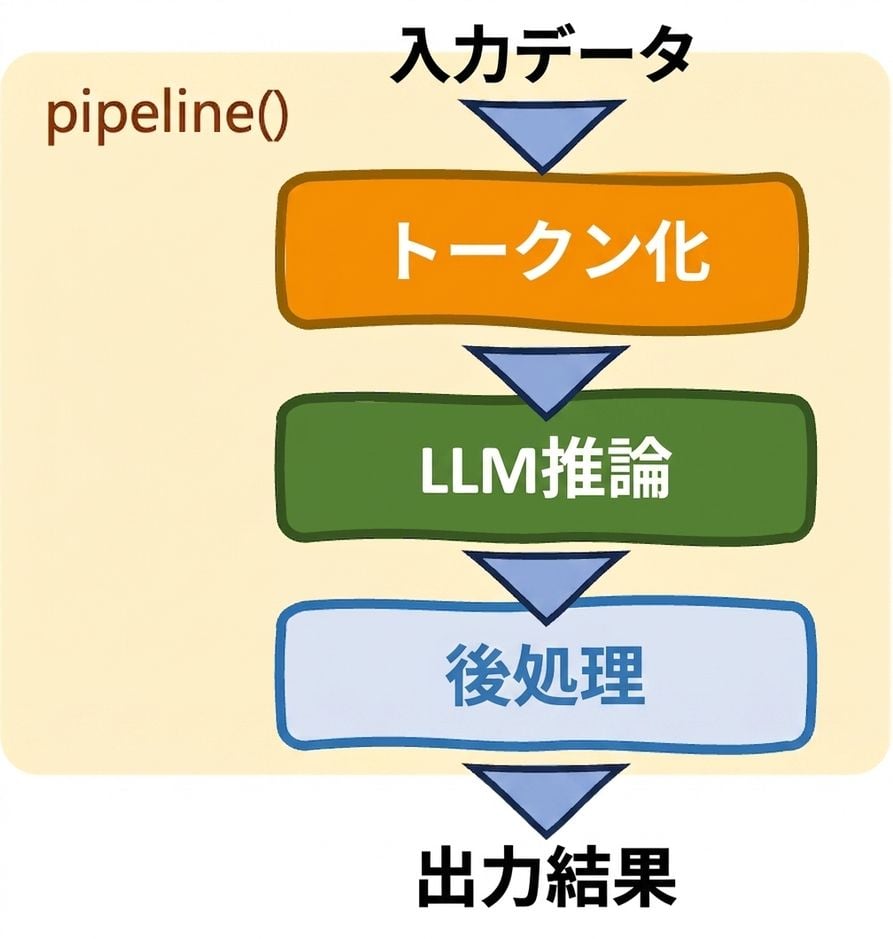
パイプライン: pipeline()

  • タスクを効率化します
  • モデルとトークナイザーの自動選択
  • 制御性が限られた

Hugging Face Transformersのパイプライン

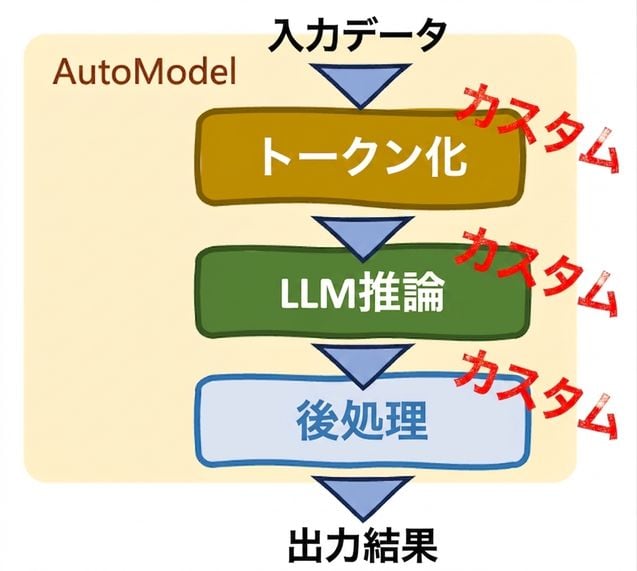
自動クラス (AutoModel クラス)

  • カスタマイズ
  • 手動調整
  • ファインチューニング{{8}}のサポート

Hugging Face TransformersのAutoModelクラスによるカスタマイズオプション

Python で学ぶ LLM の入門

LLMライフサイクル

LLMsライフサイクル

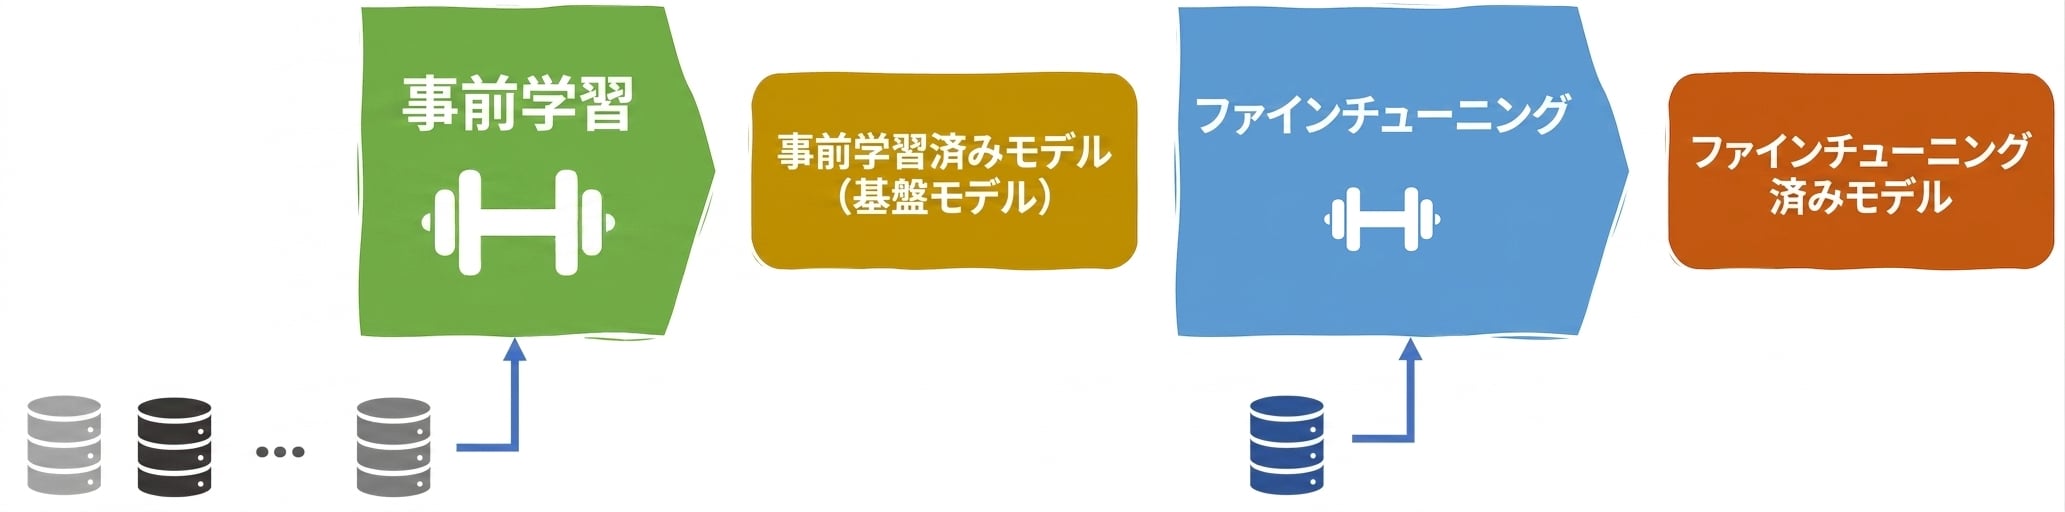
事前学習

  • 広範なデータ
  • 一般的なパターンを学習する
Python で学ぶ LLM の入門

LLMのライフサイクル

LLMsライフサイクル

事前訓練 微調整

  • 広範なデータ ドメイン固有
  • 一般的なパターン を学ぶ 専門的なタスク
Python で学ぶ LLM の入門

ファインチューニングのためのデータセットの読み込み

from datasets import load_dataset


train_data = load_dataset("imdb", split="train")
train_data = data.shard(num_shards=4, index=0)
test_data = load_dataset("imdb", split="test")
test_data = data.shard(num_shards=4, index=0)
  • load_dataset(): Hugging Face hubからデータセットを読み込む
    • imdb:レビュー分類
Python で学ぶ LLM の入門

オートクラス

from transformers import AutoModel, AutoTokenizer

from transformers import AutoModelForSequenceClassification
model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased") tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")
Python で学ぶ LLM の入門

トークン化

from transformers import AutoTokenizer, AutoModelForSequenceClassification
from datasets import load_dataset

train_data = load_dataset("imdb", split="train")
train_data = data.shard(num_shards=4, index=0)
test_data = load_dataset("imdb", split="test")
test_data = data.shard(num_shards=4, index=0)

model = AutoModelForSequenceClassification.from_pretrained("bert-base-uncased")
tokenizer = AutoTokenizer.from_pretrained("bert-base-uncased")


# Tokenize the data tokenized_training_data = tokenizer(train_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64) tokenized_test_data = tokenizer(test_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64)
Python で学ぶ LLM の入門

トークン化出力

print(tokenized_training_data)
{'input_ids': tensor([[  101,  1045, 12524,  1045,  2572,  8025,  1011,  3756,  
2013,  2026, 2678,  3573,  2138,  1997,  2035,  1996,  6704,  2008,  5129,  2009, 
2043,  2009, 2001,  2034,  2207,  1999,  3476,  1012,  1045,  2036, ...
Python で学ぶ LLM の入門

行ごとのトークン化

def tokenize_function(text_data):
    return tokenizer(text_data["text"], return_tensors="pt", padding=True, truncation=True, max_length=64)

# Tokenize in batches
tokenized_in_batches = train_data.map(tokenize_function, batched=True)

# Tokenize row by row tokenized_by_row = train_data.map(tokenize_function, batched=False)
Dataset({
    features: ['text', 'label', 'input_ids', 'token_type_ids', 'attention_mask'],
    num_rows: 1563
})
Python で学ぶ LLM の入門

部分語トークン化

  • 現代のトークナイザーにおいて一般的
  • 単語を意味のある部分に分割

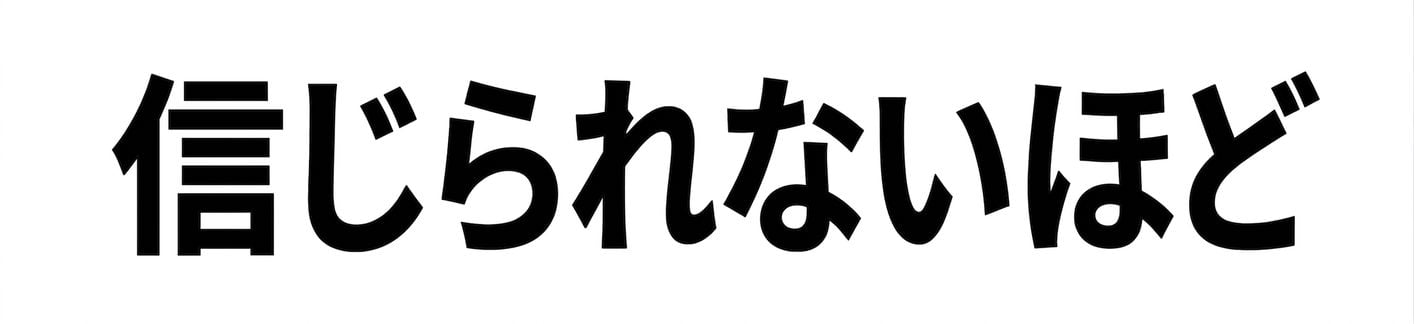
信じられないほど

Python で学ぶ LLM の入門

部分語トークン化

  • 現代のトークナイザーで一般的
  • 単語を意味のあるサブパートに分割

信じられないほど、「un」「believ」「ably」と分割されています。

Python で学ぶ LLM の入門

練習しましょう!

Python で学ぶ LLM の入門

Preparing Video For Download...