PCAを使った次元削減

Pythonで学ぶ教師なし学習

Benjamin Wilson

Director of Research at lateral.io

次元削減

  • 重要な特徴量だけ残して、同じデータを表現
  • 機械学習パイプラインの重要な部分
  • PCAを使用して実行可能
Pythonで学ぶ教師なし学習

PCAを使った次元削減

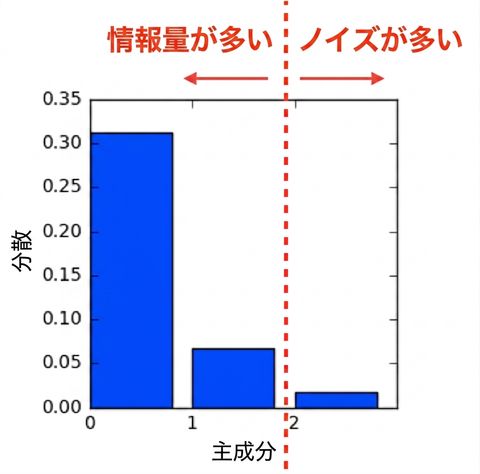
  • PCAの特徴量は分散が大きい順に並んでいる
  • 分散が小さい特徴量を「ノイズ」とみなす
  • 分散が大きい特徴量を重要な情報とみなす

pca特徴番号と分散の棒グラフ。1と2の間に縦線、左矢印は「情報量が多い」、右矢印は「ノイズが多い」とラベル付け

Pythonで学ぶ教師なし学習

PCAを使った次元削減

  • 残す特徴数を指定する
  • 例:PCA(n_components=2)
  • 最初の2つのPCA特徴量が残される
  • 内在次元が良い目安
Pythonで学ぶ教師なし学習

アヤメデータセットの次元削減

  • samples = アヤメの測定値の配列(4つの特徴量)
  • species = アイリスの品種番号リスト
from sklearn.decomposition import PCA

pca = PCA(n_components=2)
pca.fit(samples)
PCA(n_components=2)
transformed = pca.transform(samples)
print(transformed.shape)
(150, 2)
Pythonで学ぶ教師なし学習

2次元のアヤメデータセット

  • PCAは次元を2に削減
  • 分散が最も大きい2つのPCA特徴量を残す
  • 重要な情報だけを保持:品種をしっかりと区別できる
import matplotlib.pyplot as plt
xs = transformed[:,0]
ys = transformed[:,1]
plt.scatter(xs, ys, c=species)
plt.show()
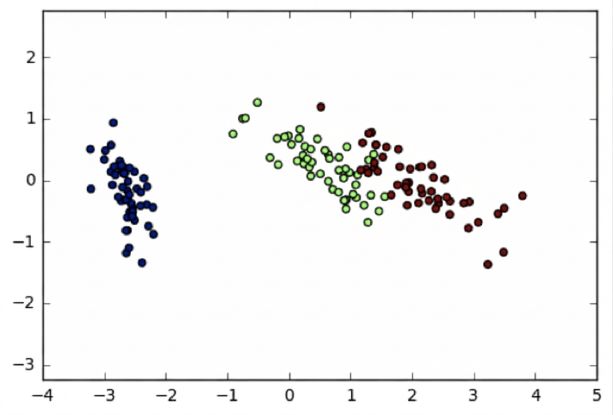
アヤメデータセットに対してPCAを実施した散布図

Pythonで学ぶ教師なし学習

PCAを使った次元削減

  • 分散が小さいPCA特徴量を除外
  • 分散が大きい特徴量が重要な情報と仮定する
  • この仮定は多くの場合、機能する(例:アヤメのケース)
Pythonで学ぶ教師なし学習

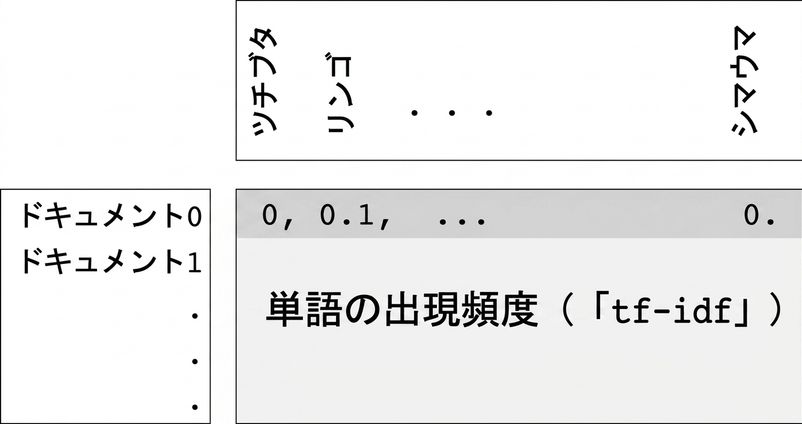
単語出現頻度の配列

  • 行はドキュメント、列は単語
  • 各ドキュメント内の各単語の出現回数を測定
  • 「tf-idf」を使って測定(詳細は後ほど)

単語出現頻度の配列

Pythonで学ぶ教師なし学習

疎行列(csr_matrix)

  • 「疎(スパース)」:ほとんどの要素がゼロ
  • NumPy配列の代わりにscipy.sparse.csr_matrix(疎行列)を使用可能
  • csr_matrixはゼロでない項目のみを記録(メモリの節約)

単語出現頻度の配列

Pythonで学ぶ教師なし学習

TruncatedSVDとcsr_matrix

  • scikit-learnのPCAcsr_matrixに対応していない
  • 代わりにscikit-learnのTruncatedSVDを使用
  • 同じ変換を行う
from sklearn.decomposition import TruncatedSVD
model = TruncatedSVD(n_components=3)
model.fit(documents)  # documents is csr_matrix
transformed = model.transform(documents)
Pythonで学ぶ教師なし学習

練習しましょう!

Pythonで学ぶ教師なし学習

Preparing Video For Download...